Блог про веброзробку та програмування

Корисні статті про Java, Spring, SEO, фронтенд та сучасні технології. Поради, приклади, лайфхаки для розробників

Пошук:

Переглянути
Квантування GGUF для Ollama: що означають Q4_K_M,  Q8_0 та IQ4_XS  яке вибрати під своє залізо

Квантування GGUF для Ollama: що означають Q4_K_M, Q8_0 та IQ4_XS яке вибрати під своє залізо

Якщо ви запускаєте моделі через Ollama або інші локальні рантайми, ви вже стикалися з назвами на кшталт Q4_K_M, Q8_0 або IQ4_XS. Що це означає? Яке обрати? Чому Q4 часто краще за Q8 — і коли це не так? У цій статті я розбираю квантування без зайвого теоретизування — з таблицями,...
Ваш AI-бот — амнезик. Щоразу коли контекст закінчується, він забуває хто ви. Ось як я це виправив

Ваш AI-бот — амнезик. Щоразу коли контекст закінчується, він забуває хто ви. Ось як я це виправив

Коли будуєш AI-чат, перша проблема яка тебе зустрічає — модель не має пам'яті між запитами. Кожне повідомлення для неї — це все що існує. Вирішити це не так просто як здається. Чому AI не пам'ятає вас — і це не баг Передавати всю історію — можна. Але ви за це...

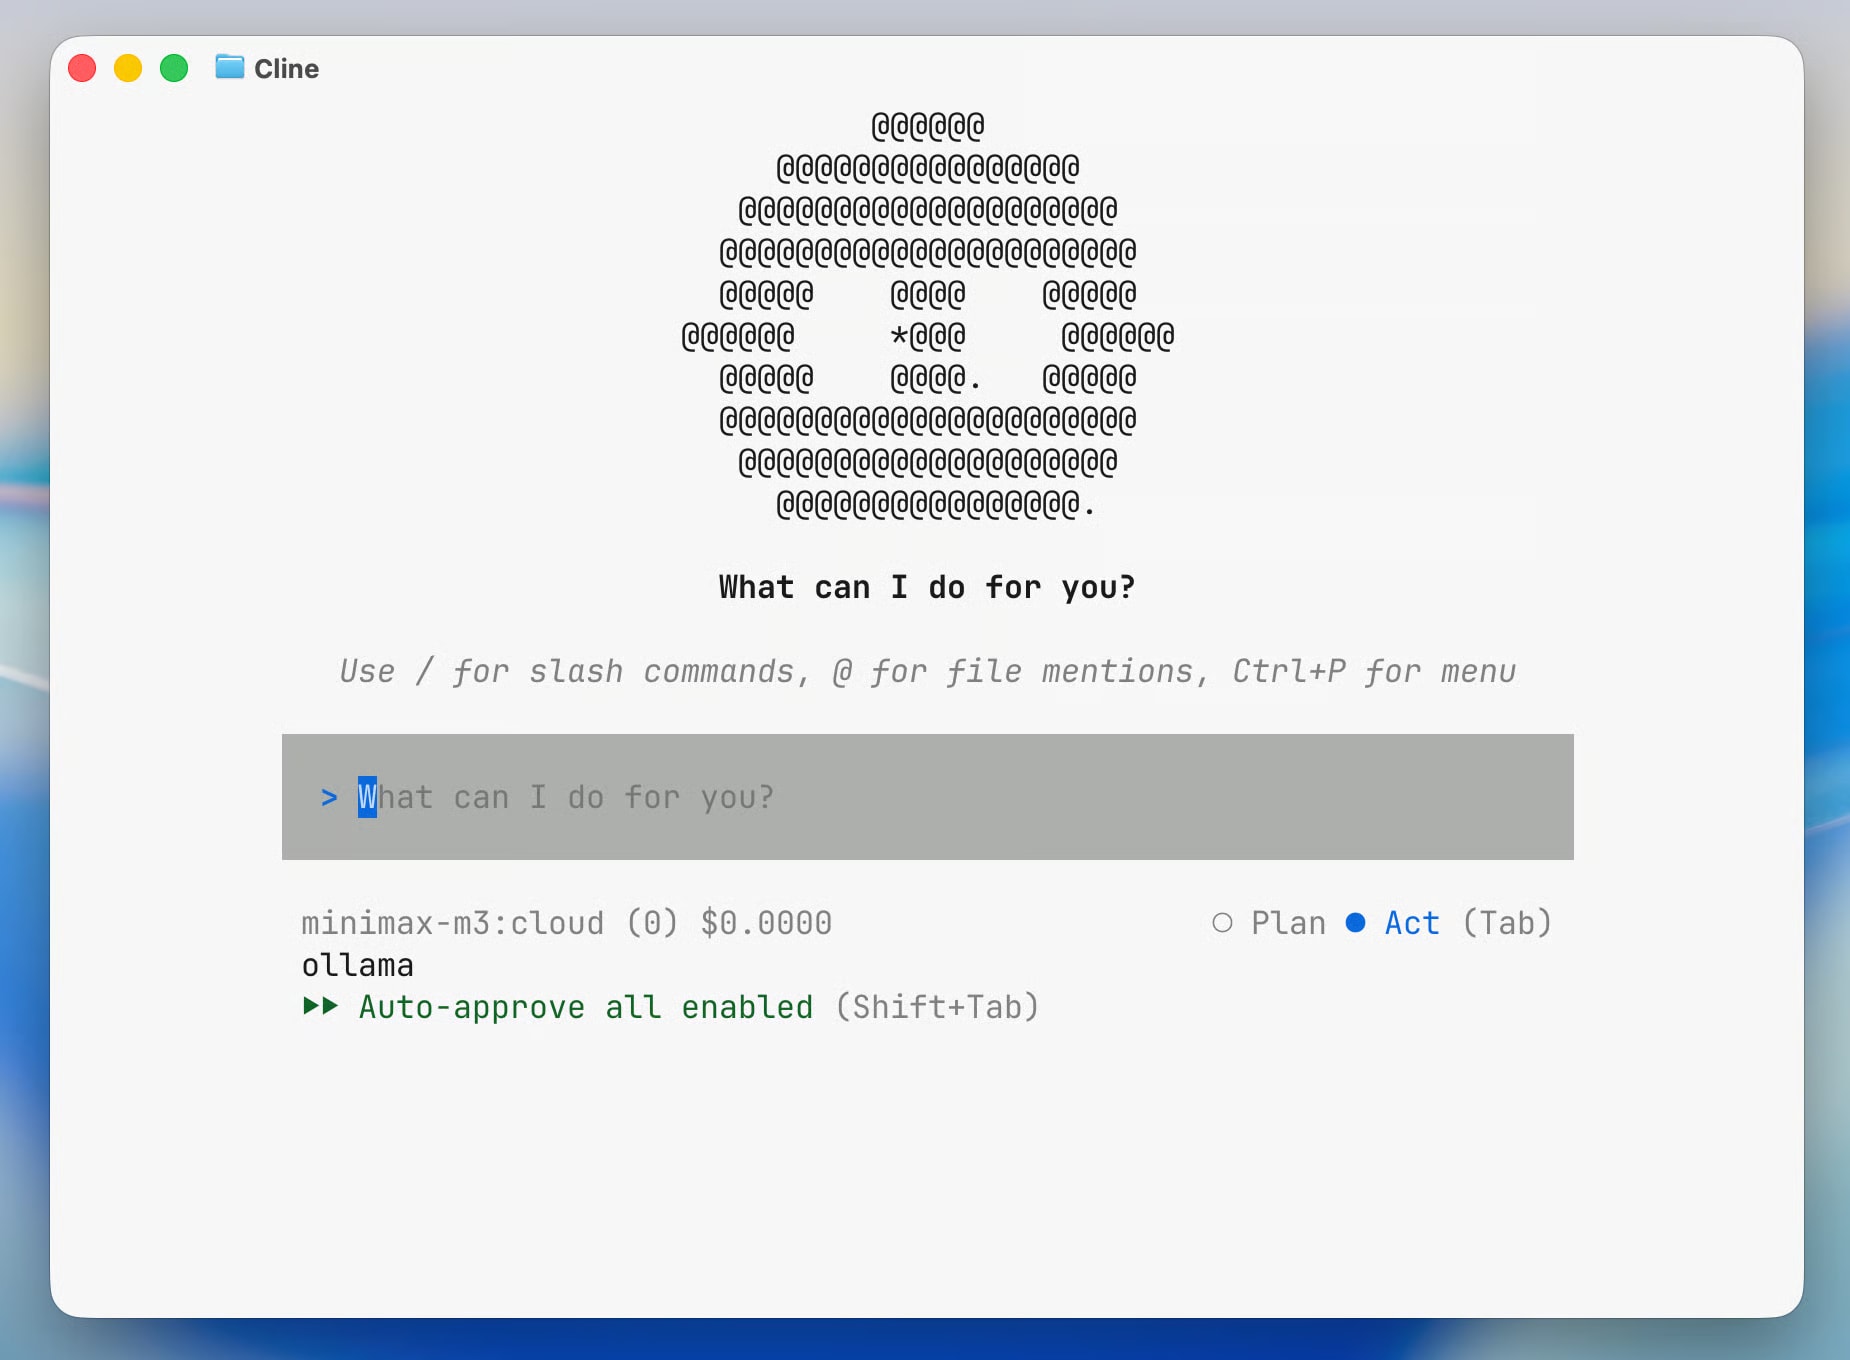
Як встановити Cline через Ollama: покрокова інструкція та типові помилки

Як встановити Cline через Ollama: покрокова інструкція та типові помилки

⚡ TL;DR Для запуску Cline через Ollama потрібні: Ollama актуальної версії та Node.js ≥ 22 Найпоширеніша помилка — стара версія Node.js (21.x замість 22+) або неправильний PATH після Homebrew EACCES-помилка вирішується оновленням Node через Homebrew і коректним налаштуванням...

Ollama Launch Cline: локальний AI-агент для програмування без хмари

Ollama Launch Cline: локальний AI-агент для програмування без хмари

⚡ TL;DR Ollama анонсувала команду ollama launch — запуск AI-агентів одним рядком у терміналі (офіційний анонс) Перший підтримуваний агент — Cline: читає файли, виконує команди в терміналі, робить git-операції автономно Підтримуються локальні моделі (qwen3.6, gemma4) і...

Google представила DiffusionGemma: перша відкрита diffusion-модель для генерації тексту

Google представила DiffusionGemma: перша відкрита diffusion-модель для генерації тексту

Коротко 10 червня 2026 року Google DeepMind випустила DiffusionGemma — відкриту модель на 26B параметрів (3.8B активних), яка генерує текст через diffusion замість стандартного autoregressive-підходу. Швидкість: 1000+ токенів на секунду на NVIDIA H100, 700+ на RTX 5090....

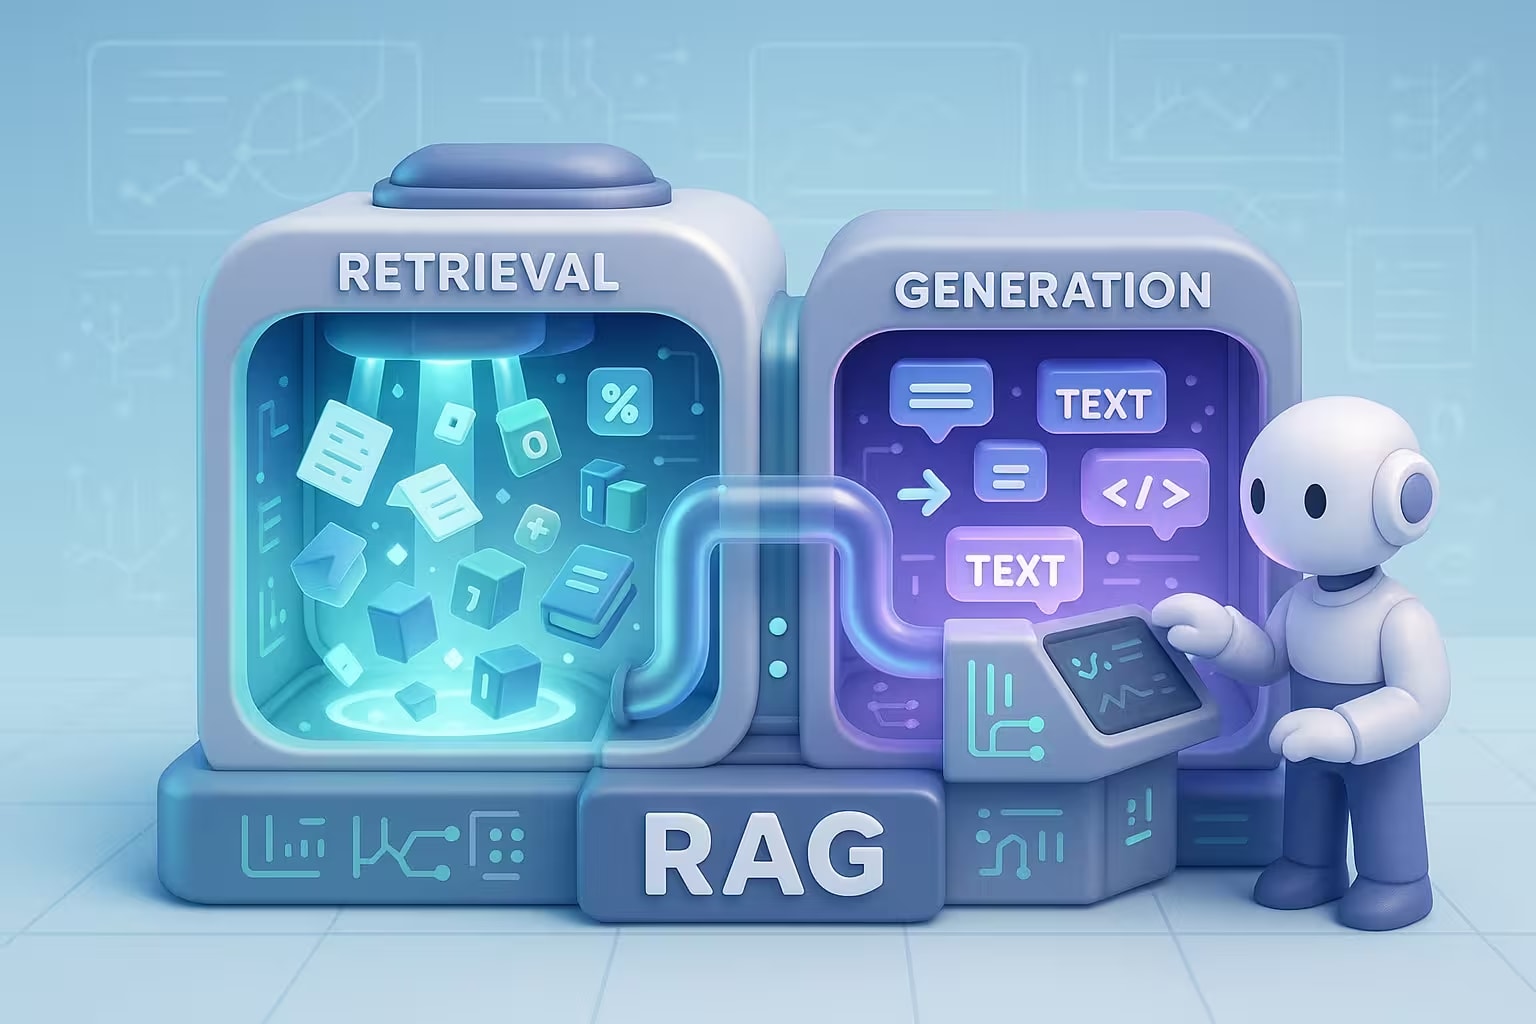
Найкращі open-source інструменти для RAG-систем

Найкращі open-source інструменти для RAG-систем

Більшість оглядів RAG-інструментів — це каталоги. Списки з назвами, зірочками на GitHub і рядком «підходить для різних задач». Вони не відповідають на головне запитання: що саме вибрати мені, під мою задачу, з моїми обмеженнями? Я спеціально побудував цю статтю інакше, ніж більшість оглядів....

Claude Fable 5: чому Anthropic випустила модель, яку місяцями вважали надто небезпечною

Claude Fable 5: чому Anthropic випустила модель, яку місяцями вважали надто небезпечною

Коротко: 9 червня 2026 року Anthropic випустила Claude Fable 5 — першу публічну модель класу Mythos, яку раніше обмежували через ризики у кібербезпеці. Та сама технологічна база, що і в Mythos 5, але з активними класифікаторами безпеки. Ціна: $10 / $50 за млн токенів. Бенчмарки: 80,3% SWE-Bench...

1536 vs 3072 embeddings: порівняння для пошуку по документах та RAG

1536 vs 3072 embeddings: порівняння для пошуку по документах та RAG

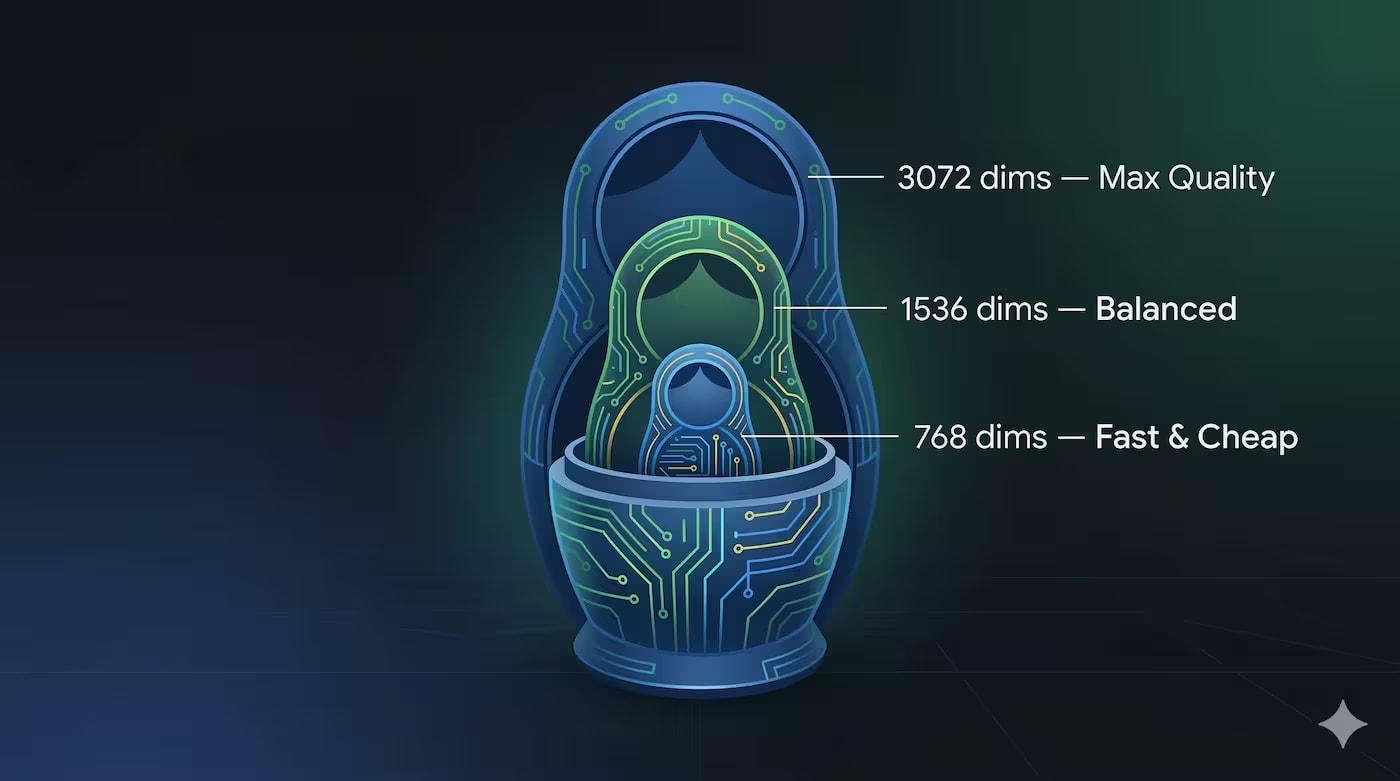
Коротко Подвоєння розмірності (1536 → 3072) подвоює RAM, storage і latency, але дає лише ~3–5% приросту MTEB Retrieval score у OpenAI моделей. На фінансових документах BM25 перевершує text-embedding-3-large за Precision@5. Lexical search все ще важливий. Hybrid...

Vision RAG vs OCR 2026: який підхід краще для роботи з документами

Vision RAG vs OCR 2026: який підхід краще для роботи з документами

Коротка відповідь OCR-first дешевший і швидший для текстових PDF, договорів, FAQ та технічної документації. Vision-first краще працює з таблицями, схемами, презентаціями, рукописним текстом і складною версткою. VisRAG (ICLR 2025) демонструє помітний приріст якості retrieval...

Як OCR впливає на якість RAG-систем: технічний розбір

Як OCR впливає на якість RAG-систем: технічний розбір

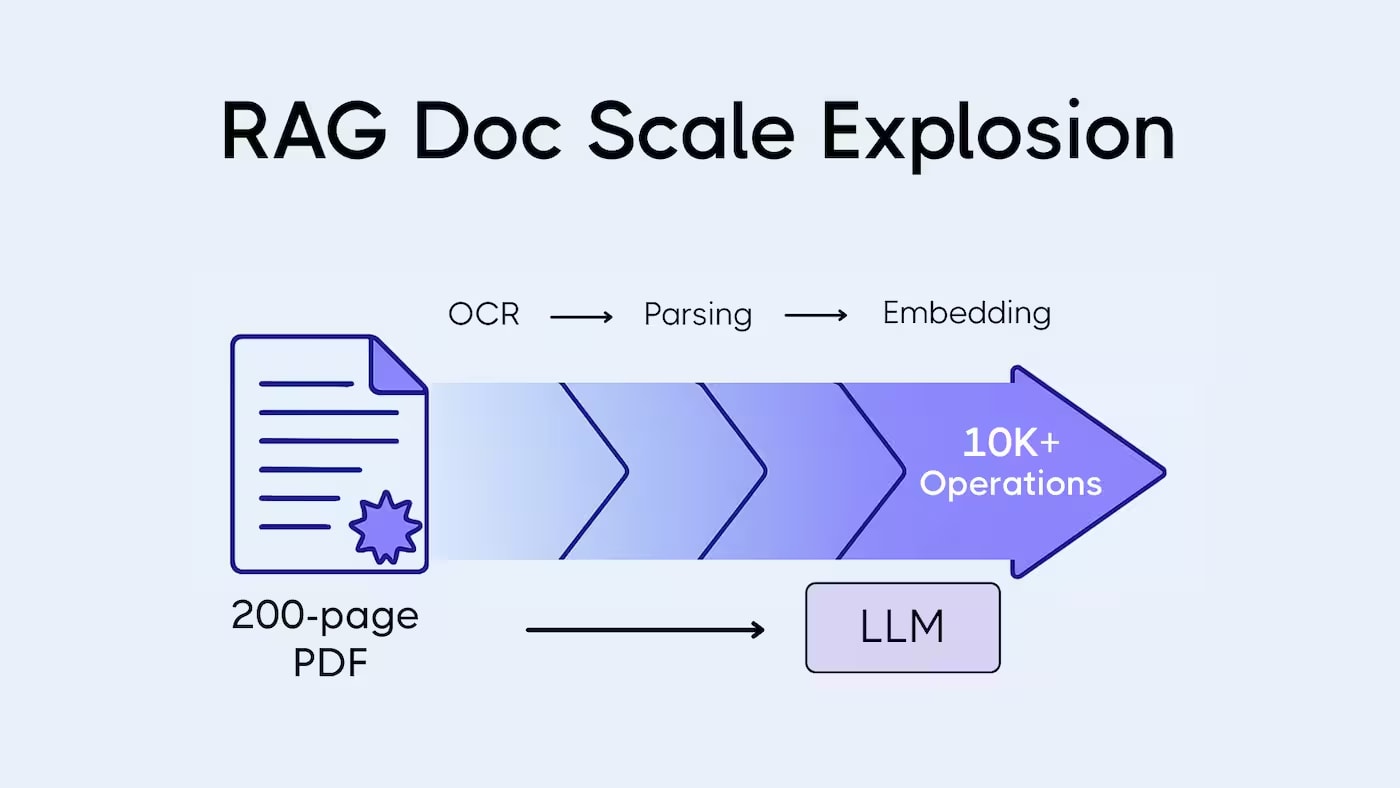
Коротко OCR-помилки не просто псують текст — вони каскадно руйнують кожен наступний крок пайплайну: chunking, embeddings, retrieval. Навіть 2% CER на 100-сторінковому документі — це ~1 000 спотворених символів, що потрапляють у векторну базу. Семантично...

Як запускати GGUF-моделі з Hugging Face в Ollama

Як запускати GGUF-моделі з Hugging Face в Ollama

В огляді Ollama 0.30 я показав базову механіку запуску GGUF у три кроки і пообіцяв окремий розбір з усіма нюансами. Ось він. Тут — повний практичний гайд: де брати GGUF-файл, як правильно написати Modelfile, які команди виконати, як перевірити підтримку tool calling і що робити, коли модель...

Ollama 0.30: що нового — GGUF, Vulkan, llama.cpp і tool calling

Ollama 0.30: що нового — GGUF, Vulkan, llama.cpp і tool calling

Ollama 0.30 вийшов з підтримкою GGUF-моделей з Hugging Face, прискоренням на NVIDIA та Vulkan, який тепер активний за замовчуванням. Це оновлення цікаве не окремими цифрами, а тим, що Ollama дедалі тісніше зростається з llama.cpp — і це впливає на те, які моделі ти зможеш запустити...

OCR у сучасних AI-системах: від сканованих документів до RAG

OCR у сучасних AI-системах: від сканованих документів до RAG

Коротко OCR визначає верхню межу якості RAG-системи. Помилки OCR поширюються в embeddings, retrieval і фінальну відповідь. Навіть ідеальна LLM не компенсує поганий ingestion. Для production важливіше OCR + chunking, ніж вибір моделі. Зміст Що...

Claude Opus 4.8: бенчмарки, цифри та що за ними стоїть

Claude Opus 4.8: бенчмарки, цифри та що за ними стоїть

Опубліковано: 30 травня 2026  |  Anthropic випустила Claude Opus 4.8 і одразу опублікувала таблицю бенчмарків із 15+ метрик. На перший погляд — черговий набір відсотків і позицій у рейтингах. Але якщо читати уважно — за цими цифрами стоїть...

Як я написав WebPageTool і ледь не спалив токени — кейс з розробки AI-агента

Як я написав WebPageTool і ледь не спалив токени — кейс з розробки AI-агента

Один запит користувача. Одна URL. Одинадцять викликів підряд. Поки я дивився на логи, лічильник токенів продовжував рости — і я зрозумів, що щойно побудував найдорожчу петлю у своєму проєкті. Зміст Перший тест Що таке "важка операція" в LLM і чому це важливо...

Claude Opus 4.8: що нового в головній AI-моделі Anthropic

Claude Opus 4.8: що нового в головній AI-моделі Anthropic

Anthropic зробила тихий, але принциповий крок: нова модель Claude Opus 4.8 — це не просто оновлення бенчмарків. Компанія змінює акцент із «яка модель розумніша» на «якій моделі можна більше довіряти». Розбираємо, що реально змінилося і чому це важливо для...

NVIDIA NIM: як безкоштовний inference змінює архітектуру AI-систем

NVIDIA NIM: як безкоштовний inference змінює архітектуру AI-систем

Як продовження цієї теми я розбираю більш практичний аспект — які саме моделі в NVIDIA NIM найкраще підходять під різні типи задач, і як я їх використовую в реальних agentic та RAG-системах. Окремо фокусуюся на trade-offs між швидкістю, якістю та довжиною контексту, а також на тому, як ці вибори...

Search API для AI агентів: що обирають розробники і де помиляються

Search API для AI агентів: що обирають розробники і де помиляються

Перший search tool у AI агента завжди виглядає добре. Ти пишеш @Tool, додаєш опис, і модель розуміє — коли гуглити, а коли відповідати з пам'яті. Два tools — теж нормально. П'ять — починаються перші сюрпризи. А коли їх стає 15–20, трапляється те, що я бачив у кожному...

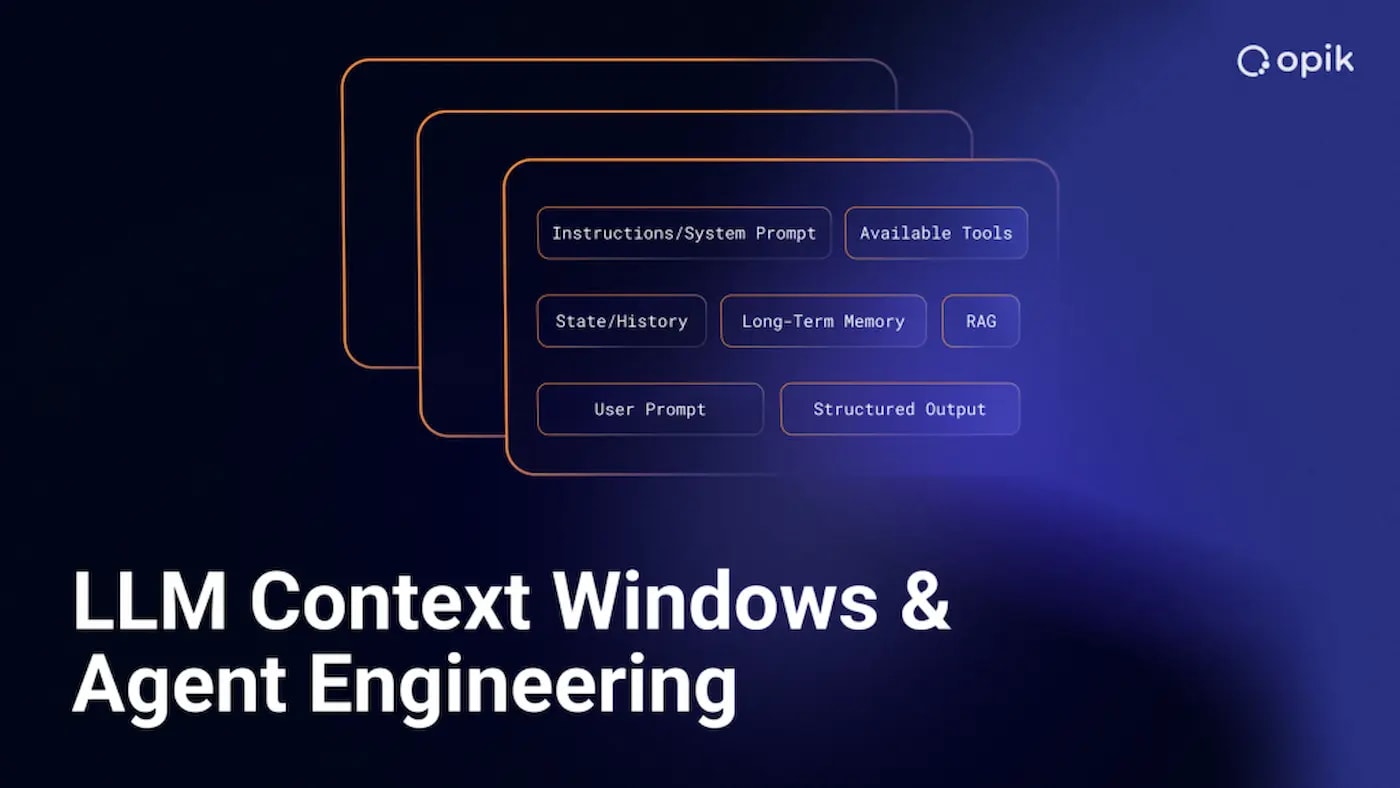
Як керувати контекстом AI агента: sliding window, summarization і compression з прикладами

Як керувати контекстом AI агента: sliding window, summarization і compression з прикладами

TL;DR Як ефективно керувати контекстом у довгоживучих AI-агентах: — Sliding Window + Pinning — Автоматична summarization з розумними тригерами — Compression та semantic memory З конкретними цифрами, кодом і архітектурними рішеннями, які значно підвищили стабільність агента. Ця стаття —...

Пам'ять AI агента: in-context, episodic, RAG і semantic — коли що використовувати

Пам'ять AI агента: in-context, episodic, RAG і semantic — коли що використовувати

Агент отримав запит — обробив — відповів. Наступний запит — і він не пам'ятає нічого з попереднього. Не тому що щось зламалось. А тому що так влаштована LLM за замовчуванням: кожен виклик — чистий аркуш. Якщо ви будуєте агента і не думали про пам'ять — ви будуєте амнезика з доступом до...

Grok Build від xAI: детальний технічний огляд

Grok Build від xAI: детальний технічний огляд

Grok Build — новий agentic CLI від xAI (early beta, 14 травня 2026). Головні фішки: Plan Mode з обов’язковим затвердженням плану, паралельні субагенти (до 8), контекстне вікно ~1–2M токенів та сучасний TUI на Rust. Працює на Grok 4.3, підтримує ACP, git worktree та MCP....

Ollama 0.24 + Codex App: як запустити локальний AI coding agent

Ollama 0.24 + Codex App: як запустити локальний AI coding agent

Оновлено: 15 травня 2026 14 травня 2026 вийшла Ollama 0.24 — і це не черговий патч з виправленням багів. Цей реліз додає офіційну підтримку Codex App від OpenAI: тепер десктопний AI coding agent можна запустити на будь-якій локальній або хмарній моделі через Ollama....

Tool RAG: що робити коли у агента забагато інструментів

Tool RAG: що робити коли у агента забагато інструментів

У вас 5 tools — все чудово. У вас 15 tools — починаються проблеми. У вас 50 tools — агент деградує. Але є рішення яке вирішує проблему масштабу елегантно — і ви вже знаєте як воно працює, бо використовуєте його для документів. Ця стаття — частина серії про AI агентів на Spring Boot. Якщо...

Grounding в AI агентах: що робити коли tool call повернув не те

Grounding в AI агентах: що робити коли tool call повернув не те

Уявіть: ваш AI агент отримав запит «яка ціна на Enterprise план?». Він викликав tool. Tool відповів. Агент сформулював відповідь — впевнено, зв'язно, з конкретною цифрою. Клієнт отримав відповідь і пішов задоволений. Проблема в тому що tool повернув порожній результат — документ не...

Я змусив два AI посперечатись про vibe coding — ось що вийшло

Я змусив два AI посперечатись про vibe coding — ось що вийшло

Я очікував що AI здасться через 3 раунди. Він не здався через 8. І це змінило моє розуміння того як працюють мовні моделі. Як виникла ідея Класична проблема AI-агентів — вони занадто ввічливі. Попроси ChatGPT посперечатись — він погодиться через два повідомлення. Мене це дратувало. Я...

Наступні статті