Cuantización GGUF para Ollama: Q4_K_M vs Q8_0 Guía
Q4_K_M, Q8_0, IQ4_XS — qué significan los sufijos GGUF y qué cuantización elegir para Ollama. Tabla de RAM para 7B–70B + fórmula de cálculo de memoria.
Artículos útiles sobre Java, Spring, SEO, frontend y tecnologías modernas. Consejos, ejemplos y lifehacks para desarrolladores
Q4_K_M, Q8_0, IQ4_XS — qué significan los sufijos GGUF y qué cuantización elegir para Ollama. Tabla de RAM para 7B–70B + fórmula de cálculo de memoria.
Después de 30 mensajes, el bot comienza a olvidar el inicio de la conversación. Te explico cómo lo resolví a través de varias capas de memoria, sin aumentar los costos de
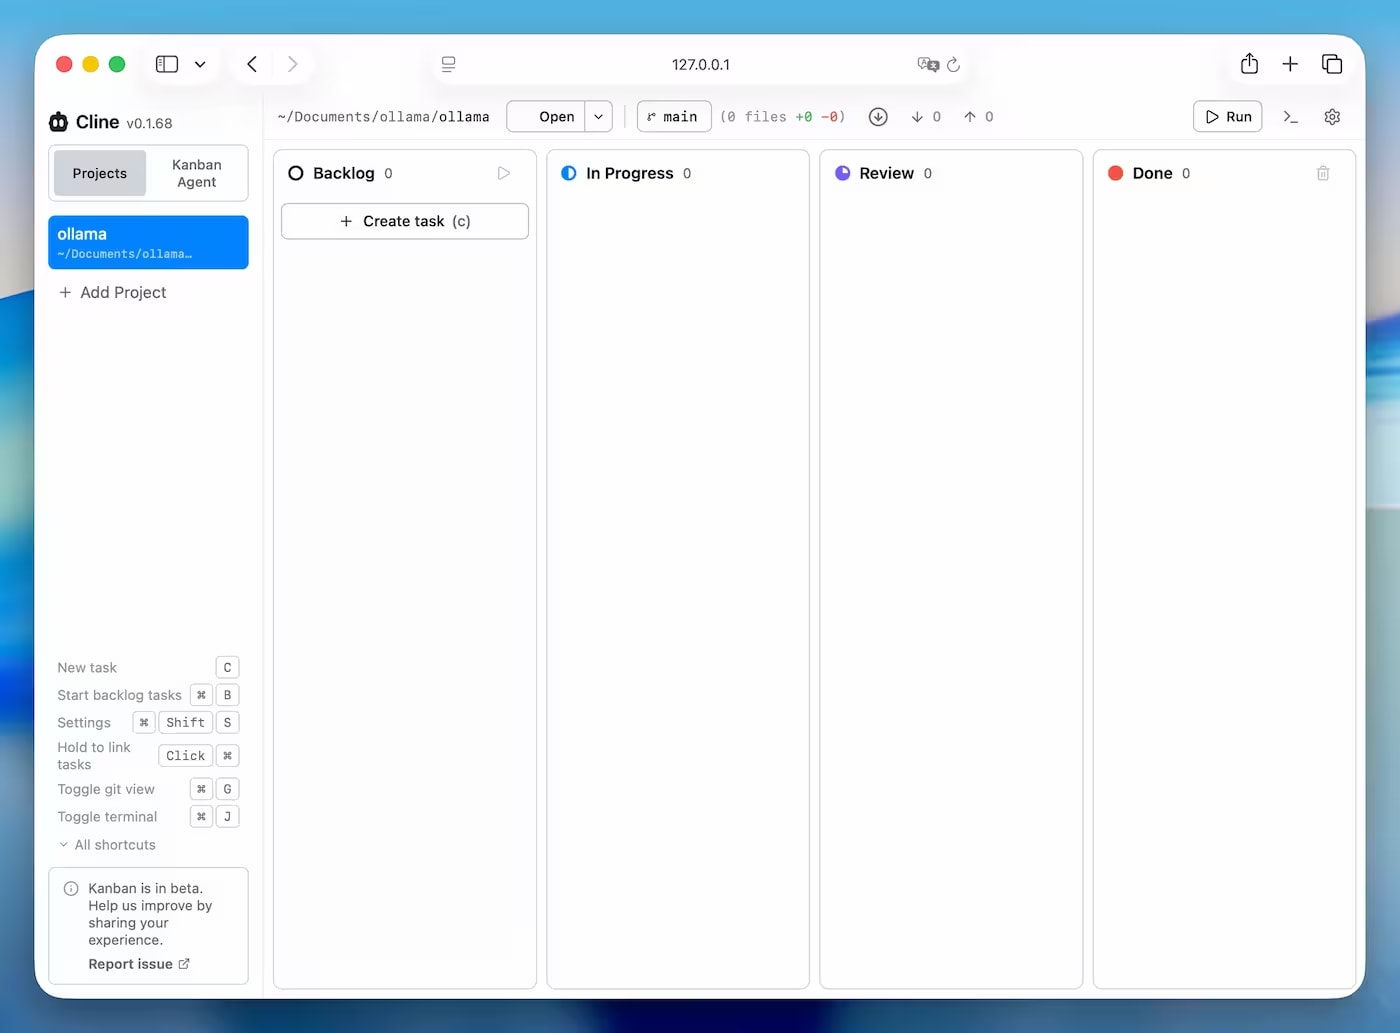
Experiencia real de instalación de Cline a través de Ollama: errores de Node >=22, EACCES, PATH después de Homebrew y ejecución de Kanban Board en 127.0.0.1:3484.
Ollama anunció ollama launch cline — un agente de IA en una línea en la terminal. Modelos locales y en la nube, Kanban Board, comparación con Cursor y Claude Code.
Google lanzó DiffusionGemma, un modelo de difusión abierto de 26 mil millones de parámetros que genera texto 4 veces más rápido que GPT, Llama y Qwen. ¿Qué significa esto
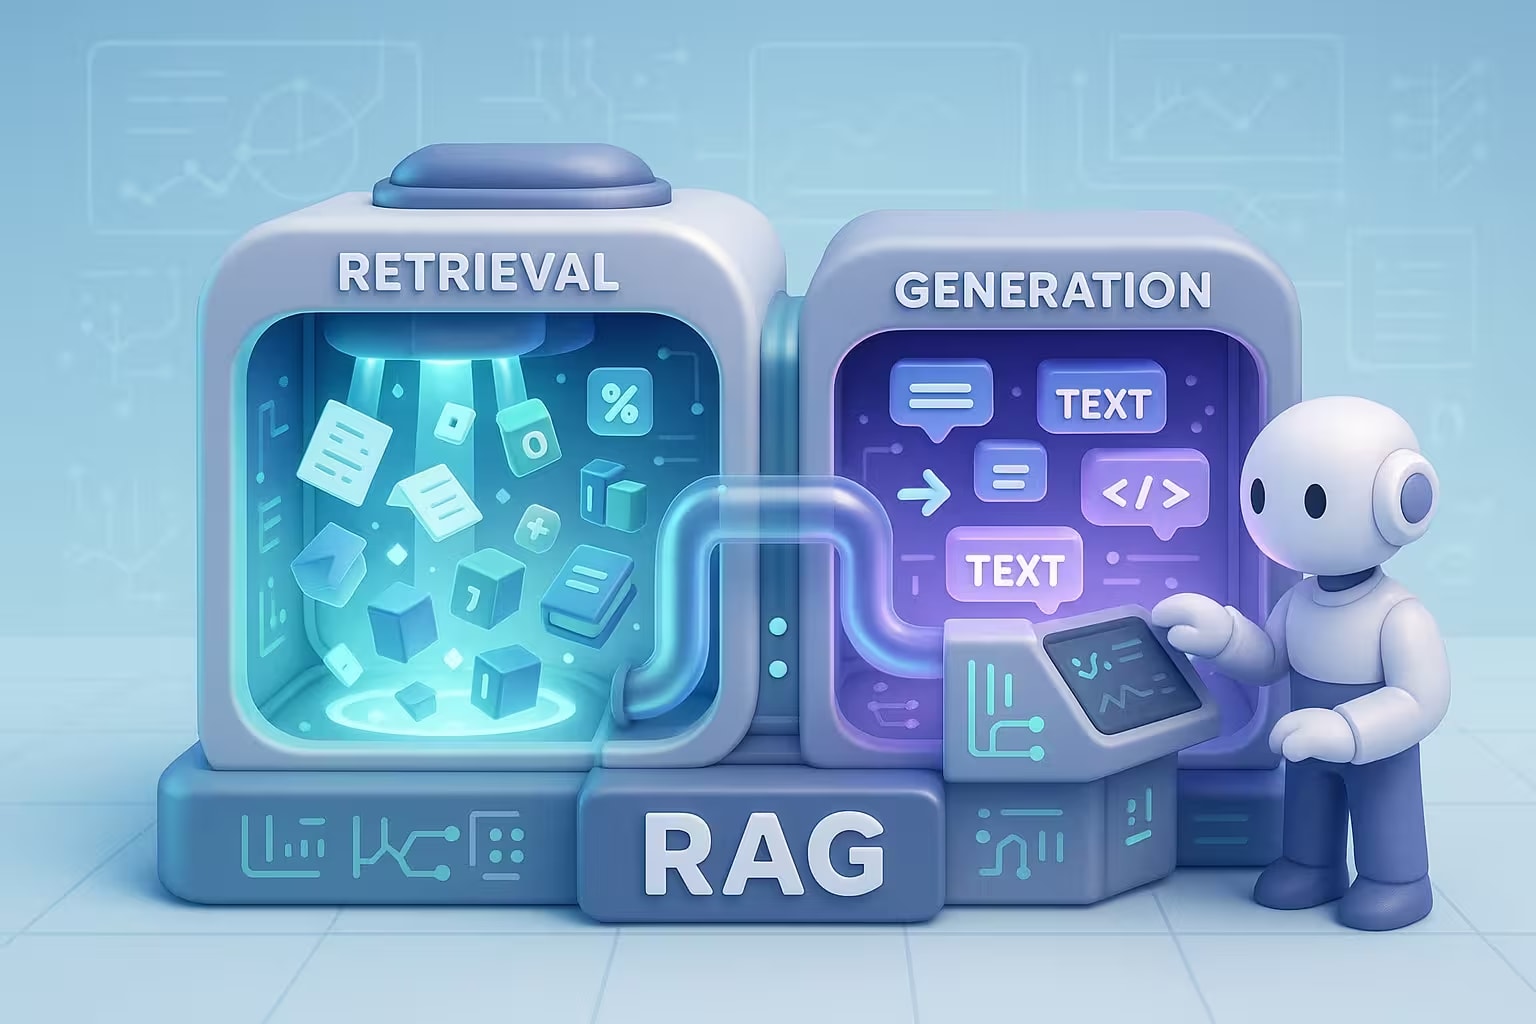
¿LangChain o LlamaIndex? ¿Qdrant o pgvector? Comparación de 12 herramientas RAG de código abierto con tablas de compensación, 5 pilas listas para usar y antipatrones.
Anthropic lanzó Claude Fable 5, el primer modelo público de clase Mythos. Analizamos benchmarks, precios, limitaciones y la razón del lanzamiento tras meses de silencio.
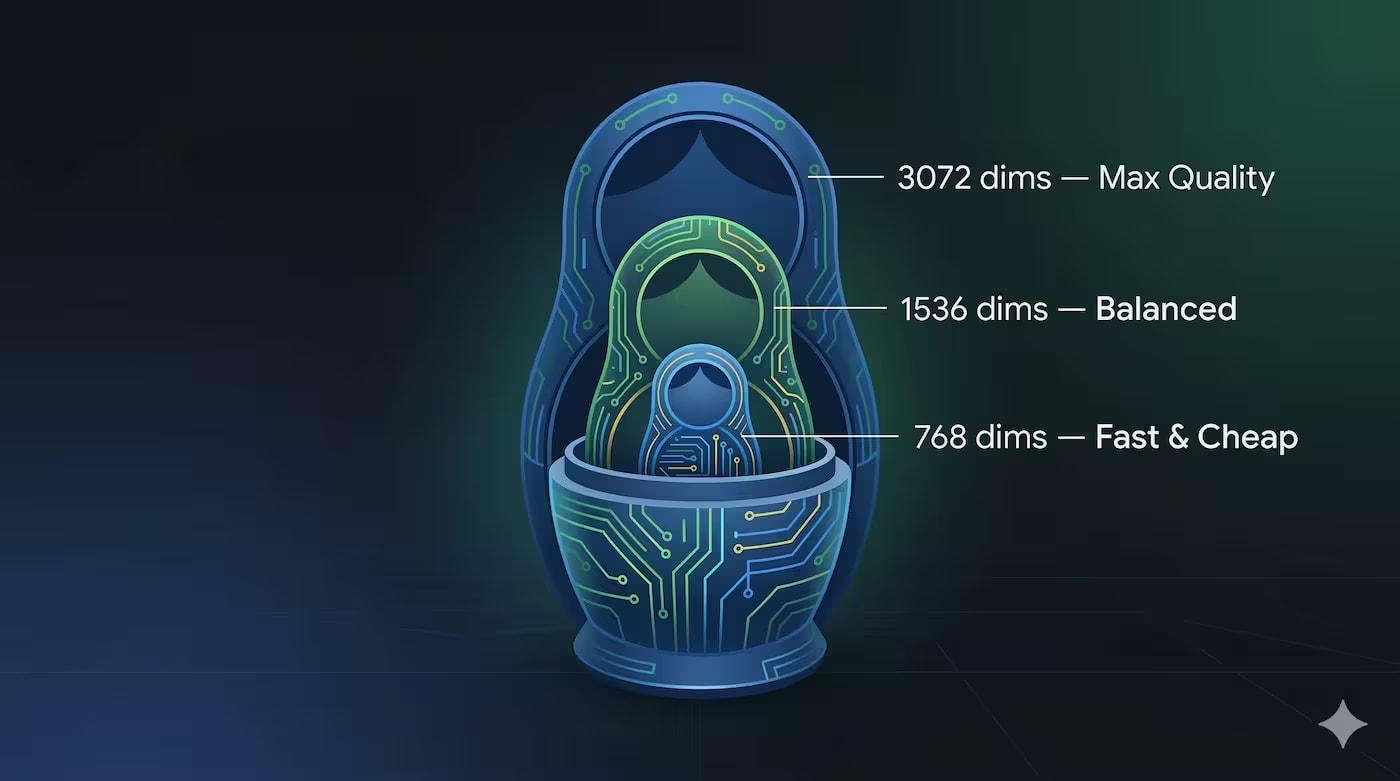
Comparación de text-embedding-3-small (1536) y text-embedding-3-large (3072) para RAG 2026. RAM, coste, benchmarks MTEB, reranking como alternativa. Matriz de elección
Comparación de arquitecturas OCR-first y Vision-first para el procesamiento de documentos en sistemas RAG 2026. GPT-4o, Gemini, Qwen2.5-VL, olmOCR, Docling — compensacion
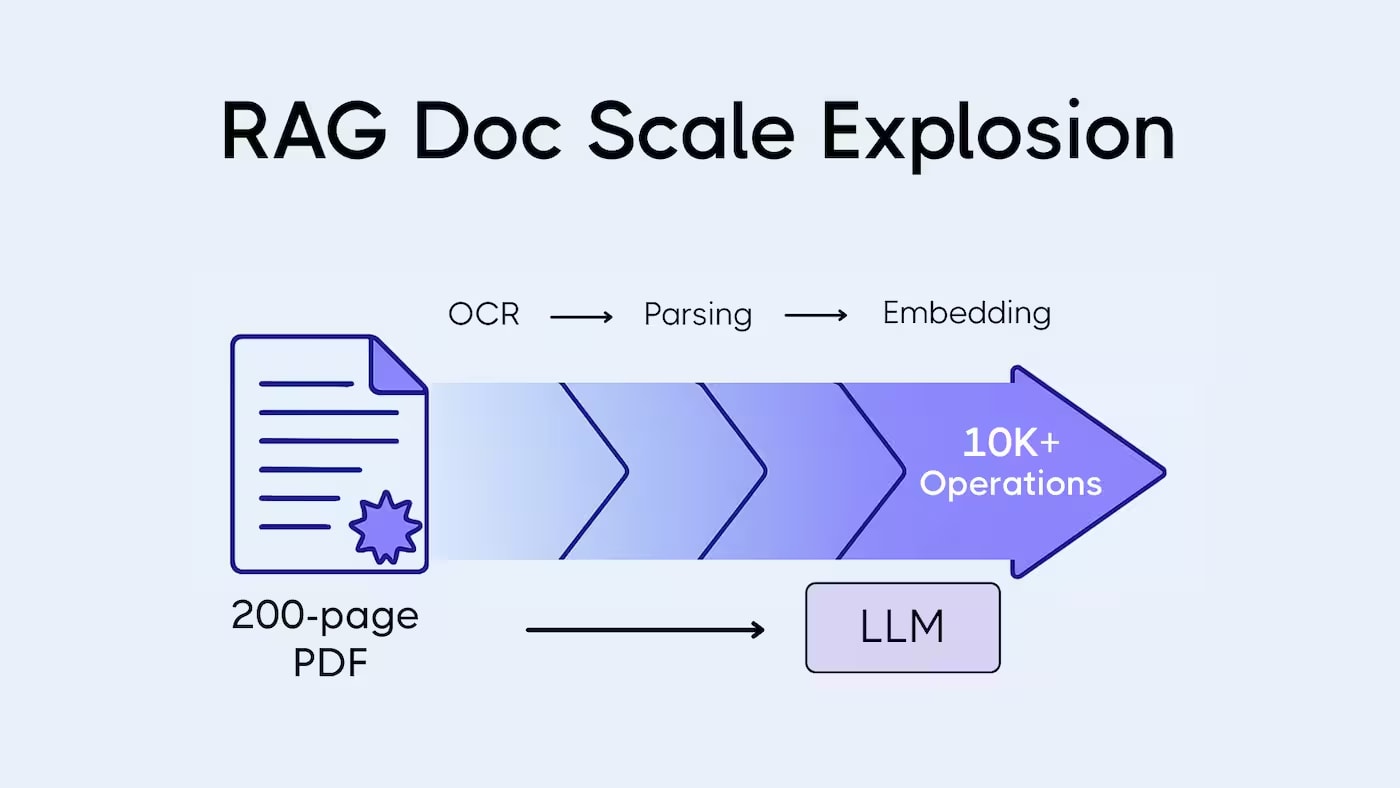
Análisis técnico de cómo los errores de OCR arruinan el chunking, distorsionan los embeddings y reducen la recuperación en un pipeline RAG. Con ejemplos reales de artefac
В огляді Ollama 0.30 я показав базову механіку запуску GGUF у три кроки і пообіцяв окремий розбір з усіма нюансами. Ось він. Тут — повний практичний гайд: де брати GGUF-файл, як правильно написати Modelfile, які команди виконати, як перевірити підтримку tool calling і що робити, коли модель...
Resumen de la actualización de Ollama 0.30: soporte GGUF con Hugging Face, Vulkan por defecto, aceleración en NVIDIA, integración con llama.cpp y ollama launch.
Por qué el 70-80% de los documentos corporativos no son accesibles para la IA sin OCR. Cómo el reconocimiento de texto encaja en un pipeline RAG y cuándo se necesita Visi
SWE-bench, Terminal-Bench, GPQA, long-context — analizamos todos los benchmarks de Claude Opus 4.8 con cifras. Dónde Anthropic está por delante, dónde se queda atrás de G
Cómo agregué WebPageTool a un agente de IA, obtuve 11 llamadas seguidas y descubrí por qué un modelo local se comporta de manera diferente a uno en la nube. Caso real con
Anthropic зробила тихий, але принциповий крок: нова модель Claude Opus 4.8 — це не просто оновлення бенчмарків. Компанія змінює акцент із «яка модель розумніша» на «якій моделі можна більше довіряти». Розбираємо, що реально змінилося і чому це важливо для...
NVIDIA ha abierto el acceso a más de 100 modelos de IA de forma gratuita a través de la API NIM. Analizamos la arquitectura de la capa de inferencia, comparaciones con Gr
Tavily, Brave, Exa, SerpAPI, Serper — comparación honesta con precios actuales 2026. Tabla de decisiones por escenarios y errores típicos de arquitectura de herramientas
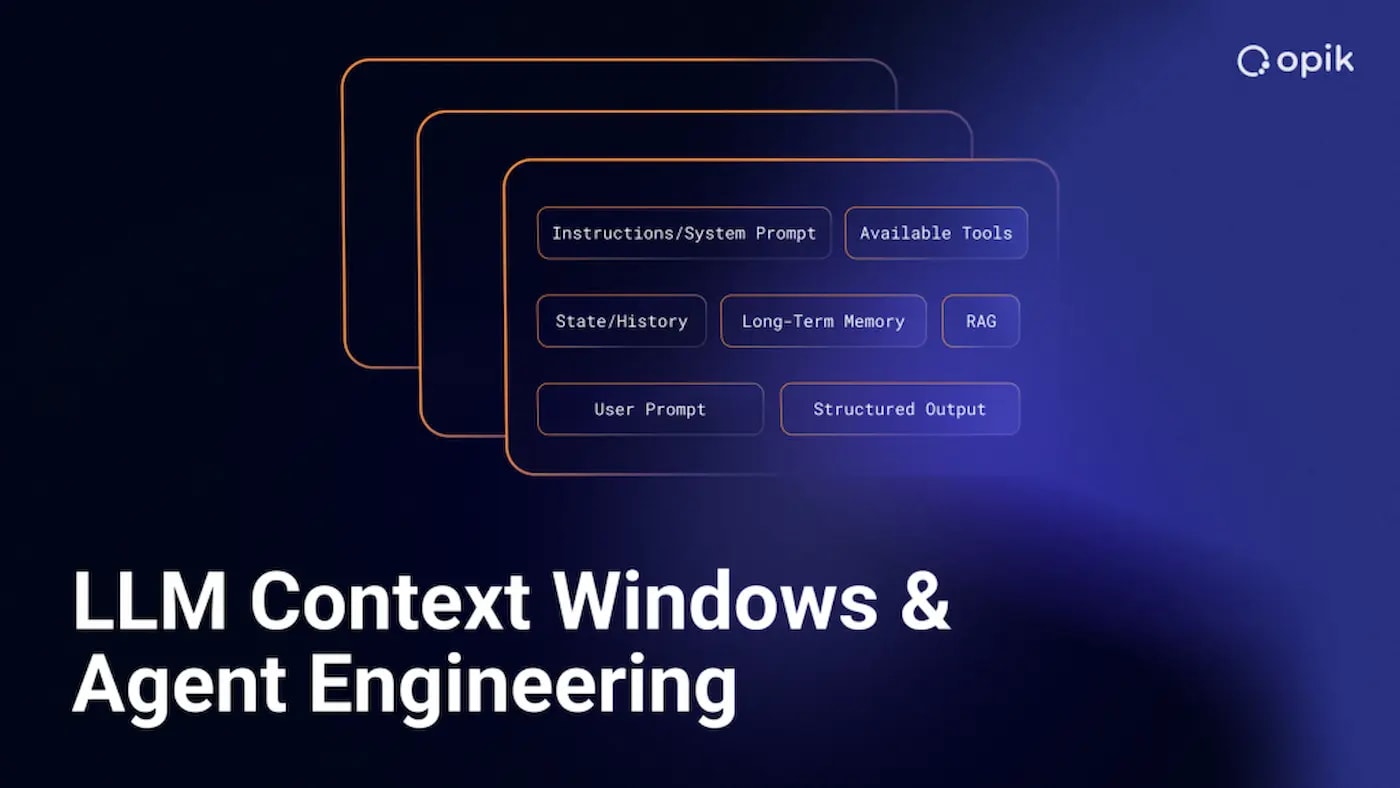
TL;DR Як ефективно керувати контекстом у довгоживучих AI-агентах: — Sliding Window + Pinning — Автоматична summarization з розумними тригерами — Compression та semantic memory З конкретними цифрами, кодом і архітектурними рішеннями, які значно підвищили стабільність агента. Ця стаття —...
Агент отримав запит — обробив — відповів. Наступний запит — і він не пам'ятає нічого з попереднього. Не тому що щось зламалось. А тому що так влаштована LLM за замовчуванням: кожен виклик — чистий аркуш. Якщо ви будуєте агента і не думали про пам'ять — ви будуєте амнезика з доступом до...
Grok Build — новий agentic CLI від xAI (early beta, 14 травня 2026). Головні фішки: Plan Mode з обов’язковим затвердженням плану, паралельні субагенти (до 8), контекстне вікно ~1–2M токенів та сучасний TUI на Rust. Працює на Grok 4.3, підтримує ACP, git worktree та MCP....
Оновлено: 15 травня 2026 14 травня 2026 вийшла Ollama 0.24 — і це не черговий патч з виправленням багів. Цей реліз додає офіційну підтримку Codex App від OpenAI: тепер десктопний AI coding agent можна запустити на будь-якій локальній або хмарній моделі через Ollama....
У вас 5 tools — все чудово. У вас 15 tools — починаються проблеми. У вас 50 tools — агент деградує. Але є рішення яке вирішує проблему масштабу елегантно — і ви вже знаєте як воно працює, бо використовуєте його для документів. Ця стаття — частина серії про AI агентів на Spring Boot. Якщо...
Уявіть: ваш AI агент отримав запит «яка ціна на Enterprise план?». Він викликав tool. Tool відповів. Агент сформулював відповідь — впевнено, зв'язно, з конкретною цифрою. Клієнт отримав відповідь і пішов задоволений. Проблема в тому що tool повернув порожній результат — документ не...
Я очікував що AI здасться через 3 раунди. Він не здався через 8. І це змінило моє розуміння того як працюють мовні моделі. Як виникла ідея Класична проблема AI-агентів — вони занадто ввічливі. Попроси ChatGPT посперечатись — він погодиться через два повідомлення. Мене це дратувало. Я...