GGUF Q4_K_M vs Q8_0: Quantisierung für Ollama 2026
Q4_K_M, Q8_0, IQ4_XS — was die Suffixe GGUF bedeuten und welche Quantisierung für Ollama gewählt werden sollte. RAM-Tabelle für 7B–70B + Formel zur Speicherkalkulation.
Nützliche Artikel zu Java, Spring, SEO, Frontend und modernen Technologien. Tipps, Beispiele und Lifehacks für Entwickler
Q4_K_M, Q8_0, IQ4_XS — was die Suffixe GGUF bedeuten und welche Quantisierung für Ollama gewählt werden sollte. RAM-Tabelle für 7B–70B + Formel zur Speicherkalkulation.
Nach 30 Nachrichten beginnt der Bot, den Anfang des Gesprächs zu vergessen. Ich erkläre, wie ich das mit mehreren Speicherschichten gelöst habe – ohne steigende Token-Kos
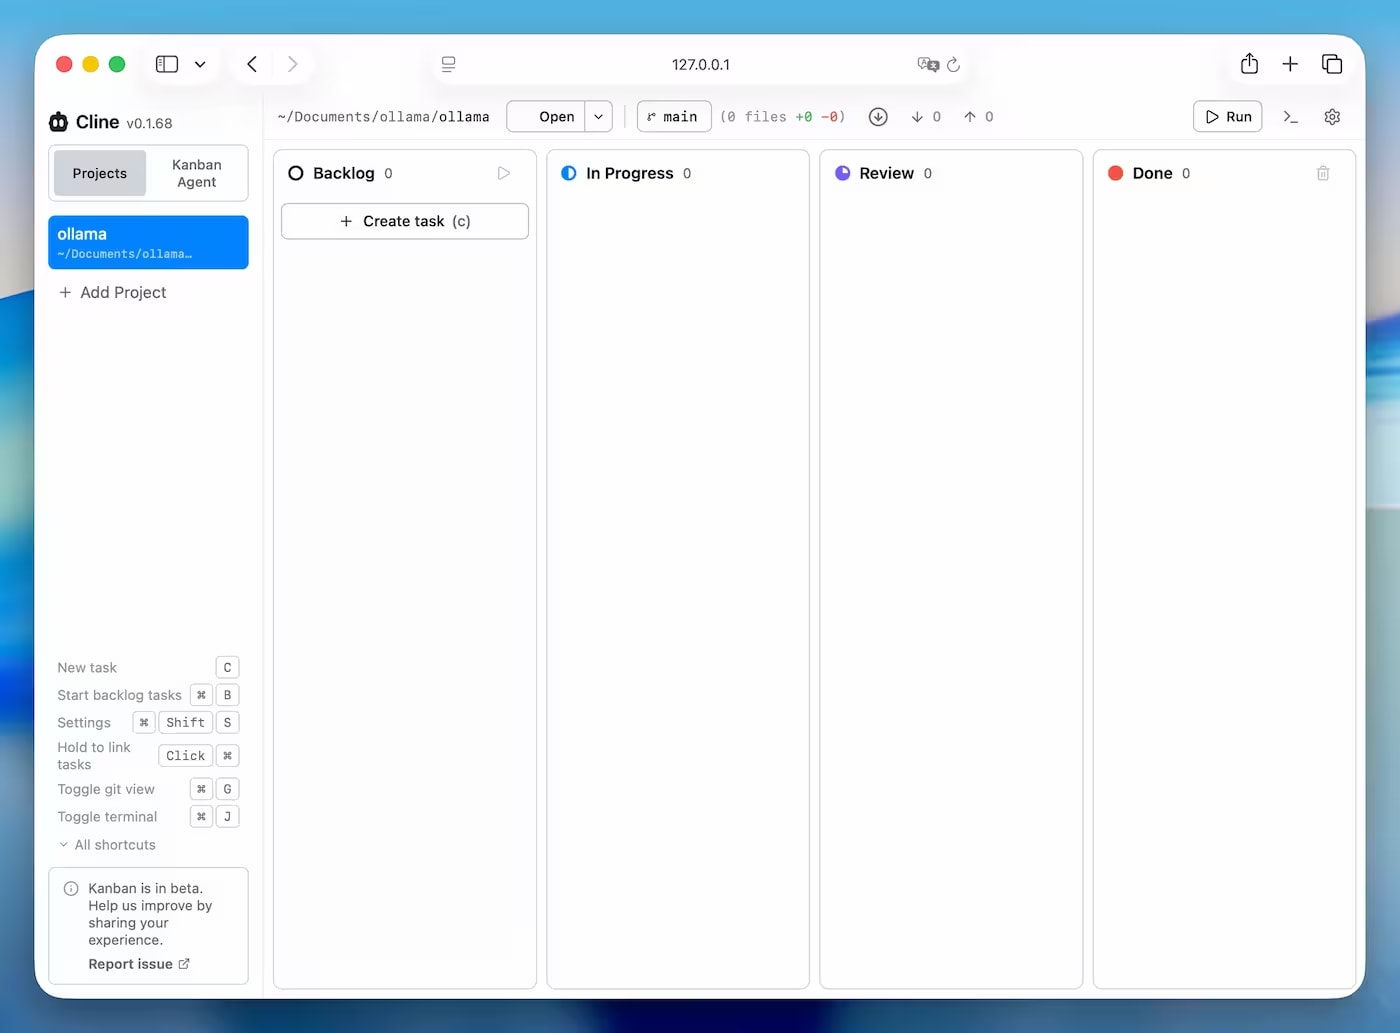
Reale Erfahrung mit der Installation von Cline über Ollama: Node >=22 Fehler, EACCES, PATH nach Homebrew und Starten des Kanban Boards auf 127.0.0.1:3484.
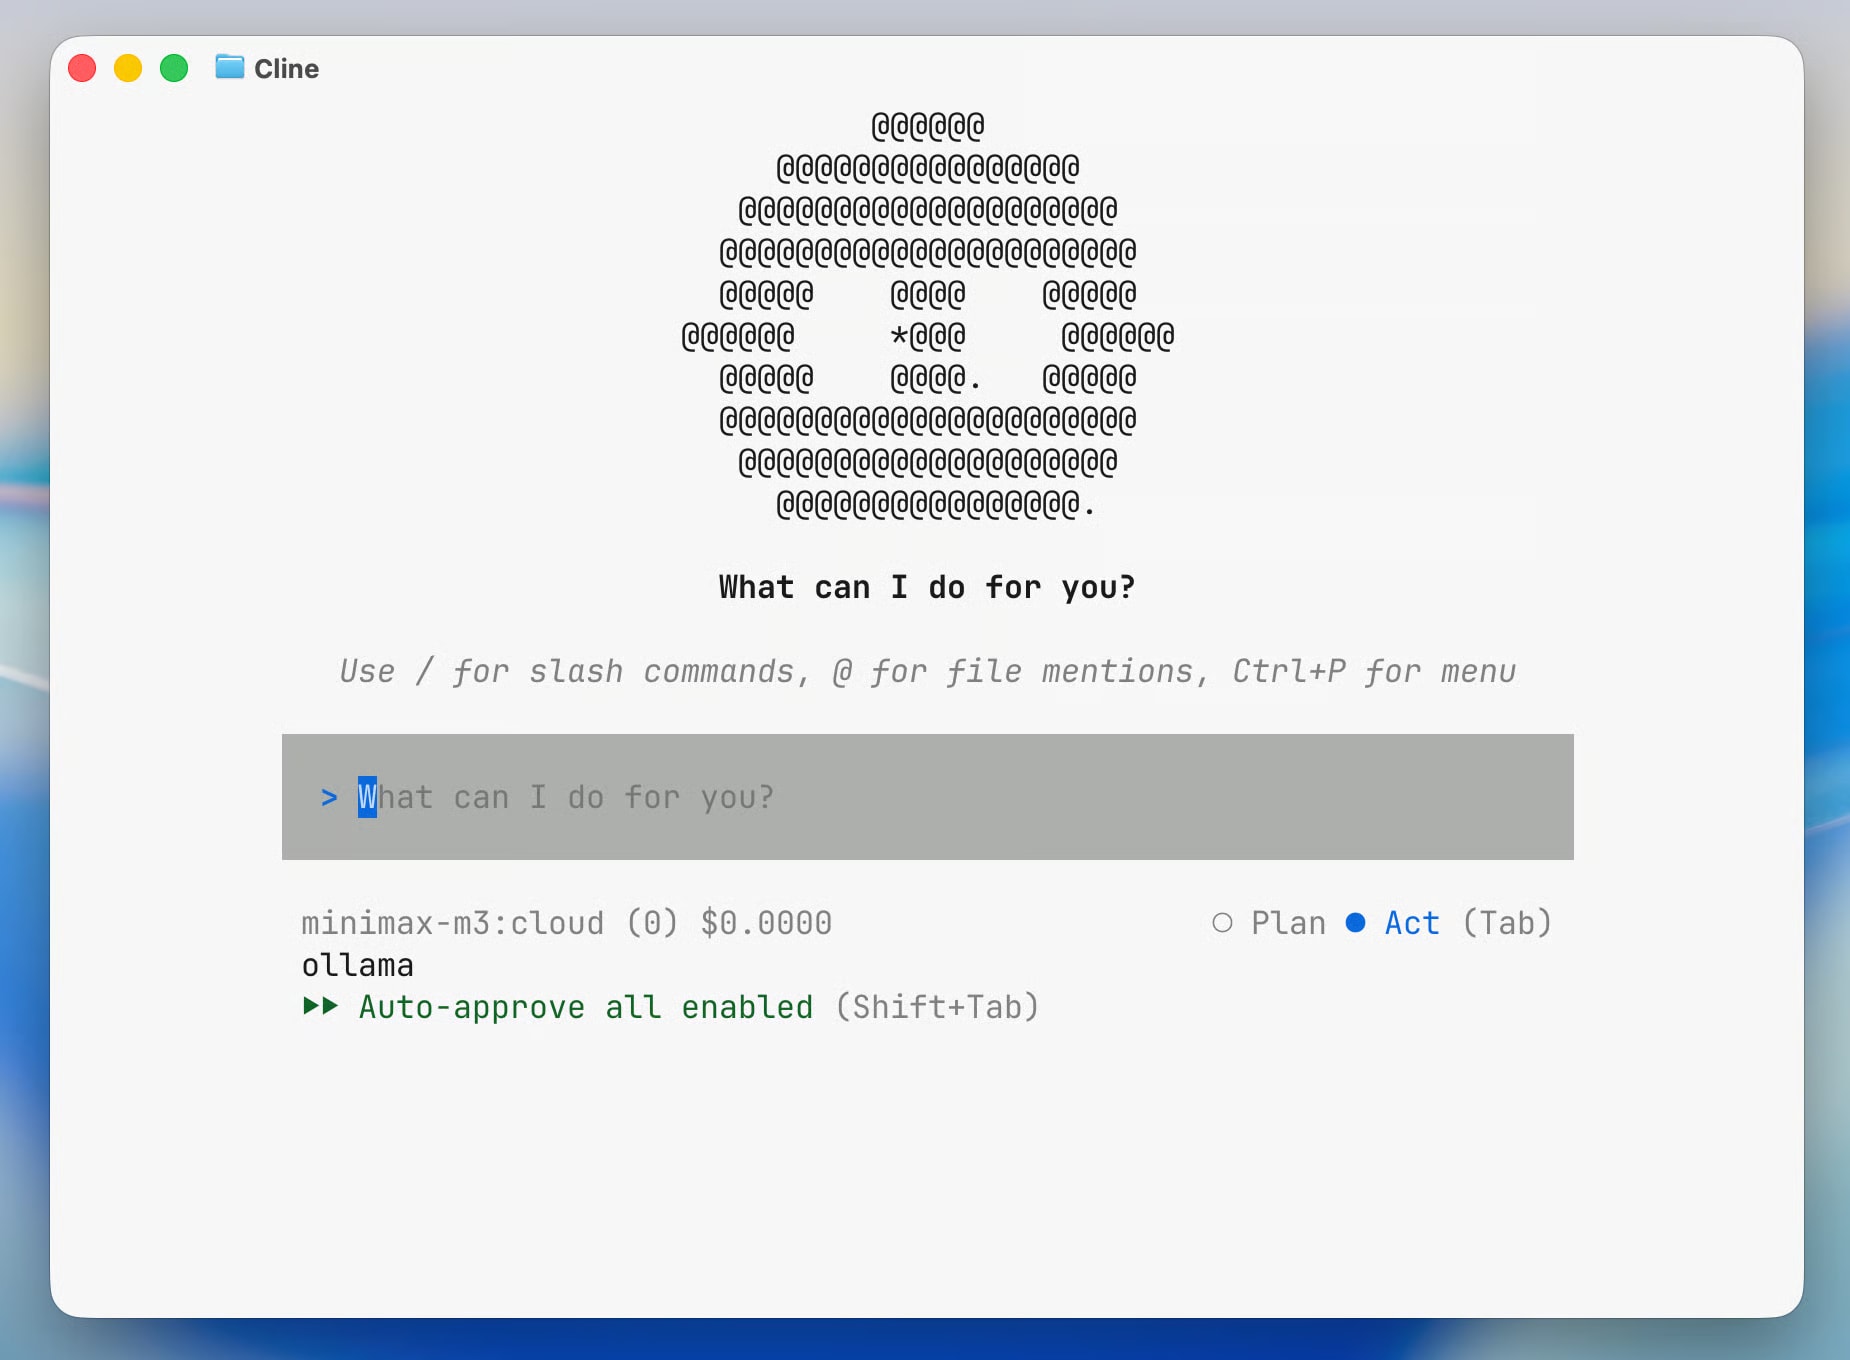
Ollama kündigt ollama launch cline an – ein KI-Agent in einer Zeile im Terminal. Lokale und Cloud-Modelle, Kanban-Board, Vergleiche mit Cursor und Claude Code.
Google hat DiffusionGemma veröffentlicht – ein Open-Source-Diffusionsmodell mit 26 Milliarden Parametern, das Text viermal schneller generiert als GPT, Llama und Qwen. Wa
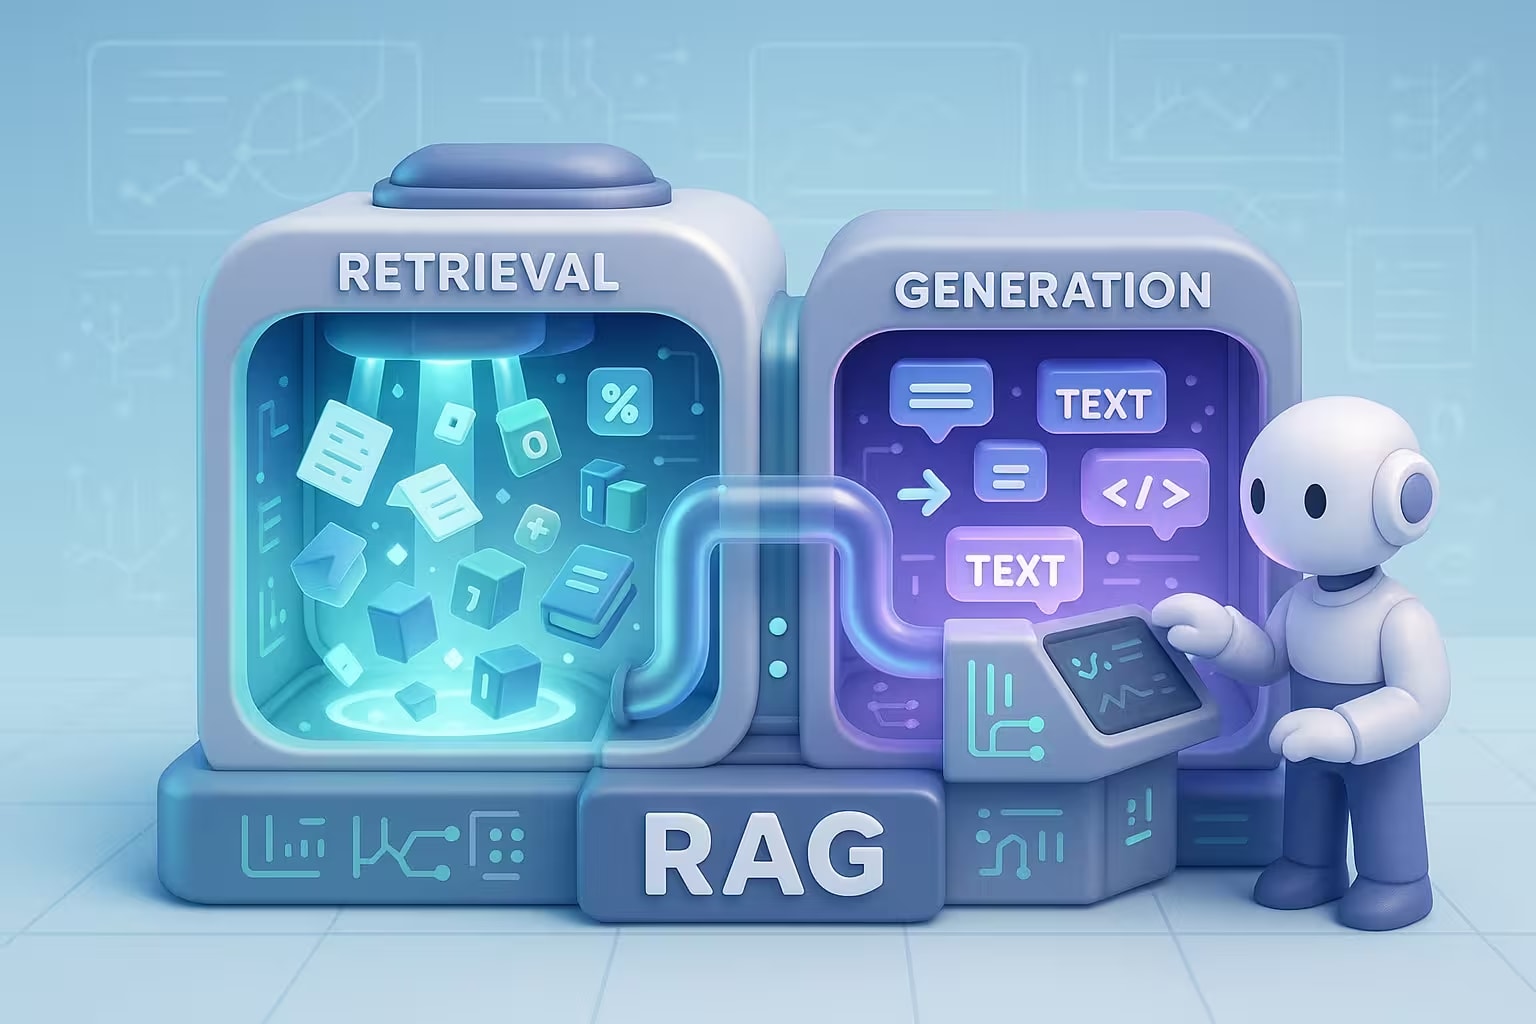
LangChain oder LlamaIndex? Qdrant oder pgvector? Vergleich von 12 Open-Source-RAG-Tools mit Trade-off-Tabellen, 5 fertigen Stacks und Anti-Patterns.
Anthropic hat Claude Fable 5 veröffentlicht – das erste öffentliche Modell der Mythos-Klasse. Wir analysieren Benchmarks, Preise, Einschränkungen und den Grund für die Ve
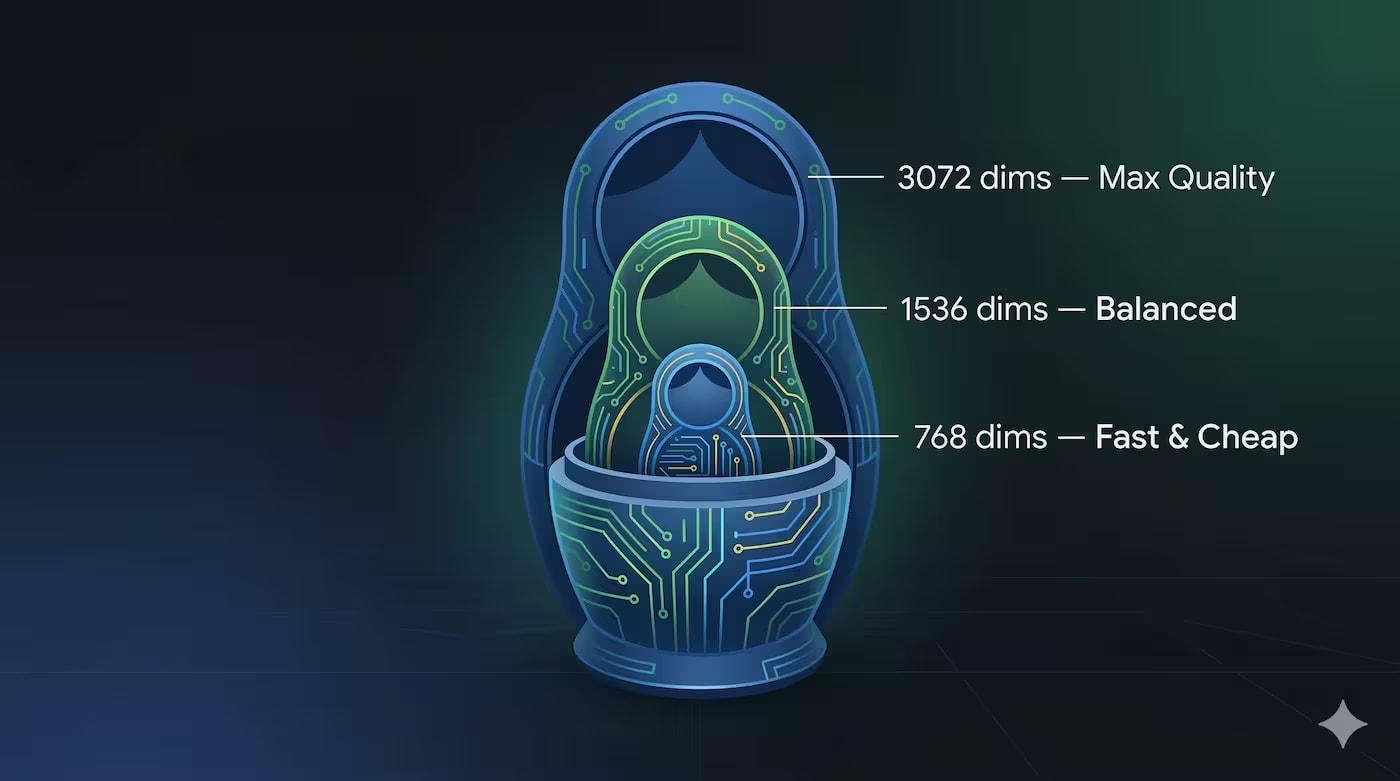
Vergleich von text-embedding-3-small (1536) und text-embedding-3-large (3072) für RAG 2026. RAM, Kosten, MTEB-Benchmarks, Re-Ranking als Alternative. Auswahlmatrix
Vergleich von OCR-first und Vision-first Architekturen für die Dokumentenverarbeitung in RAG-Systemen 2026. GPT-4o, Gemini, Qwen2.5-VL, olmOCR, Docling – Qualitäts-Trade-
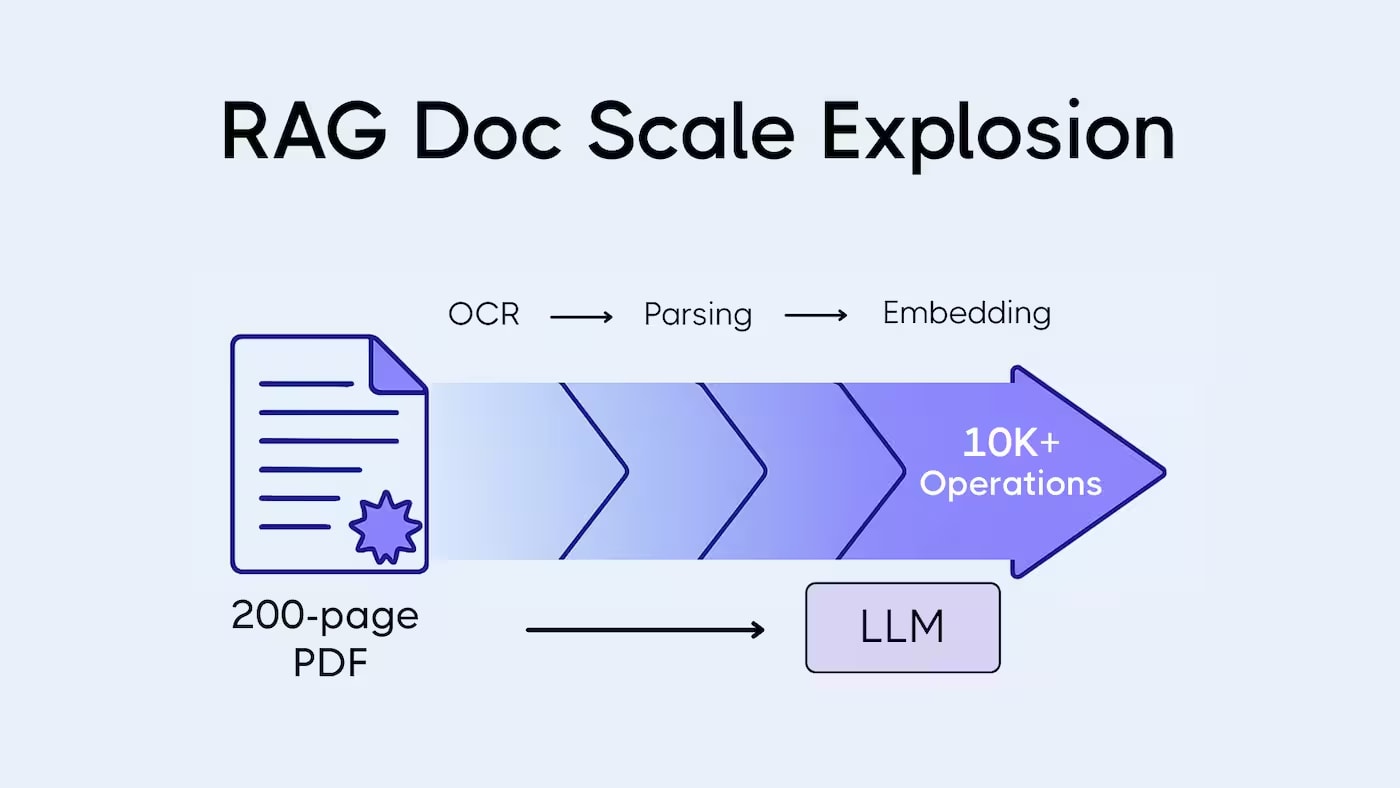
Technische Analyse, wie OCR-Fehler das Chunking zerstören, Embeddings verzerren und den Recall in einer RAG-Pipeline reduzieren. Mit echten Beispielen von Artefakten
В огляді Ollama 0.30 я показав базову механіку запуску GGUF у три кроки і пообіцяв окремий розбір з усіма нюансами. Ось він. Тут — повний практичний гайд: де брати GGUF-файл, як правильно написати Modelfile, які команди виконати, як перевірити підтримку tool calling і що робити, коли модель...
Übersicht über das Ollama 0.30 Update: GGUF-Unterstützung von Hugging Face, Vulkan standardmäßig, NVIDIA-Beschleunigung, Integration mit llama.cpp und ollama launch.
Warum 70–80 % der Unternehmensdokumente für KI ohne OCR unzugänglich sind. Wie Texterkennung in die RAG-Pipeline passt und wann Vision OCR benötigt wird.
SWE-bench, Terminal-Bench, GPQA, Long-Context – Wir analysieren alle Benchmarks von Claude Opus 4.8 mit Zahlen. Wo Anthropic vorne liegt, wo es hinter GPT-5.5 zurückbleib
Wie ich WebPageTool zu einem KI-Agenten hinzufügte, 11 Anrufe hintereinander erhielt und herausfand, warum ein lokales Modell anders funktioniert als ein Cloud-Modell. Ei
Anthropic зробила тихий, але принциповий крок: нова модель Claude Opus 4.8 — це не просто оновлення бенчмарків. Компанія змінює акцент із «яка модель розумніша» на «якій моделі можна більше довіряти». Розбираємо, що реально змінилося і чому це важливо для...
NVIDIA hat über die NIM API kostenlosen Zugriff auf über 100 KI-Modelle freigeschaltet. Wir untersuchen die Architektur der Inference Layer, Vergleiche mit Groq und Toget
Ehrlicher Vergleich: Tavily, Brave, Exa, SerpAPI und Serper für KI-Agenten und RAG. Aktuelle Preise 2026, DSGVO-Hinweise und Entscheidungstabelle nach Anwendungsfall
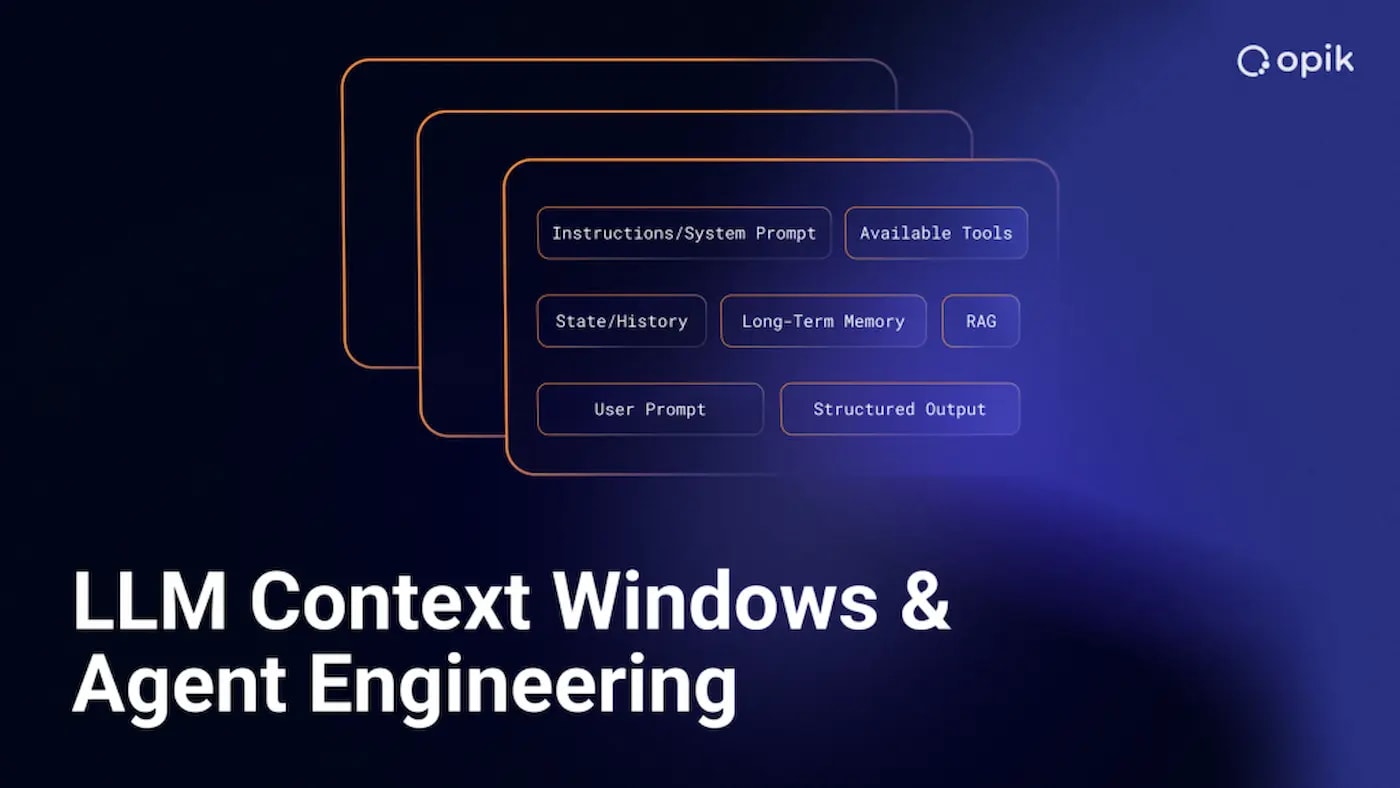
TL;DR Як ефективно керувати контекстом у довгоживучих AI-агентах: — Sliding Window + Pinning — Автоматична summarization з розумними тригерами — Compression та semantic memory З конкретними цифрами, кодом і архітектурними рішеннями, які значно підвищили стабільність агента. Ця стаття —...
In-Kontext, episodisch, RAG und semantischer Speicher für KI-Agenten auf Spring Boot. Realer ContextService aus der Produktion, Entscheidungsbaum und Code mit pgvector.
Grok Build — новий agentic CLI від xAI (early beta, 14 травня 2026). Головні фішки: Plan Mode з обов’язковим затвердженням плану, паралельні субагенти (до 8), контекстне вікно ~1–2M токенів та сучасний TUI на Rust. Працює на Grok 4.3, підтримує ACP, git worktree та MCP....
Mit Ollama kannst du Codex App lokal betreiben – volle AI Coding Agent ohne OpenAI-Abo.
Nach 10-15 Tools sinkt die Auswahlgenauigkeit. Das RAG-Tool löst dies durch Vektorsuche im Tool-Register. Implementierung mit Spring AI + pgvector mit Code und Zahlen
Leeres Tool-Ergebnis, niedrige Relevanz, API-Fehler — wie Ihr Agent ohne Grounding halluziniert und wie Sie es beheben. Confidence Scoring + Re-Query in Spring AI.
Я очікував що AI здасться через 3 раунди. Він не здався через 8. І це змінило моє розуміння того як працюють мовні моделі. Як виникла ідея Класична проблема AI-агентів — вони занадто ввічливі. Попроси ChatGPT посперечатись — він погодиться через два повідомлення. Мене це дратувало. Я...