Маєш ноутбук з 8 ГБ оперативної пам'яті і хочеш запустити AI локально?
Ця стаття — розбір: що працює, що ледь тягне,
а що навіть не варто завантажувати. Без ілюзій, з конкретними моделями
та командами для кожної задачі. Якщо ще не знайомий з Ollama —
почни з вступної статті про те що таке Ollama і навіщо вона потрібна.
Оновлено: жовтень 2026. Я перевірив розміри моделей за бібліотекою Ollama та прибрав рекомендації, які на 8 ГБ не поміщаються.
📌 Коротко і по суті
- ✅ Комфортно на 8 ГБ: моделі, що важать до ~3,5 ГБ на диску: Llama 3.2 3B, Qwen3 4B, Phi-4 Mini, Qwen3.5 4B, Gemma 3 4B
- ⚠️ На межі: Qwen3 8B та DeepSeek R1 8B (по 5,2 ГБ), потрібно закрити браузер та IDE
- ❌ Не підходять: Qwen3.5 9B (6,6 ГБ), Gemma 4 E2B та E4B за замовчуванням (7,2 та 9,6 ГБ), будь-які моделі 13B+
- 💻 Для коду: Qwen3.5 4B або Qwen3 4B. Для тексту: Llama 3.2 3B, Gemma 3 4B або Phi-4 Mini. Для reasoning: Phi-4 Mini Reasoning або DeepSeek R1 8B
- 🇺🇦 Якщо працюєш українською, перевір якість на власних прикладах: деякі моделі офіційно її не підтримують
📚 Зміст статті
🎯 Скільки RAM насправді лишається для моделі
Коротка відповідь:
З 8 ГБ оперативної пам'яті для AI-моделі реально доступно 3–5 ГБ.
Решту забирає операційна система, браузер і фонові процеси.
Це визначає головне правило: на 8 ГБ комфортно працюють моделі, які важать
до 3–3,5 ГБ на диску (зазвичай 3–4B параметрів у 4-бітній квантизації),
а моделі 7–8B працюють на межі.
8 ГБ RAM — це не 8 ГБ для моделі.
Це 8 ГБ мінус ОС, мінус Chrome, мінус все, що ти забув закрити.
Перш ніж обирати модель, потрібно зрозуміти реальний бюджет пам'яті.
Ось типовий розподіл на системі з 8 ГБ RAM:
- ✔️ Операційна система: 1.5–2.5 ГБ (macOS ближче до 2.5, Windows — 2, Linux — 1.5)
- ✔️ Браузер (5–10 вкладок): 1–2 ГБ
- ✔️ IDE (VS Code / IntelliJ): 0.5–1.5 ГБ
- ✔️ Фонові процеси: 0.3–0.5 ГБ
Залишок для моделі: 3–5 ГБ.
За даними
LocalLLM.in,
модель 7B параметрів у квантизації Q4_K_M займає приблизно 4–5 ГБ,
плюс 1–2 ГБ на KV-кеш і системний overhead.
Це означає: 7B-модель на 8 ГБ — можливо, але на межі, і краще закрити
все зайве.
📏 Розмір на диску ≈ розмір у пам'яті
Розмір моделі в бібліотеці Ollama майже дорівнює обсягу пам'яті, який займуть її ваги.
Сюди ще додається KV-кеш (він росте разом із контекстним вікном) та службова пам'ять.
Тому дивіться не на кількість параметрів у назві, а на реальний розмір тегу.
Ось що показує бібліотека Ollama для моделей, які ми розглядаємо в статті:
| 🛠️ Модель (тег) |
💾 Розмір в Ollama |
🚦 На 8 ГБ |
llama3.2:3b | 2,0 ГБ | ✅ Комфортно |
qwen3:4b | 2,5 ГБ | ✅ Комфортно |
phi4-mini | 2,5 ГБ | ✅ Комфортно |
gemma3:4b | 3,3 ГБ | ✅ Комфортно |
qwen3.5:4b | 3,4 ГБ | ✅ Комфортно, але вже відчутно |
qwen3:8b | 5,2 ГБ | ⚠️ На межі |
deepseek-r1:8b | 5,2 ГБ | ⚠️ На межі |
qwen3.5:9b | 6,6 ГБ | ❌ Не поміщається разом із системою |
gemma4:e2b | 7,2 ГБ | ❌ Не поміщається |
gemma4:e4b | 9,6 ГБ | ❌ Не поміщається |
🔗 Джерела: сторінки моделей у бібліотеці Ollama, зведення розмірів у NeedToKnowIT, розміри Gemma 4 в iTechGuides.
Теги й розміри в Ollama оновлюються, тому перед завантаженням перевірте сторінку моделі.
Практичне правило для 8 ГБ:
- ✔️ Комфортна зона: моделі до ~3,5 ГБ на диску (1–4B параметрів у Q4_K_M) — залишається простір для IDE та браузера
- ✔️ Робоча зона: моделі 5–5,5 ГБ (7–8B у Q4_K_M) — потрібно закрити все зайве
- ❌ Червона зона: усе, що важить понад ~6 ГБ, і моделі 13B+ — зависання або swap на диск
⚠️ Особливість Mac: на Apple Silicon пам'ять unified, але macOS за замовчуванням віддає GPU лише частину
(на Mac із 8 ГБ це приблизно 5–5,5 ГБ). Якщо модель більша, Ollama частину шарів переносить на CPU, і швидкість різко падає.
Висновок: Перед вибором моделі закрий браузер, перевір
ollama ps і подивись реальний залишок пам'яті.
На 8 ГБ кожен гігабайт на вагу золота.
🎯 Для коду: яка модель замінить Copilot на 8 ГБ
Автодоповнення коду
Для автодоповнення коду на 8 ГБ найкращі варіанти у 2026 — Qwen3.5 4B, Qwen3 4B або
Phi-4 Mini (3,8B) у квантизації Q4_K_M. Qwen3.5 4B — найсвіжіша з трьох, з мультимодальністю
і великим контекстом, але й найважча (3,4 ГБ). Qwen3 4B та Phi-4 Mini важать по 2,5 ГБ.
GitHub Copilot коштує $10/місяць. Локальна модель для коду —
$0/місяць і працює офлайн. Питання лише в тому, яка модель
потягне на твоєму залізі.
Кодинг — задача, де навіть маленькі моделі можуть бути корисними.
Автодоповнення, генерація функцій, пояснення коду, написання тестів —
для цього не потрібна GPT-4, потрібна швидка і точна модель,
яка розуміє синтаксис.
Топ моделей для коду на 8 ГБ
1. Qwen3.5 4B (Q4_K_M) — ~3,4 ГБ
Вийшов у березні 2026 у складі малої серії Qwen3.5 (0.8B, 2B, 4B, 9B).
Модель нативно мультимодальна (текст, зображення), підтримує thinking mode
і tool calling, а контекстне вікно 256K токенів покриває більшість реальних
кодових баз. Ліцензія Apache 2.0 — безкоштовно для комерційного використання.
Це універсальна модель, а не вузькоспеціалізований кодер, тому для чистого коду
розглянь і наступний варіант.
ollama pull qwen3.5:4b
ollama run qwen3.5:4b "Напиши функцію сортування масиву на Python"
⚠️ Про thinking mode: у reasoning-режимі модель спочатку генерує «роздуми»,
через що відповідь довша і повільніша. Для автодоповнення та простих запитів
його краще вимикати. У Ollama thinking керується прапорцем --think
або командою /set nothink у чаті, а в моделях Qwen3 також працюють
текстові перемикачі /think і /no_think у промпті.
2. Qwen3 4B (Q4_K_M) — ~2,5 ГБ
Вийшов у квітні 2025 року і досі лишається надійним вибором: легший за Qwen3.5 4B на ~0,9 ГБ,
що на 8 ГБ відчутно. За даними Ollama Library,
за якістю відповідей він наближається до значно більших моделей попереднього покоління.
Якщо мультимодальність не потрібна, а пам'ять дорога, це оптимальний баланс.
ollama pull qwen3:4b
ollama run qwen3:4b "Знайди помилку у цьому Java-коді: ..."
3. Phi-4 Mini (3.8B) — ~2,5 ГБ
Компактна модель від Microsoft з 128K контексту. За даними
SitePoint,
вона комфортно працює на системах із 8 ГБ, зокрема на MacBook Air з M1.
Добре справляється з автодоповненням, простими поясненнями та легкими чат-задачами.
ollama pull phi4-mini
ollama run phi4-mini "Поясни різницю між HashMap і TreeMap у Java"
4. Qwen2.5-Coder 1.5B або 3B — для фонового автодоповнення
Якщо потрібно, щоб модель працювала у фоні разом із VS Code, браузером і терміналом,
обирай найлегші спеціалізовані кодові моделі. Серія Qwen2.5-Coder має версії 1.5B (~1 ГБ) і 3B (~2 ГБ)
і створена саме для inline-автодоповнення. Це сучасніша заміна старому deepseek-coder:1.3b
(2023 рік), який я рекомендував у попередній версії.
ollama pull qwen2.5-coder:3b
# ще легший варіант
ollama pull qwen2.5-coder:1.5b
Що обрати?
- Qwen2.5-Coder 1.5B / 3B — автодоповнення у фоні, робота з відкритим браузером
- Qwen3 4B — генерація функцій і пояснення коду при мінімальному розмірі
- Qwen3.5 4B — те саме плюс аналіз скріншотів UI та довгі контексти
- Phi-4 Mini — універсальна модель для коду та текстових задач
Висновок: На 8 ГБ можна кодити з локальним AI.
Не чекай якості GPT-4 — але для щоденного автодоповнення, генерації
бойлерплейту і пояснень коду цього більш ніж достатньо.
А от Qwen3.5 4B після перевірки розмірів виявився важчим, ніж я писав раніше (3,4 ГБ, а не 2,5),
тому на 8 ГБ вибір між ним і Qwen3 4B залежить від того, скільки пам'яті ви готові віддати.
🎯 Для тексту і спілкування: чат, переклад
Для текстових задач
Для текстових задач на 8 ГБ оптимальний вибір — Llama 3.2 3B для загального
чату, Gemma 3 4B для мультимодальності та багатомовності, або Phi-4 Mini
якщо потрібна аналітика і робота на CPU. Всі три залишають місце для іншого
софту і стабільно працюють без апгрейду заліза.
Не кожна задача вимагає GPT-4. Резюмувати текст,
відповісти на питання, переказати статтю — з цим справляється
модель, яка важить менше ніж один фільм у 4K.
Текстові задачі — найширша категорія: від простого чату до аналізу
документів і перекладу. На 8 ГБ тут є з чого обирати.
Якщо ти вже завантажив qwen3:4b чи qwen3.5:4b з попереднього розділу —
вони чудово справляються і з текстовими задачами. Але якщо шукаєш спеціалізовану
рекомендацію саме для тексту, ось актуальний список.
🇺🇦 Якщо пишеш українською. Не всі малі моделі однаково добре працюють з українською.
Наприклад, Llama 3.2 офіційно підтримує 8 мов (англійська, німецька, французька, італійська,
португальська, гінді, іспанська, тайська), і української серед них немає.
Qwen3 та Gemma заявляють підтримку 100+ мов, зокрема української. Перед тим як обрати модель для щоденної роботи,
дай їй кілька своїх типових текстів і порівняй результат.
Топ моделей для тексту на 8 ГБ
1. Llama 3.2 3B (Q4_K_M) — ~2 ГБ
За даними
StudyHUB,
Llama 3.1/3.2 — найпопулярніша модель на Ollama з понад 111 мільйонами
завантажень. Версія 3B — полегшена, але зберігає якість у загальних
розмовах, резюмуванні і відповідях на питання. Це найлегша модель з нашого списку.
Для порівняння: Llama 4 Scout, яка вийшла у 2025 році, важить близько 67 ГБ в Ollama
(MoE-модель із 17B активних параметрів), тож для 8 ГБ вона не підходить.
У сімействі Llama на 8 ГБ найкращим вибором залишається 3.2 3B.
ollama pull llama3.2:3b
ollama run llama3.2:3b "Перекажи основну думку цього тексту: ..."
2. Gemma 3 4B (Q4_K_M) — ~3,3 ГБ
Модель від Google DeepMind, яка приймає текст і зображення та заявляє підтримку
понад 140 мов. На 8 ГБ вона поміщається, залишаючи простір для IDE та браузера.
Це хороший вибір, якщо потрібні мультимодальність і багатомовність, зокрема українська.
ollama pull gemma3:4b
ollama run gemma3:4b "Склади короткий опис для цього товару: ..."
⚠️ А як же Gemma 4? Нове покоління Gemma 4 (квітень 2026) мультимодальне, з thinking mode і 128K контексту,
але стандартні теги в Ollama значно важчі: gemma4:e2b — 7,2 ГБ, а gemma4:e4b (тег за замовчуванням) — 9,6 ГБ.
На 8 ГБ вони не поміщаються. Є квантизовані QAT-версії, які за повідомленнями важать близько 4,3 ГБ (e2b),
але перед завантаженням перевір актуальні теги на сторінці Gemma 4.
Детальніше про Gemma 4 —
у статті Gemma 4: повний огляд — розміри, ліцензія, Ollama
та про thinking mode —
Reasoning mode в Gemma 4: як вмикати, коли потрібно і скільки коштує.
3. Phi-4 Mini (3.8B) — ~2,5 ГБ
Одна з небагатьох 3–4B моделей із вікном контексту 128K токенів,
що дозволяє аналізувати довгі документи. За даними
PromptQuorum,
вона добре працює на CPU без дискретної графіки, тому підходить для ноутбуків
без GPU і навіть Raspberry Pi 4/5. Якість української перевіряй на власних прикладах.
ollama pull phi4-mini
ollama run phi4-mini "Переклади українською: The quick brown fox jumps over the lazy dog"
Що обрати?
- ✔️ Найлегший варіант для загального чату → Llama 3.2 3B
- ✔️ Мультимодальність (текст + зображення) і багатомовність → Gemma 3 4B
- ✔️ Аналітика, довгі документи і CPU-only → Phi-4 Mini
- ✔️ Один інструмент для коду і тексту → Qwen3 4B або Qwen3.5 4B (див. попередній розділ)
Висновок: Для текстових задач 8 ГБ — комфортна
територія. Моделі 2–4B працюють швидко, залишають простір для інших
програм і дають якість, достатню для більшості щоденних потреб.
Головне правило: обирай за розміром тегу в Ollama, а не за красивою назвою нового покоління.
🎯 Для reasoning, логіка, дебаг коду
Для задач, що вимагають покрокового мислення — математика, логічні задачі,
дебаг складного коду — на 8 ГБ є три реальних варіанти: DeepSeek R1 8B
як класична «думаюча» модель, Qwen3 8B для мультимовного reasoning,
і Phi-4 Mini Reasoning як легший варіант із chain-of-thought.
Звичайна модель відповідає одразу. Reasoning-модель
спочатку думає — крок за кроком — а потім відповідає.
Як різниця між «відповісти навмання» і «порахувати на папері».
Reasoning-моделі — відносно нова категорія. Вони працюють за принципом
chain-of-thought: розбивають задачу на кроки, перевіряють проміжні
результати, і лише потім формують фінальну відповідь.
Reasoning-режим тепер є не тільки у важких 8B-моделях, але й у компактних 3–4B варіантах.
Що працює на 8 ГБ
1. DeepSeek R1 8B (Q4_K_M) — ~5,2 ГБ
За даними
StudyHUB,
на задачах з математикою, логічними пазлами і технічним reasoning ця модель
дає результати кращі за Llama 3.1 того ж розміру. Важливо: це не оригінальна DeepSeek R1, а дистильована версія —
reasoning-навички великої моделі перенесено на меншу. Перед фінальною відповіддю вона генерує видимі кроки міркування
у тегах <think> — корисно для дебагу, щоб зрозуміти,
чому модель дійшла саме до такого висновку. Компроміс: відповідає повільніше
і потребує майже всієї доступної пам'яті на 8 ГБ системі.
ollama pull deepseek-r1:8b
ollama run deepseek-r1:8b "Знайди помилку у цьому SQL-запиті: SELECT * FROM users WHERE id = '5' AND active = true GROUP HAVING count > 1"
⚠️ Важливо: DeepSeek R1 8B займає ~5,2 ГБ на диску, тож на системі з 8 ГБ це на межі —
потрібно закрити браузер, IDE і все зайве. На macOS з unified memory працює стабільніше, ніж на Windows
з інтегрованою графікою.
2. Qwen3 8B (Q4_K_M) — ~5,2 ГБ
За даними
LocalLLM.in,
Qwen3 8B — сильна альтернатива для reasoning-задач, особливо у математиці
і мультимовних сценаріях. Підтримує thinking mode: його можна вмикати
і вимикати без перезавантаження моделі (/think та /no_think у промпті).
Не плутайте її з qwen3.5:9b: ця модель важить 6,6 ГБ і на 8 ГБ не поміщається,
вона для систем із 16 ГБ.
ollama pull qwen3:8b
ollama run qwen3:8b "Розв'яжи: якщо 3x + 7 = 22, чому дорівнює x?"
3. Phi-4 Mini Reasoning (3.8B) — ~3 ГБ
Спеціалізований reasoning-варіант від Microsoft, розроблений для
багатокрокового розв'язання математичних задач у пам'яттєво-обмежених
середовищах: символьні обчислення, формальні докази, складні текстові умови.
За даними
Morph,
це одна з небагатьох reasoning-моделей, яка залишає простір для паралельної роботи IDE та браузера.
На відміну від DeepSeek R1 8B — займає майже вдвічі менше пам'яті і залишає
систему відзивчивою. На складних задачах поступається 8B-моделям,
але на щоденному дебазі та аналітиці цього достатньо.
ollama pull phi4-mini-reasoning
ollama run phi4-mini-reasoning "Знайди складність алгоритму і поясни покроково: ..."
Що обрати?
- ✔️ Дебаг коду і логічні задачі → DeepSeek R1 8B
- ✔️ Математика і мультимовний reasoning → Qwen3 8B
- ✔️ Reasoning з відкритим IDE і браузером → Phi-4 Mini Reasoning (~3 ГБ)
Висновок: Reasoning на 8 ГБ — вже не тільки
«на межі комфорту». Phi-4 Mini Reasoning дозволяє отримати покрокове
мислення при ~3 ГБ — без необхідності закривати все зайве.
Для складніших задач DeepSeek R1 8B і Qwen3 8B залишаються стандартом,
але вимагають майже всієї доступної пам'яті. Якщо плануєш регулярно
працювати з важкими reasoning-задачами — апгрейд до 16 ГБ відкриє
доступ до 14B-класу та Qwen3.5 9B, де різниця у якості вже суттєва.
🎯 CPU vs GPU vs Apple Silicon — де 8 ГБ це різні 8 ГБ
8 ГБ на Mac M1 і 8 ГБ на Windows-ноутбуці з Intel — це два різних досвіди.
Apple Silicon використовує unified memory, де вся пам'ять доступна і CPU,
і GPU одночасно. На звичайному ПК RAM і VRAM — окремі пули,
і для AI-моделей це критично.
Mac з 8 ГБ — найкращий варіант серед ноутбуків з такою пам'яттю.
Windows-ноутбук з 8 ГБ і Intel HD Graphics — це боротьба за кожен мегабайт.
Apple Silicon (M1/M2/M3/M4) — найкращий сценарій для 8 ГБ
На Apple Silicon вся оперативна пам'ять — unified memory.
Це означає, що GPU-частина чіпа має доступ до тих самих 8 ГБ,
що і CPU. Ollama автоматично використовує Metal для прискорення —
без додаткових налаштувань.
Орієнтовно, моделі 3–4B на M1 з 8 ГБ видають 15–25 токенів/сек, а 7–8B — 8–12 токенів/сек,
і то лише якщо модель повністю влізла в пам'ять (див. розділ 1 про ліміт GPU на Mac).
За даними
SitePoint,
Phi-4 Mini на M1 MacBook Air працює приблизно зі швидкістю 15–20 tok/s, чого достатньо
для щоденної роботи.
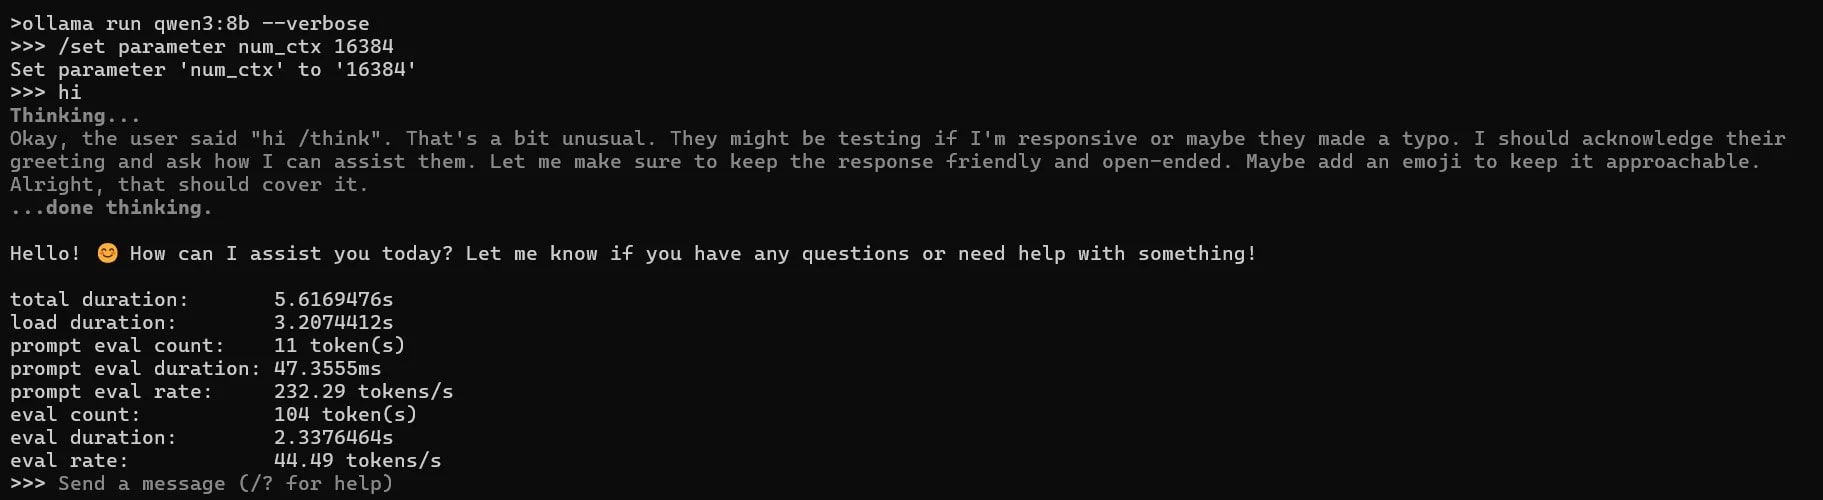
💡 Виміряй сам. Запусти модель з прапорцем --verbose:
ollama run phi4-mini --verbose. Після кожної відповіді Ollama покаже
eval rate — реальну швидкість генерації на твоєму залізі.
Це точніше за будь-які таблиці з інтернету.
⚠️ Примітка про MLX: наприкінці березня 2026 року Ollama 0.19 отримала
MLX-бекенд від Apple (поки як preview), який на великих моделях дає майже 2x приріст швидкості.
Але він розрахований на Mac із 32 ГБ+ unified memory: за даними
блогу Ollama
та гайду Switching to Mac,
Mac з 8 ГБ і 16 ГБ залишаються на попередньому llama.cpp + Metal без змін у швидкості.
Деталі цієї функції змінюються від релізу до релізу, тож перевіряй нотатки до свіжої версії Ollama.
Якщо плануєш апгрейд до Mac з 32 ГБ+ — MLX буде відчутним бонусом.
Windows / Linux з дискретним GPU (RTX 3060, RTX 4060) — хороший сценарій
Якщо є дискретна відеокарта з 6–8 ГБ VRAM — модель повністю
завантажується в GPU-пам'ять, і системна RAM залишається для ОС і софту.
За даними
LocalLLM.in,
на RTX 4060 (8 ГБ VRAM) 7B-модель видає 40+ токенів/сек —
найшвидший варіант із усіх. Головна умова: модель має поміститись у VRAM.
Якщо не поміщається, частина шарів піде на CPU, і швидкість різко впаде.
Перевіряй командою ollama ps: у стовпці Processor має бути 100% GPU.
Windows / Linux без GPU (Intel HD / AMD Radeon iGPU) — складний сценарій
Без дискретного GPU модель працює повністю на CPU. Ollama все одно
запуститься — але швидкість падає до 3–6 токенів/сек для 7B-моделей.
Для легших 3–4B моделей (Phi-4 Mini, Llama 3.2 3B) реальна швидкість
на сучасному CPU складає орієнтовно 8–12 tok/s — цілком прийнятно для щоденних задач.
За даними
LocalLLM.in,
CPU-only inference прийнятний для пакетних задач, але фруструє
при інтерактивному використанні з великими моделями.
Плюс системна RAM ділиться між ОС, софтом і моделлю — на 8 ГБ
це дуже тісно.
Зведена таблиця
Значення орієнтовні, зібрані зі сторонніх тестів. Реальна швидкість залежить від чипа, контексту та фонових процесів.
| Платформа |
7–8B модель (Q4) |
3–4B модель (Q4) |
Орієнтовна швидкість |
Комфорт |
| Mac M1/M2/M3/M4 8 ГБ (Metal) |
⚠️ На межі |
✔️ Комфортно |
3–4B: 15–25 tok/s; 7–8B: 8–12 tok/s |
⭐⭐⭐⭐ |
| Windows + RTX 4060 8 ГБ VRAM |
✔️ Працює швидко |
✔️ Комфортно |
40+ tok/s |
⭐⭐⭐⭐⭐ |
| Windows/Linux CPU only 8 ГБ |
⚠️ На межі |
✔️ Працює |
7–8B: 3–6 tok/s; 3–4B: 8–12 tok/s |
⭐⭐–⭐⭐⭐ |
Висновок: Якщо у тебе Mac M1+ з 8 ГБ — ти у
найкращій позиції для локального AI на бюджетному залізі, а моделі 3–4B
працюватимуть цілком комфортно. MLX-бекенд Ollama поки націлений на Mac з 32 ГБ+,
тож для 8 ГБ швидкість залишається такою, як є. Якщо Windows без GPU — фокусуйся на 3–4B моделях:
вони залишають систему відзивчивою. Детальніше про встановлення на різних ОС —
у статті Як встановити Ollama на Mac, Windows і Linux.
🎯 Квантизація простими словами: Q4 vs Q8 і що обрати на слабкому залізі
Коротка відповідь:
Квантизація — це стиснення моделі, яке зменшує її розмір у 2–4 рази
з мінімальною втратою якості. На 8 ГБ оптимальний вибір — Q4_K_M:
найкращий баланс між розміром, швидкістю і якістю відповідей.
Квантизація — це як JPEG для фото. Файл менший,
різниця майже непомітна. Але якщо стиснути занадто сильно —
якість помітно впаде.
Коли ти бачиш у назві моделі на Ollama теги типу :7b-q4_0,
:8b-instruct-q8_0 або :3b-q4_k_m — це позначення
рівня квантизації. Число після «q» — кількість біт на один параметр.
Для більшості моделей тег за замовчуванням в Ollama — це вже Q4_K_M,
тож додатково нічого вказувати не потрібно.
Рівні квантизації: що означають теги
- ✔️ Q8 (8-біт): максимальна якість, найбільший розмір. Для 7B-моделі — ~8 ГБ. На 8 ГБ RAM не влізе.
- ✔️ Q5_K_M (5-біт): проміжний варіант між Q4 і Q8. Для 7B — ~5.5 ГБ. На 8 ГБ RAM підходить лише якщо є GPU з 6–8 ГБ VRAM і потрібна вища точність.
- ✔️ Q4_K_M (4-біт, K-quant medium): оптимальний баланс. Для 7B — ~4–5 ГБ. Рекомендований для 8 ГБ систем.
- ✔️ Q4_K_S (4-біт, K-quant small): трохи менший за Q4_K_M, трохи нижча якість.
- ✔️ IQ4_XS (importance matrix, 4-біт): новіший формат. За даними
RunAIHome,
дає майже таку саму якість як Q4_K_M, але займає на ~400 МБ менше для 8B-моделі.
Корисний коли Q4_K_M ледь не влазить. Доступний як тег на Hugging Face,
не завжди присутній в Ollama Library.
- ✔️ QAT-версії: деякі моделі (наприклад, у сімействі Gemma) мають варіанти, навчені
з урахуванням квантизації. Якщо для потрібної моделі є тег із позначкою
qat,
порівняй його з Q4_K_M за розміром і якістю.
- ⚠️ Q2_K (2-біт): мінімальний розмір (~2.5 ГБ для 7B), але помітна деградація якості. Крайній варіант.
Суфікс «K» означає новіші методи квантизації (K-quant), які розумніше
розподіляють точність між шарами моделі. K-quant-теги завжди кращі за
legacy-варіанти (q4_0, q4_1) при тому самому розмірі.
Скільки важать моделі різних квантизацій
Розмір Q4_K_M — це реальні розміри тегів за замовчуванням з бібліотеки Ollama,
Q8 і Q2_K — орієнтовні оцінки.
| Модель |
Q8 (орієнтовно) |
Q4_K_M (Ollama) |
Q2_K (орієнтовно) |
| Llama 3.2 (3B) |
~3.4 ГБ |
2.0 ГБ |
~1.2 ГБ |
| Phi-4 Mini (3.8B) |
~4.1 ГБ |
2.5 ГБ |
~1.5 ГБ |
| Qwen3 8B |
~9 ГБ |
5.2 ГБ |
~3 ГБ |
| Mistral 7B |
~8 ГБ |
~4.1–4.4 ГБ |
~2.8 ГБ |
Джерела: бібліотека Ollama,
LocalAIMaster,
RunAIHome.
Увага: у деяких нових моделей тег за замовчуванням не Q4_K_M, а важчий (як у Gemma 4, див. розділ 3),
тому завжди дивись на реальний розмір тегу.
Правило для 8 ГБ: завжди обирай Q4_K_M. Якщо не влазить — знижуй
розмір моделі (3B замість 7B), а не рівень квантизації (Q2 замість Q4).
Менша модель з Q4 дасть кращу якість, ніж більша з Q2.
Виняток: якщо Q4_K_M буквально не влазить на 100–400 МБ — спробуй IQ4_XS,
якщо такий тег є для потрібної моделі на Hugging Face.
Детальніше про техніки стиснення і їхній вплив на якість — у нашій статті про квантизацію моделей (INT4, INT8).
Висновок: Q4_K_M — золотий стандарт для 8 ГБ і не втратив актуальності.
Не піддавайся спокусі завантажити Q8 «для якості» — модель
не влізе в пам'ять і ти отримаєш swap на диск. Альтернативи на горизонті —
IQ4_XS та QAT-версії: трохи менший розмір чи краща якість, але не для кожної моделі.
🎯 Налаштування Ollama для максимуму на слабкому залізі
Кілька змінних середовища і одна звичка (закривати зайве) — це все,
що потрібно, щоб вичавити максимум із 8 ГБ. Налаштування займає
кілька хвилин, а різниця у стабільності — відчутна.
На потужному залізі Ollama «просто працює».
На слабкому — потрібно допомогти їй не витрачати пам'ять на те,
що тобі не потрібно.
За замовчуванням Ollama використовує контекстне вікно 4096 токенів,
може тримати в пам'яті до трьох моделей одночасно і обробляє один паралельний запит на модель.
На 8 ГБ тримати кілька моделей — зайва розкіш. Ось, що варто налаштувати:
| ⚙️ Змінна |
📝 За замовчуванням |
🎯 Що робити на 8 ГБ |
OLLAMA_MAX_LOADED_MODELS |
3 (на CPU) |
Поставити 1, щоб не тримати зайві моделі в пам'яті |
OLLAMA_NUM_PARALLEL |
1 |
Залишити 1: пам'ять множиться на кількість паралельних запитів та розмір контексту |
OLLAMA_CONTEXT_LENGTH |
4096 |
2048–4096. Для reasoning-моделей краще не менше 4096 |
OLLAMA_FLASH_ATTENTION |
на розсуд Ollama |
1 (потрібен для квантизації KV-кешу) |
OLLAMA_KV_CACHE_TYPE |
f16 |
q8_0: приблизно вдвічі менше пам'яті на KV-кеш |
OLLAMA_KEEP_ALIVE |
5 хвилин |
Можна зменшити до 1–2 хвилин, щоб модель швидше вивантажувалась із пам'яті |
🔗 Джерела: документація Ollama (FAQ),
DEV Community,
SSD Nodes.
Базові змінні середовища
# Тримати в пам'яті лише одну модель
export OLLAMA_MAX_LOADED_MODELS=1

# Один паралельний запит (це значення за замовчуванням, фіксуємо для надійності)
export OLLAMA_NUM_PARALLEL=1

# Контекстне вікно: 2048 для простих задач, 4096 для reasoning
export OLLAMA_CONTEXT_LENGTH=2048
⚠️ Увага: у попередній версії статті я вказував змінну OLLAMA_CTX_SIZE.
Такої змінної в документації Ollama немає, правильна назва — OLLAMA_CONTEXT_LENGTH.
Якщо ти встановлював стару, налаштування не працювало.
Змінні для економії KV-кешу (GPU і Apple Silicon)
Якщо запускаєш Ollama на GPU (NVIDIA, AMD) або Apple Silicon (M1+) —
додатково встанови ці дві змінні. Вони існують з кінця 2024 року
і зменшують KV-кеш приблизно вдвічі без помітної втрати якості для більшості задач.
# Flash Attention — обов'язкова передумова для квантизації KV-кешу
export OLLAMA_FLASH_ATTENTION=1

# KV-кеш у 8-біт — приблизно вдвічі менше пам'яті на кеш
export OLLAMA_KV_CACHE_TYPE=q8_0
⚠️ Важливо: OLLAMA_KV_CACHE_TYPE працює лише якщо увімкнено
OLLAMA_FLASH_ATTENTION=1. За даними
SSD Nodes,
q8_0 економить приблизно половину пам'яті порівняно з f16, а q4_0 — приблизно чверть,
але q4_0 може помітно погіршити якість, тому для 8 ГБ достатньо q8_0.
Квантизація кешу може трохи знизити швидкість генерації. Якщо після її ввімкнення
якась модель не завантажується, першим підозрюй OLLAMA_KV_CACHE_TYPE
і спробуй її прибрати. Для CPU-only систем ці змінні користі не дадуть.
Де встановлювати змінні
- 🍎 macOS (застосунок Ollama): через
launchctl setenv ІМ'Я значення, потім перезапусти Ollama. Рядки в ~/.zshrc спрацюють лише якщо запускаєш сервер вручну командою ollama serve з терміналу
- 🐧 Linux (systemd): у
systemctl edit ollama.service додай рядки Environment="ІМ'Я=значення" у секцію [Service] і перезапусти сервіс
- 🪟 Windows: задай змінні користувача або системні змінні середовища й перезапусти Ollama із системного трея
Контекст можна змінити й без змінних середовища: у чаті командою /set parameter num_ctx 4096
або параметром num_ctx у Modelfile.
Перед запуском моделі
Звучить банально, але на 8 ГБ це критично:
- ✔️ Закрий браузер або залиш максимум 2–3 вкладки
- ✔️ Закрий Slack, Discord, Spotify — кожна програма з'їдає 200–500 МБ
- ✔️ Перевір поточне використання:
ollama ps покаже завантажені моделі та частку GPU/CPU
- ✔️ Якщо стара модель ще в пам'яті —
ollama stop назва_моделі
Modelfile для тонкого налаштування
Якщо хочеш більше контролю — створи Modelfile з оптимізованими параметрами:
FROM phi4-mini
PARAMETER num_ctx 2048
PARAMETER num_thread 4
PARAMETER temperature 0.7
Збережи файл як Modelfile і створи власну версію моделі:
ollama create phi4-mini-lite -f Modelfile
ollama run phi4-mini-lite
num_ctx 2048 — зменшує вікно контексту (менше RAM на KV-кеш).
num_thread 4 — обмежує кількість потоків CPU, щоб система
залишалася відзивчивою. Це параметр Modelfile, а не змінна середовища.
Покроковий гайд по встановленню і першому запуску —
у статті Як встановити Ollama на Mac, Windows і Linux: повний гайд 2026.
Висновок: Одна модель у пам'яті + розумний контекст + закриті зайві програми =
стабільна робота на 8 ГБ. Якщо є GPU або Apple Silicon — додай
OLLAMA_FLASH_ATTENTION=1 і OLLAMA_KV_CACHE_TYPE=q8_0:
за документацією Ollama це приблизно вдвічі зменшує пам'ять на KV-кеш.
Без базових налаштувань навіть легка модель може спричинити swap на диск.
🎯 Що НЕ варто пробувати на 8 ГБ
Коротка відповідь:
Моделі 13B+, будь-які моделі у Q8-квантизації, спроби тримати дві
моделі одночасно і MoE-моделі з великим загальним розміром — гарантоване розчарування на 8 ГБ.
Ось типові пастки, з якими стикається майже кожен, хто пробує локальний AI на такому залізі.
Кожен, хто працював з Ollama на 8 ГБ, проходить через один
і той самий етап: «А може 14B все-таки влізе?» Ні, не влізе.
❌ Моделі 13–14B і більші
Qwen3 14B (9,3 ГБ у бібліотеці Ollama), DeepSeek R1 14B (9 ГБ), CodeLlama 13B —
навіть у Q4-квантизації вони потребують 8–9 ГБ лише на ваги моделі.
Додай KV-кеш і ОС, і ти отримаєш систему, яка безперервно свопить на диск:
завантаження займає хвилини, а швидкість падає до 1–2 токенів на секунду з постійними паузами.
Це непрацездатно для інтерактивного використання.
❌ Будь-яка 7B-модель у Q8-квантизації
Q8-версія 7B-моделі важить близько 8 ГБ — це вся твоя оперативна
пам'ять. ОС не зникає магічно, тому система зависає або починає свопити.
Завжди використовуй Q4_K_M для 7B-моделей на 8 ГБ.
❌ Дві моделі одночасно
За замовчуванням Ollama може тримати кілька моделей у пам'яті (до трьох). На 16 ГБ це зручно —
переключаєшся між моделями миттєво. На 8 ГБ це рецепт для swap-шторму.
Тримай OLLAMA_MAX_LOADED_MODELS=1 і не забувай
ollama stop перед завантаженням іншої моделі.
❌ Великі контекстні вікна (8K+ токенів)
Кожне подвоєння контекстного вікна — це додаткові сотні мегабайт
на KV-кеш. На 8 ГБ тримай контекст 4096 токенів максимум (це й так значення за замовчуванням).
Передати модель 10-сторінковий документ цілком — не вийде,
потрібно розбивати на частини.
Частково допомагає OLLAMA_FLASH_ATTENTION=1 +
OLLAMA_KV_CACHE_TYPE=q8_0 з розділу про налаштування —
вони зменшують KV-кеш приблизно вдвічі. Але 8K+ на 8 ГБ лишається зоною ризику.
❌ MoE-моделі з великим загальним розміром (Mixtral, Llama 4 Scout, Qwen3.5/3.6 35B-A3B)
MoE-архітектура (Mixture of Experts) вводить в оману назвами.
Mixtral 8x7B активує лише 2 з 8 «експертів» на кожен токен —
але всі 8 мають бути в пам'яті одночасно, і це 26+ ГБ у Q4.
Llama 4 Scout (2025 рік) виглядає як «17B», але в бібліотеці Ollama
її тег llama4:16x17b важить близько 67 ГБ.
Моделі на кшталт Qwen 35B-A3B активують лише 3B параметрів на токен,
але тримають у пам'яті всі 35B — це 20+ ГБ у Q4. Правило просте: дивись на загальний
розмір тегу в Ollama Library, а не на кількість активних параметрів.
❌ Thinking mode з крихітним контекстом
Qwen3 8B, Qwen3.5 4B і Phi-4 Mini Reasoning генерують «thinking tokens»
перед фінальною відповіддю — інколи тисячі токенів внутрішніх міркувань.
Ці токени теж займають місце в контексті. На складних задачах thinking chain може зайняти 2000–5000 токенів
ще до того, як модель почне відповідати. Якщо контекст замалий, міркування обривається
або відповідь виходить порожньою чи обрізаною; якщо великий — зростає KV-кеш і модель сповільнюється.
Рішення: для reasoning-задач тримай контекст не менше 4096 і вимикай thinking
для простих запитів (прапорцем --think=false, командою /set nothink
або перемикачем /no_think у моделях Qwen3).
Загальне правило: якщо ollama run
завантажується довше 30 секунд і перша відповідь приходить через
хвилину — модель занадто велика для твоєї системи. Не чекай, що
«розігріється» — закрий і візьми модель меншого розміру.
Порівняння моделей за розміром, якістю і задачами —
у статті Топ-10 моделей Ollama у 2026: яку вибрати.
Висновок: Типова історія виглядає так: людина думає, що більша
модель дасть кращий результат, завантажує 13–14B, чекає хвилину на першу
відповідь і видаляє. Після переходу на 3–4B продуктивність одразу зростає.
На 8 ГБ краща стратегія — обрати модель, яка працює швидко і стабільно,
ніж мучитися з тією, що «майже влазить». До класичних пасток додалась ще одна —
thinking mode: нові моделі думають вголос і тихо з'їдають
твій контекст ще до першого слова відповіді.
🎯 Орієнтовна швидкість: чого очікувати на практиці
Коротка відповідь:
На Mac M1 з 8 ГБ моделі 3–4B видають приблизно 15–28 токенів/сек, а 7–8B — 8–12 tok/s.
На CPU-only Windows-ноутбуці вдвічі-втричі повільніше для великих моделей,
але 3–4B-моделі на сучасних CPU дають 8–12 tok/s — цього вже достатньо для комфортної роботи.
Нижче — зведена таблиця для орієнтації.
Бенчмарки в інтернеті часто зроблені на чистій системі без
іншого софту. У реальності — з відкритим VS Code і 5 вкладками Chrome —
цифри будуть нижчі.
⚠️ Чесно про джерела цифр. Це не мої власні виміри, а зведення з відкритих тестів
(LocalLLM.in, SitePoint, LocalAIMaster). Їх варто сприймати як діапазони для орієнтації. Нижче я показую,
як за дві хвилини виміряти реальну швидкість на твоєму залізі.
Зведена таблиця продуктивності
| Модель |
Розмір в Ollama |
Mac M1 8 ГБ |
CPU-only 8 ГБ |
RTX 4060 8 ГБ VRAM |
| Llama 3.2 3B (Q4) |
2,0 ГБ |
~25–28 tok/s |
~9–12 tok/s |
~45–50 tok/s |
| Phi-4 Mini 3.8B (Q4) |
2,5 ГБ |
~18–22 tok/s |
~10–12 tok/s |
~42–45 tok/s |
| Qwen3.5 4B (Q4) |
3,4 ГБ |
~18–21 tok/s |
~6–8 tok/s |
~40–42 tok/s |
| Qwen3 8B (Q4) |
5,2 ГБ |
~9–11 tok/s |
~3–5 tok/s |
~35–38 tok/s |
| DeepSeek R1 8B (Q4) |
5,2 ГБ |
~8–10 tok/s |
~3 tok/s |
~33–35 tok/s |
Дані орієнтовні, зібрані з
LocalLLM.in,
SitePoint
та LocalAIMaster.
Реальна швидкість залежить від навантаження системи, розміру контексту
та фонових процесів. Для GPU і Apple Silicon ввімкнення
OLLAMA_FLASH_ATTENTION=1 може допомогти на довгих контекстах.
Gemma 4 E4B в таблиці немає свідомо: її стандартний тег (9,6 ГБ) на 8 ГБ не поміщається.
📏 Як виміряти швидкість на своєму залізі
ollama run phi4-mini --verbose
# після відповіді дивись рядок "eval rate: ... tokens/s" — це швидкість генерації

ollama ps
# у стовпці PROCESSOR має бути "100% GPU" (якщо є GPU) — інакше частина шарів на CPU
Рядок eval rate — це реальна швидкість генерації відповіді; prompt eval rate показує, як швидко модель обробляє твій запит.
Заміряй з тими програмами, які зазвичай відкриті (IDE, браузер), тоді цифри будуть чесними.
Що означають ці цифри на практиці?
- ✔️ 15+ tok/s: комфортний інтерактивний чат — відповідь з'являється швидше, ніж ти встигаєш прочитати
- ✔️ 8–15 tok/s: працювати можна, але відчувається затримка на довгих відповідях
- ⚠️ 3–6 tok/s: прийнятно для одноразових задач (дебаг, аналіз), фрустрація при активному чаті
- ❌ <3 tok/s: модель занадто велика для цієї системи
Висновок: Для щоденної роботи на 8 ГБ орієнтуйся
на 3–4B-моделі — вони дають 15–28 tok/s на Apple Silicon і 8–12 tok/s
на CPU, залишаючи систему відзивчивою. Phi-4 Mini виділяється
найкращим CPU-показником у своєму класі (~12 tok/s на сучасному i7) —
суттєво краще за Phi-3 Mini, яку вона замінила. 7–8B-моделі (Qwen3 8B, DeepSeek R1 8B) —
для конкретних задач, коли готовий закрити все зайве і почекати.
❓ Часті питання (FAQ)
Чи можна запустити Ollama на ноутбуці з 8 ГБ RAM?
Так. Моделі 1–4B параметрів (Phi-4 Mini, Llama 3.2 3B, Qwen3 4B)
працюють комфортно на будь-якій системі з 8 ГБ. Моделі 7–8B
працюють на межі — потрібно закрити зайві програми.
Детальніше — у
гайді зі встановлення Ollama.
Яка найкраща модель для 8 ГБ RAM?
Залежить від задачі. Для коду — Qwen3 4B (2,5 ГБ) або Qwen3.5 4B (3,4 ГБ).
Для тексту і чату — Llama 3.2 3B або Gemma 3 4B.
Для reasoning і дебагу — DeepSeek R1 8B (на межі 8 ГБ) або
Phi-4 Mini Reasoning (легший варіант з chain-of-thought).
Один інструмент для всього — Qwen3.5 4B: мультимодальний,
256K контекст, thinking mode, але важчий за Qwen3 4B.
Повне порівняння моделей —
у статті Топ-10 моделей Ollama у 2026.
Чи потрібен GPU для Ollama?
Ні, Ollama працює і на CPU. Але з GPU (дискретним або Apple Silicon)
швидкість вища в рази. На CPU-only системі з 8 ГБ
тримайся моделей 3–4B для комфортної роботи.
Phi-4 Mini — один із найкращих виборів для CPU-only: за результатами сторонніх тестів,
близько 12 tok/s на сучасному i7 без GPU.
Що краще: модель 7B у Q2 чи 3B у Q4?
Майже завжди — 3B у Q4. Агресивна квантизація (Q2) суттєво
знижує якість відповідей, особливо на складних задачах.
Менша модель з нормальною квантизацією дасть кращий результат.
Якщо Q4_K_M буквально не влазить на кілька сотень МБ —
спробуй IQ4_XS для тієї самої моделі, якщо такий тег є на Hugging Face.
Чи підтримують малі моделі українську мову?
По-різному. Llama 3.2 офіційно підтримує 8 мов, української серед них немає.
Qwen3 і Gemma заявляють підтримку 100+ мов, зокрема української.
Якість української в кожній моделі краще перевірити на власних текстах:
дай кілька типових запитів і порівняй відповіді.
Чи може Ollama на 8 ГБ замінити ChatGPT?
Для щоденних задач — резюмування, прості питання, генерація коду —
так. Для базової мультимодальності (аналіз зображень, скріншотів) —
теж: Gemma 3 4B і Qwen3.5 4B приймають зображення.
Для складного багатокрокового аналізу, роботи з великим контекстом
і завдань де потрібна максимальна точність — хмарні моделі поки сильніші.
Оптимальний підхід — гібридний:
Ollama для регулярних задач, ChatGPT/Claude для складних.
Детальніше —
у статті Ollama vs ChatGPT vs Claude: коли локальна AI краща.
Скільки місця на диску потрібно?
Одна 3–4B-модель у Q4 — приблизно 2–3,5 ГБ на диску. Три моделі для різних
задач — 7–9 ГБ. Ollama зберігає моделі у ~/.ollama,
завантажені моделі можна видалити командою ollama rm назва_моделі.
Чи варто апгрейдити до 16 ГБ?
Якщо плануєш регулярно працювати з локальним AI — однозначно так.
16 ГБ відкривають доступ до моделей 9–14B (Qwen3.5 9B на 6,6 ГБ, Qwen3 14B на 9,3 ГБ),
7B у вищій якості та комфортної роботи з великими контекстними вікнами.
MLX-бекенд Ollama поки націлений на Mac із 32 ГБ+, тож 16 ГБ його не відкриють.
Різниця у можливостях між 8 і 16 ГБ — найбільша у всьому спектрі.
✅ Висновки
8 ГБ оперативної пам'яті — це не вирок для локального AI,
але це межа, яка вимагає усвідомлених рішень. Ось головне:
- ✔️ 3–4B-моделі — зона комфорту: Phi-4 Mini, Llama 3.2 3B, Qwen3 4B, Qwen3.5 4B, Gemma 3 4B працюють швидко і стабільно, залишаючи місце для IDE та браузера
- ✔️ 7–8B-моделі — робоча зона: DeepSeek R1 8B, Qwen3 8B працюють на межі (по 5,2 ГБ), але дають відчутно кращу якість для конкретних задач
- ✔️ Q4_K_M — єдиний розумний вибір квантизації на 8 ГБ: менша модель з Q4 завжди краща за більшу з Q2
- ✔️ Apple Silicon з 8 ГБ — найкращий бюджетний варіант: unified memory дає перевагу над CPU-only системами
- ✔️ Не варто пробувати: моделі 13B+, Q8, дві моделі одночасно, MoE з великим загальним розміром і thinking mode без достатнього контексту
- ✔️ Дивись на розмір тегу, а не на назву: нові покоління на кшталт Gemma 4 мають важчі теги за замовчуванням, і на 8 ГБ вони не поміщаються
Я сам використовую саме такий підхід: тримаю кілька моделей
під різні задачі — одну для коду, іншу для тексту, окрему для дебагу.
Кожна модель має свою сильну сторону, і замість однієї великої,
яка може не влізти в пам'ять, краще мати 2–3 спеціалізовані легкі.
Перемикатися між ними через ollama run — справа секунд.
Якщо тільки починаєш —
встанови Ollama за
нашим гайдом,
завантаж phi4-mini і спробуй.
Через п'ять хвилин у тебе буде працюючий локальний AI —
без підписок, без інтернету, без передачі даних назовні.
А якщо тобі потрібен сайт, блог або веб-застосунок з інтеграцією
AI-функціональності —
напиши нам у WebsCraft,
допоможемо реалізувати.
📖 Джерела