¿Tienes un portátil con 8 GB de RAM y quieres ejecutar IA localmente?
Este artículo es un análisis: qué funciona, qué va justo
y qué ni vale la pena descargar. Sin ilusiones, con modelos concretos
y comandos para cada tarea. Si aún no conoces Ollama,
empieza con el artículo introductorio sobre qué es Ollama y por qué lo necesitan los desarrolladores.
Actualizado: octubre de 2026. He comprobado los tamaños de los modelos según la biblioteca de Ollama y he eliminado las recomendaciones que no caben en 8 GB.
📌 En resumen
- ✅ Cómodo en 8 GB: modelos que pesan hasta ~3,5 GB en disco: Llama 3.2 3B, Qwen3 4B, Phi-4 Mini, Qwen3.5 4B, Gemma 3 4B
- ⚠️ Al límite: Qwen3 8B y DeepSeek R1 8B (5,2 GB cada uno), es necesario cerrar el navegador y el IDE
- ❌ No aptos: Qwen3.5 9B (6,6 GB), Gemma 4 E2B y E4B por defecto (7,2 y 9,6 GB), cualquier modelo 13B+
- 💻 Para código: Qwen3.5 4B o Qwen3 4B. Para texto: Llama 3.2 3B, Gemma 3 4B o Phi-4 Mini. Para razonamiento: Phi-4 Mini Reasoning o DeepSeek R1 8B
- 🇺🇦 Si trabajas en ucraniano, comprueba la calidad con tus propios ejemplos: algunos modelos no lo admiten oficialmente
📚 Contenido del artículo
🎯 Cuánta RAM queda realmente para el modelo
Respuesta corta:
Con 8 GB de RAM, para el modelo de IA quedan disponibles realmente entre 3 y 5 GB.
El resto lo consume el sistema operativo, el navegador y los procesos en segundo plano.
Esto determina la regla principal: en 8 GB funcionan cómodamente los modelos que pesan
hasta 3–3,5 GB en disco (normalmente de 3–4B de parámetros con cuantización de 4 bits),
mientras que los modelos de 7–8B funcionan al límite.
8 GB de RAM no son 8 GB para el modelo.
Son 8 GB menos el SO, menos Chrome, menos todo lo que olvidaste cerrar.
Antes de elegir un modelo, es necesario entender el presupuesto real de memoria.
Esta es la distribución típica en un sistema con 8 GB de RAM:
- ✔️ Sistema operativo: 1.5–2.5 GB (macOS más cerca de 2.5, Windows — 2, Linux — 1.5)
- ✔️ Navegador (5–10 pestañas): 1–2 GB
- ✔️ IDE (VS Code / IntelliJ): 0.5–1.5 GB
- ✔️ Procesos en segundo plano: 0.3–0.5 GB
Resto para el modelo: 3–5 GB.
Según los datos de
LocalLLM.in,
un modelo de 7B parámetros con cuantización Q4_K_M ocupa aproximadamente 4–5 GB,
más 1–2 GB para la caché KV y la sobrecarga del sistema.
Esto significa que un modelo de 7B en 8 GB es posible, pero va al límite, y es mejor cerrar
todo lo innecesario.
📏 Tamaño en disco ≈ tamaño en memoria
El tamaño del modelo en la biblioteca de Ollama es casi igual al volumen de memoria que ocuparán sus pesos.
A esto se añade la caché KV (que crece junto con la ventana de contexto) y la memoria de servicio.
Por eso, no te fijes en el número de parámetros del nombre, sino en el tamaño real de la etiqueta.
Esto es lo que muestra la biblioteca de Ollama para los modelos que analizamos en el artículo:
| 🛠️ Modelo (etiqueta) |
💾 Tamaño en Ollama |
🚦 En 8 GB |
llama3.2:3b | 2,0 GB | ✅ Cómodo |
qwen3:4b | 2,5 GB | ✅ Cómodo |
phi4-mini | 2,5 GB | ✅ Cómodo |
gemma3:4b | 3,3 GB | ✅ Cómodo |
qwen3.5:4b | 3,4 GB | ✅ Cómodo, pero ya se nota |
qwen3:8b | 5,2 GB | ⚠️ Al límite |
deepseek-r1:8b | 5,2 GB | ⚠️ Al límite |
qwen3.5:9b | 6,6 GB | ❌ No cabe junto con el sistema |
gemma4:e2b | 7,2 GB | ❌ No cabe |
gemma4:e4b | 9,6 GB | ❌ No cabe |
🔗 Fuentes: páginas de modelos en la biblioteca de Ollama, recopilación de tamaños en NeedToKnowIT, tamaños de Gemma 4 en iTechGuides.
Las etiquetas y tamaños en Ollama se actualizan, así que comprueba la página del modelo antes de descargarlo.
Regla práctica para 8 GB:
- ✔️ Zona cómoda: modelos de hasta ~3,5 GB en disco (1–4B parámetros en Q4_K_M) — queda espacio para el IDE y el navegador
- ✔️ Zona de trabajo: modelos de 5–5,5 GB (7–8B en Q4_K_M) — es necesario cerrar todo lo demás
- ❌ Zona roja: todo lo que pesa más de ~6 GB, y modelos de 13B+ — bloqueos o intercambio (swap) en disco
⚠️ Particularidad de Mac: en Apple Silicon la memoria es unificada, pero macOS por defecto asigna a la GPU solo una parte
(en un Mac con 8 GB son aproximadamente 5–5,5 GB). Si el modelo es mayor, Ollama traslada parte de las capas a la CPU y la velocidad cae en picado.
Conclusión: Antes de elegir un modelo, cierra el navegador, comprueba
ollama ps y mira el resto de memoria real.
En 8 GB cada giga vale oro.
🎯 Para código: qué modelo sustituirá a Copilot en 8 GB
Autocompletado de código
Para el autocompletado de código en 8 GB, las mejores opciones en 2026 son Qwen3.5 4B, Qwen3 4B o
Phi-4 Mini (3,8B) con cuantización Q4_K_M. Qwen3.5 4B es la más reciente de las tres, con multimodalidad
y un gran contexto, pero también la más pesada (3,4 GB). Qwen3 4B y Phi-4 Mini pesan 2,5 GB cada una.
GitHub Copilot cuesta 10 $ al mes. Un modelo local para código cuesta
0 $ al mes y funciona offline. La única duda es qué modelo
irá bien en tu hardware.
La programación es una tarea donde incluso los modelos pequeños pueden ser útiles.
Autocompletado, generación de funciones, explicación de código, redacción de tests:
para esto no hace falta GPT-4, hace falta un modelo rápido y preciso
que entienda la sintaxis.
Top de modelos para código en 8 GB
1. Qwen3.5 4B (Q4_K_M) — ~3,4 GB
Lanzado en marzo de 2026 como parte de la serie pequeña Qwen3.5 (0.8B, 2B, 4B, 9B).
El modelo es nativamente multimodal (texto, imágenes), admite modo de razonamiento (thinking mode)
y llamada a herramientas (tool calling), y su ventana de contexto de 256K tokens cubre la mayoría de bases de código reales.
Licencia Apache 2.0: gratuito para uso comercial.
Es un modelo universal, no un codificador especializado, por lo que para código puro
considera también la siguiente opción.
ollama pull qwen3.5:4b
ollama run qwen3.5:4b "Escribe una función de ordenación de arrays en Python"
⚠️ Sobre el thinking mode: en el modo de razonamiento, el modelo genera primero «reflexiones»,
lo que hace que la respuesta sea más larga y lenta. Para el autocompletado y peticiones sencillas
es mejor desactivarlo. En Ollama el razonamiento se controla con el indicador --think
o el comando /set nothink en el chat, y en los modelos Qwen3 también funcionan
los conmutadores de texto /think y /no_think en el prompt.
2. Qwen3 4B (Q4_K_M) — ~2,5 GB
Lanzado en abril de 2025, sigue siendo una opción fiable: es ~0,9 GB más ligero que Qwen3.5 4B,
lo que en 8 GB se nota bastante. Según los datos de la Biblioteca de Ollama,
en calidad de respuestas se acerca a modelos considerablemente más grandes de la generación anterior.
Si no necesitas multimodalidad y la memoria es escasa, este es el equilibrio óptimo.
ollama pull qwen3:4b
ollama run qwen3:4b "Encuentra el error en este código Java: ..."
3. Phi-4 Mini (3.8B) — ~2,5 GB
Un modelo compacto de Microsoft con 128K de contexto. Según
SitePoint,
funciona cómodamente en sistemas con 8 GB, en particular en MacBook Air con M1.
Se maneja bien con el autocompletado, explicaciones sencillas y tareas de chat ligeras.
ollama pull phi4-mini
ollama run phi4-mini "Explica la diferencia entre HashMap y TreeMap en Java"
4. Qwen2.5-Coder 1.5B o 3B — para autocompletado en segundo plano
Si necesitas que el modelo funcione en segundo plano junto con VS Code, el navegador y el terminal,
elige los modelos de código especializados más ligeros. La serie Qwen2.5-Coder tiene versiones de 1.5B (~1 GB) y 3B (~2 GB)
y está creada específicamente para el autocompletado en línea (inline). Es un sustituto más moderno del antiguo deepseek-coder:1.3b
(de 2023), que recomendaba en la versión anterior.
ollama pull qwen2.5-coder:3b
# opción aún más ligera
ollama pull qwen2.5-coder:1.5b
¿Qué elegir?
- Qwen2.5-Coder 1.5B / 3B — autocompletado en segundo plano, trabajo con el navegador abierto
- Qwen3 4B — generación de funciones y explicación de código con tamaño mínimo
- Qwen3.5 4B — lo mismo más análisis de capturas de pantalla de UI y contextos largos
- Phi-4 Mini — modelo universal para código y tareas de texto
Conclusión: En 8 GB se puede programar con IA local.
No esperes la calidad de GPT-4, pero para el autocompletado diario, generación
de código repetitivo (boilerplate) y explicaciones de código es más que suficiente.
Por su parte, Qwen3.5 4B tras comprobar los tamaños resultó ser más pesado de lo que escribí antes (3,4 GB en lugar de 2,5),
así que en 8 GB la elección entre este y Qwen3 4B depende de cuánta memoria estés dispuesto a ceder.
🎯 Para texto y comunicación: chat, traducción
Para tareas de texto
Para tareas de texto en 8 GB, la opción óptima es Llama 3.2 3B para chat general,
Gemma 3 4B para multimodalidad y multilingüismo, o Phi-4 Mini
si necesitas análisis y trabajo en CPU. Los tres dejan espacio para otro
software y funcionan de manera estable sin actualizar el hardware.
No todas las tareas exigen GPT-4. Resumir texto,
responder a preguntas, sintetizar un artículo: de eso se encarga
un modelo que pesa menos que una película en 4K.
Las tareas de texto son la categoría más amplia: desde un chat sencillo hasta el análisis
de documentos y la traducción. En 8 GB hay dónde elegir.
Si ya has descargado qwen3:4b o qwen3.5:4b de la sección anterior,
se desenvuelven de maravilla también con tareas de texto. Pero si buscas una recomendación
especializada precisamente para texto, aquí tienes la lista actualizada.
🇺🇦 Si escribes en ucraniano. No todos los modelos pequeños funcionan igual de bien con el ucraniano.
Por ejemplo, Llama 3.2 admite oficialmente 8 idiomas (inglés, alemán, francés, italiano,
portugués, hindi, español, tailandés) y el ucraniano no está entre ellos.
Qwen3 y Gemma declaran compatibilidad con más de 100 idiomas, incluido el ucraniano. Antes de elegir un modelo para el trabajo diario,
pásale un par de tus textos típicos y compara el resultado.
Top de modelos para texto en 8 GB
1. Llama 3.2 3B (Q4_K_M) — ~2 GB
Según los datos de
StudyHUB,
Llama 3.1/3.2 es el modelo más popular en Ollama con más de 111 millones
de descargas. La versión 3B es ligera, pero mantiene la calidad en conversaciones
generales, resúmenes y respuestas a preguntas. Es el modelo más liviano de nuestra lista.
Como comparativa: Llama 4 Scout, lanzada en 2025, pesa unos 67 GB en Ollama
(es un modelo MoE con 17B de parámetros activos), por lo que no es apta para 8 GB.
Dentro de la familia Llama en 8 GB, la mejor opción sigue siendo la 3.2 3B.
ollama pull llama3.2:3b
ollama run llama3.2:3b "Resume la idea principal de este texto: ..."
2. Gemma 3 4B (Q4_K_M) — ~3,3 GB
Un modelo de Google DeepMind que acepta texto e imágenes y declara soporte para
más de 140 idiomas. En 8 GB cabe perfectamente, dejando espacio para el IDE y el navegador.
Es una buena opción si necesitas multimodalidad y multilingüismo, incluido el ucraniano.
ollama pull gemma3:4b
ollama run gemma3:4b "Redacta una breve descripción para este producto: ..."
⚠️ ¿Y qué pasa con Gemma 4? La nueva generación Gemma 4 (abril de 2026) es multimodal, con modo de razonamiento y 128K de contexto,
pero las etiquetas estándar en Ollama son considerablemente más pesadas: gemma4:e2b pesa 7,2 GB y gemma4:e4b (la etiqueta por defecto) pesa 9,6 GB.
En 8 GB no caben. Hay versiones QAT cuantizadas que según se informa pesan unos 4,3 GB (e2b),
pero antes de descargar comprueba las etiquetas actuales en la página de Gemma 4.
Más detalles sobre Gemma 4 en
el artículo Gemma 4: análisis completo: tamaños, licencia, comparativa con Gemma 3
y sobre el modo de razonamiento en
Reasoning mode en Gemma 4: cómo activarlo, cuándo es necesario y cuánto cuesta.
3. Phi-4 Mini (3.8B) — ~2,5 GB
Uno de los pocos modelos de 3–4B con una ventana de contexto de 128K tokens,
lo que permite analizar documentos largos. Según
PromptQuorum,
funciona bien en CPU sin gráfica discreta, por lo que es adecuado para portátiles
sin GPU e incluso para Raspberry Pi 4/5. Comprueba la calidad del ucraniano con tus propios ejemplos.
ollama pull phi4-mini
ollama run phi4-mini "Traduce al ucraniano: The quick brown fox jumps over the lazy dog"
¿Qué elegir?
- ✔️ La opción más ligera para chat general → Llama 3.2 3B
- ✔️ Multimodalidad (texto + imagen) y multilingüismo → Gemma 3 4B
- ✔️ Análisis, documentos largos y uso exclusivo en CPU → Phi-4 Mini
- ✔️ Una sola herramienta para código y texto → Qwen3 4B o Qwen3.5 4B (ver sección anterior)
Conclusión: Para tareas de texto, 8 GB es un territorio
cómodo. Los modelos de 2–4B funcionan rápido, dejan espacio para otras
aplicaciones y ofrecen una calidad suficiente para la mayoría de necesidades diarias.
La regla de oro: elige por el tamaño de la etiqueta en Ollama, no por el nombre atractivo de una nueva generación.
🎯 Para razonamiento, lógica y depuración de código
Para tareas que requieren pensamiento paso a paso — matemáticas, problemas de lógica,
depuración de código complejo — hay tres opciones reales en 8 GB: DeepSeek R1 8B
como modelo «pensador» clásico, Qwen3 8B para razonamiento multilingüe,
y Phi-4 Mini Reasoning como una opción más ligera con cadena de pensamiento (chain-of-thought).
Un modelo normal responde de inmediato. Un modelo de razonamiento
piensa primero —paso a paso— y luego responde.
Es como la diferencia entre «contestar al azar» y «calcular en papel».
Los modelos de razonamiento son una categoría relativamente nueva. Funcionan bajo el principio
de cadena de pensamiento (chain-of-thought): dividen el problema en pasos, comprueban los resultados intermedios
y solo entonces forman la respuesta final.
El modo de razonamiento está presente ahora no solo en los pesados modelos de 8B, sino también en variantes compactas de 3–4B.
Qué funciona en 8 GB
1. DeepSeek R1 8B (Q4_K_M) — ~5,2 GB
Según
StudyHUB,
en tareas de matemáticas, rompecabezas lógicos y razonamiento técnico, este modelo
ofrece resultados mejores que Llama 3.1 del mismo tamaño. Importante: no es el DeepSeek R1 original, sino una versión destilada;
las habilidades de razonamiento del modelo grande se han transferido a uno más pequeño. Antes de la respuesta final, genera pasos de razonamiento visibles
dentro de las etiquetas <think>, lo cual es útil para depurar y comprender
por qué el modelo llegó a esa conclusión. Compromiso: responde más despacio
y consume casi toda la memoria disponible en un sistema de 8 GB.
ollama pull deepseek-r1:8b
ollama run deepseek-r1:8b "Encuentra el error en esta consulta SQL: SELECT * FROM users WHERE id = '5' AND active = true GROUP HAVING count > 1"
⚠️ Importante: DeepSeek R1 8B ocupa ~5,2 GB en disco, por lo que en un sistema de 8 GB va al límite:
es necesario cerrar el navegador, el IDE y todo lo innecesario. En macOS con memoria unificada funciona de manera más estable que en Windows
con gráfica integrada.
2. Qwen3 8B (Q4_K_M) — ~5,2 GB
Según
LocalLLM.in,
Qwen3 8B es una sólida alternativa para tareas de razonamiento, especialmente en matemáticas
y escenarios multilingües. Admite thinking mode: se puede activar
y desactivar sin reiniciar el modelo (/think y /no_think en el prompt).
No lo confundas con qwen3.5:9b: este modelo pesa 6,6 GB y no cabe en 8 GB,
está pensado para sistemas de 16 GB.
ollama pull qwen3:8b
ollama run qwen3:8b "Resuelve: si 3x + 7 = 22, ¿cuánto vale x?"
3. Phi-4 Mini Reasoning (3.8B) — ~3 GB
Una variante de razonamiento especializada de Microsoft, diseñada para
la resolución paso a paso de problemas matemáticos en entornos con memoria limitada:
cálculos simbólicos, pruebas formales, condiciones de texto complejas.
Según
Morph,
es uno de los pocos modelos de razonamiento que deja espacio para trabajar en paralelo con el IDE y el navegador.
A diferencia de DeepSeek R1 8B, ocupa casi la mitad de memoria y deja
el sistema con buena capacidad de respuesta. En tareas complejas se queda por detrás de los modelos de 8B,
pero para la depuración diaria y el análisis es suficiente.
ollama pull phi4-mini-reasoning
ollama run phi4-mini-reasoning "Encuentra la complejidad del algoritmo y explícalo paso a paso: ..."
¿Qué elegir?
- ✔️ Depuración de código y problemas de lógica → DeepSeek R1 8B
- ✔️ Matemáticas y razonamiento multilingüe → Qwen3 8B
- ✔️ Razonamiento con el IDE y el navegador abiertos → Phi-4 Mini Reasoning (~3 GB)
Conclusión: El razonamiento en 8 GB ya no está solo
«al límite de lo cómodo». Phi-4 Mini Reasoning permite obtener un pensamiento
paso a paso con ~3 GB, sin necesidad de cerrar todo lo demás.
Para tareas más complejas, DeepSeek R1 8B y Qwen3 8B siguen siendo el estándar,
pero exigen casi toda la memoria disponible. Si planeas trabajar regularmente
con tareas de razonamiento pesadas, actualizar a 16 GB te abrirá
la puerta a la clase de 14B y a Qwen3.5 9B, donde la diferencia de calidad ya es sustancial.
🎯 CPU vs GPU vs Apple Silicon — donde 8 GB son 8 GB diferentes
8 GB en un Mac M1 y 8 GB en un portátil Windows con Intel — son dos experiencias distintas.
Apple Silicon utiliza memoria unificada, donde toda la memoria está disponible tanto para la CPU
como para la GPU simultáneamente. En un PC normal, la RAM y la VRAM son pools separados,
y para los modelos de AI esto es crítico.
Un Mac con 8 GB — es la mejor opción entre portátiles con esa memoria.
Un portátil Windows con 8 GB e Intel HD Graphics — es una lucha por cada megabyte.
Apple Silicon (M1/M2/M3/M4) — el mejor escenario para 8 GB
En Apple Silicon toda la memoria operativa es memoria unificada.
Esto significa que la parte GPU del chip tiene acceso a los mismos 8 GB
que la CPU. Ollama utiliza Metal automáticamente para la aceleración —
sin configuración adicional.
Aproximadamente, los modelos 3–4B en M1 con 8 GB rinden 15–25 tokens/seg, y los 7–8B — 8–12 tokens/seg,
y solo si el modelo cabe completamente en memoria (ver sección 1 sobre el límite de GPU en Mac).
Según datos de
SitePoint,
Phi-4 Mini en M1 MacBook Air funciona aproximadamente a 15–20 tok/s, lo cual es suficiente
para el trabajo diario.
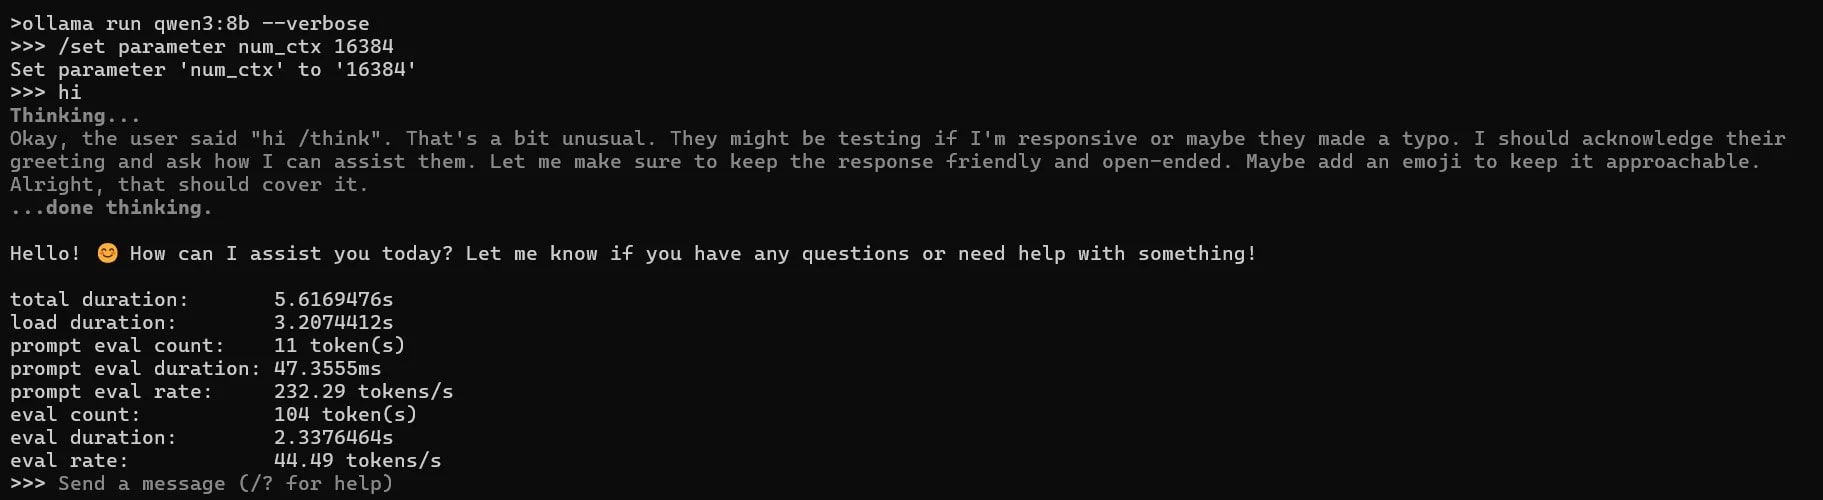
💡 Mídelo tú mismo. Ejecuta el modelo con el flag --verbose:
ollama run phi4-mini --verbose. Después de cada respuesta Ollama mostrará
eval rate — la velocidad real de generación en tu hardware.
Esto es más preciso que cualquier tabla de internet.
⚠️ Nota sobre MLX: a finales de marzo de 2026, Ollama 0.19 recibió
el backend MLX de Apple (por ahora como preview), que en modelos grandes da casi 2x de aumento de velocidad.
Pero está diseñado para Mac con 32 GB+ de memoria unificada: según datos de
el blog de Ollama
y la guía de Switching to Mac,
los Mac con 8 GB y 16 GB permanecen en el anterior llama.cpp + Metal sin cambios en la velocidad.
Los detalles de esta función cambian de release a release, así que revisa las notas de la versión reciente de Ollama.
Si planeas actualizar a un Mac con 32 GB+ — MLX será un bonus notable.
Windows / Linux con GPU discreta (RTX 3060, RTX 4060) — buen escenario
Si tienes una tarjeta gráfica discreta con 6–8 GB de VRAM — el modelo se
carga completamente en la memoria de la GPU, y la RAM del sistema queda para el SO y el software.
Según datos de
LocalLLM.in,
en la RTX 4060 (8 GB VRAM) un modelo 7B rinde 40+ tokens/seg —
la variante más rápida de todas. La condición principal: el modelo debe caber en la VRAM.
Si no cabe, parte de las capas irá a la CPU, y la velocidad caerá bruscamente.
Compruébalo con el comando ollama ps: en la columna Processor debe estar 100% GPU.
Windows / Linux sin GPU (Intel HD / AMD Radeon iGPU) — escenario complicado
Sin GPU discreta el modelo funciona completamente en CPU. Ollama de todos modos
arrancará — pero la velocidad cae a 3–6 tokens/seg para modelos 7B.
Para modelos más ligeros 3–4B (Phi-4 Mini, Llama 3.2 3B) la velocidad real
en una CPU moderna es de aproximadamente 8–12 tok/s — bastante aceptable para tareas diarias.
Según datos de
LocalLLM.in,
la inferencia solo con CPU es aceptable para tareas por lotes, pero frustra
en uso interactivo con modelos grandes.
Además, la RAM del sistema se reparte entre el SO, el software y el modelo — en 8 GB
esto es muy ajustado.
Tabla resumen
Los valores son aproximados, recogidos de pruebas de terceros. La velocidad real depende del chip, el contexto y los procesos en segundo plano.
| Plataforma |
Modelo 7–8B (Q4) |
Modelo 3–4B (Q4) |
Velocidad aproximada |
Comodidad |
| Mac M1/M2/M3/M4 8 GB (Metal) |
⚠️ Al límite |
✔️ Cómodo |
3–4B: 15–25 tok/s; 7–8B: 8–12 tok/s |
⭐⭐⭐⭐ |
| Windows + RTX 4060 8 GB VRAM |
✔️ Funciona rápido |
✔️ Cómodo |
40+ tok/s |
⭐⭐⭐⭐⭐ |
| Windows/Linux solo CPU 8 GB |
⚠️ Al límite |
✔️ Funciona |
7–8B: 3–6 tok/s; 3–4B: 8–12 tok/s |
⭐⭐–⭐⭐⭐ |
Conclusión: Si tienes un Mac M1+ con 8 GB — estás en
la mejor posición para AI local en hardware económico, y los modelos 3–4B
funcionarán de forma totalmente cómoda. El backend MLX de Ollama por ahora está orientado a Mac con 32 GB+,
así que para 8 GB la velocidad sigue como está. Si es Windows sin GPU — enfócate en modelos 3–4B:
mantienen el sistema receptivo. Más detalles sobre la instalación en distintos SO —
en el artículo Cómo instalar Ollama en Mac, Windows y Linux.
🎯 Cuantización en palabras simples: Q4 vs Q8 y qué elegir en hardware débil
Respuesta corta:
La cuantización es una compresión del modelo que reduce su tamaño en 2–4 veces
con una pérdida mínima de calidad. En 8 GB la elección óptima es Q4_K_M:
el mejor equilibrio entre tamaño, velocidad y calidad de las respuestas.
La cuantización es como el JPEG para una foto. El archivo es más pequeño,
la diferencia casi imperceptible. Pero si comprimes demasiado —
la calidad cae notablemente.
Cuando ves en el nombre del modelo en Ollama etiquetas como :7b-q4_0,
:8b-instruct-q8_0 o :3b-q4_k_m — son designaciones
del nivel de cuantización. El número después de «q» — es la cantidad de bits por parámetro.
Para la mayoría de los modelos la etiqueta por defecto en Ollama ya es Q4_K_M,
así que no hace falta indicar nada adicional.
Niveles de cuantización: qué significan las etiquetas
- ✔️ Q8 (8 bits): máxima calidad, mayor tamaño. Para un modelo 7B — ~8 GB. En 8 GB de RAM no cabe.
- ✔️ Q5_K_M (5 bits): variante intermedia entre Q4 y Q8. Para 7B — ~5.5 GB. En 8 GB de RAM solo sirve si hay GPU con 6–8 GB de VRAM y se necesita mayor precisión.
- ✔️ Q4_K_M (4 bits, K-quant medium): equilibrio óptimo. Para 7B — ~4–5 GB. Recomendado para sistemas de 8 GB.
- ✔️ Q4_K_S (4 bits, K-quant small): un poco más pequeño que Q4_K_M, calidad un poco menor.
- ✔️ IQ4_XS (importance matrix, 4 bits): formato más nuevo. Según datos de
RunAIHome,
da casi la misma calidad que Q4_K_M, pero ocupa ~400 MB menos para un modelo 8B.
Útil cuando Q4_K_M apenas no cabe. Disponible como etiqueta en Hugging Face,
no siempre presente en Ollama Library.
- ✔️ Versiones QAT: algunos modelos (por ejemplo, en la familia Gemma) tienen variantes entrenadas
teniendo en cuenta la cuantización. Si para el modelo que necesitas hay una etiqueta con la marca
qat,
compárala con Q4_K_M por tamaño y calidad.
- ⚠️ Q2_K (2 bits): tamaño mínimo (~2.5 GB para 7B), pero degradación notable de la calidad. Variante extrema.
El sufijo «K» significa métodos de cuantización más nuevos (K-quant), que distribuyen de forma más inteligente
la precisión entre las capas del modelo. Las etiquetas K-quant siempre son mejores que
las variantes legacy (q4_0, q4_1) con el mismo tamaño.
Cuánto pesan los modelos de distintas cuantizaciones
El tamaño Q4_K_M — son los tamaños reales de las etiquetas por defecto de la biblioteca de Ollama,
Q8 y Q2_K — estimaciones aproximadas.
| Modelo |
Q8 (aproximado) |
Q4_K_M (Ollama) |
Q2_K (aproximado) |
| Llama 3.2 (3B) |
~3.4 GB |
2.0 GB |
~1.2 GB |
| Phi-4 Mini (3.8B) |
~4.1 GB |
2.5 GB |
~1.5 GB |
| Qwen3 8B |
~9 GB |
5.2 GB |
~3 GB |
| Mistral 7B |
~8 GB |
~4.1–4.4 GB |
~2.8 GB |
Fuentes: biblioteca de Ollama,
LocalAIMaster,
RunAIHome.
Atención: en algunos modelos nuevos la etiqueta por defecto no es Q4_K_M, sino más pesada (como en Gemma 4, ver sección 3),
así que mira siempre el tamaño real de la etiqueta.
Regla para 8 GB: elige siempre Q4_K_M. Si no cabe — reduce
el tamaño del modelo (3B en lugar de 7B), no el nivel de cuantización (Q2 en lugar de Q4).
Un modelo más pequeño con Q4 dará mejor calidad que uno más grande con Q2.
Excepción: si Q4_K_M literalmente no cabe por 100–400 MB — prueba IQ4_XS,
si existe tal etiqueta para el modelo que necesitas en Hugging Face.
Más detalles sobre las técnicas de compresión y su impacto en la calidad — en nuestro artículo sobre cuantización de modelos (INT4, INT8).
Conclusión: Q4_K_M — es el estándar de oro para 8 GB y no ha perdido vigencia.
No cedas a la tentación de descargar Q8 «por la calidad» — el modelo
no cabrá en memoria y obtendrás swap al disco. Alternativas en el horizonte —
IQ4_XS y versiones QAT: un poco menos de tamaño o mejor calidad, pero no para todos los modelos.
🎯 Configuración de Ollama para el máximo rendimiento en hardware débil
Unas pocas variables de entorno y un hábito (cerrar lo innecesario) — es todo
lo que se necesita para exprimir al máximo 8 GB. La configuración toma
unos minutos, y la diferencia en estabilidad es notable.
En hardware potente, Ollama «simplemente funciona».
En hardware débil, hay que ayudarla a no gastar memoria en lo
que no necesitas.
Por defecto, Ollama usa una ventana de contexto de 4096 tokens,
puede mantener hasta tres modelos en memoria simultáneamente y procesa una solicitud paralela por modelo.
En 8 GB, mantener varios modelos es un lujo innecesario. Esto es lo que vale la pena configurar:
| ⚙️ Variable |
📝 Por defecto |
🎯 Qué hacer en 8 GB |
OLLAMA_MAX_LOADED_MODELS |
3 (en CPU) |
Poner 1 para no mantener modelos innecesarios en memoria |
OLLAMA_NUM_PARALLEL |
1 |
Dejar 1: la memoria se multiplica por la cantidad de solicitudes paralelas y el tamaño del contexto |
OLLAMA_CONTEXT_LENGTH |
4096 |
2048–4096. Para modelos de razonamiento mejor no menos de 4096 |
OLLAMA_FLASH_ATTENTION |
a criterio de Ollama |
1 (necesario para la cuantización del KV-cache) |
OLLAMA_KV_CACHE_TYPE |
f16 |
q8_0: aproximadamente la mitad de memoria para el KV-cache |
OLLAMA_KEEP_ALIVE |
5 minutos |
Se puede reducir a 1–2 minutos para que el modelo se descargue más rápido de la memoria |
🔗 Fuentes: documentación de Ollama (FAQ),
DEV Community,
SSD Nodes.
Variables de entorno básicas
# Mantener en memoria solo un modelo
export OLLAMA_MAX_LOADED_MODELS=1

# Una solicitud paralela (este es el valor por defecto, lo fijamos por fiabilidad)
export OLLAMA_NUM_PARALLEL=1

# Ventana de contexto: 2048 para tareas simples, 4096 para razonamiento
export OLLAMA_CONTEXT_LENGTH=2048
⚠️ Atención: en la versión anterior del artículo yo indicaba la variable OLLAMA_CTX_SIZE.
Esa variable no existe en la documentación de Ollama, el nombre correcto es OLLAMA_CONTEXT_LENGTH.
Si instalaste la antigua, la configuración no funcionaba.
Variables para ahorrar KV-cache (GPU y Apple Silicon)
Si ejecutas Ollama en GPU (NVIDIA, AMD) o Apple Silicon (M1+) —
además configura estas dos variables. Existen desde finales de 2024
y reducen el KV-cache aproximadamente a la mitad sin pérdida notable de calidad para la mayoría de las tareas.
# Flash Attention — requisito obligatorio para la cuantización del KV-cache
export OLLAMA_FLASH_ATTENTION=1

# KV-cache en 8 bits — aproximadamente la mitad de memoria para el cache
export OLLAMA_KV_CACHE_TYPE=q8_0
⚠️ Importante: OLLAMA_KV_CACHE_TYPE funciona solo si está activado
OLLAMA_FLASH_ATTENTION=1. Según datos de
SSD Nodes,
q8_0 ahorra aproximadamente la mitad de memoria en comparación con f16, y q4_0 — aproximadamente un cuarto,
pero q4_0 puede empeorar notablemente la calidad, por eso para 8 GB es suficiente q8_0.
La cuantización del cache puede reducir un poco la velocidad de generación. Si después de activarla
algún modelo no se carga, sospecha primero de OLLAMA_KV_CACHE_TYPE
e intenta quitarla. Para sistemas solo con CPU estas variables no aportan beneficio.
Dónde configurar las variables
- 🍎 macOS (aplicación Ollama): mediante
launchctl setenv NOMBRE valor, luego reinicia Ollama. Las líneas en ~/.zshrc funcionarán solo si ejecutas el servidor manualmente con el comando ollama serve desde la terminal
- 🐧 Linux (systemd): en
systemctl edit ollama.service añade las líneas Environment="NOMBRE=valor" en la sección [Service] y reinicia el servicio
- 🪟 Windows: define variables de usuario o variables de entorno del sistema y reinicia Ollama desde la bandeja del sistema
El contexto también se puede cambiar sin variables de entorno: en el chat con el comando /set parameter num_ctx 4096
o con el parámetro num_ctx en el Modelfile.
Antes de ejecutar el modelo
Suena trivial, pero en 8 GB es crítico:
- ✔️ Cierra el navegador o deja como máximo 2–3 pestañas
- ✔️ Cierra Slack, Discord, Spotify — cada programa consume 200–500 MB
- ✔️ Comprueba el uso actual:
ollama ps mostrará los modelos cargados y la proporción GPU/CPU
- ✔️ Si el modelo antiguo todavía está en memoria —
ollama stop nombre_del_modelo
Modelfile para ajuste fino
Si quieres más control — crea un Modelfile con parámetros optimizados:
FROM phi4-mini
PARAMETER num_ctx 2048
PARAMETER num_thread 4
PARAMETER temperature 0.7
Guarda el archivo como Modelfile y crea tu propia versión del modelo:
ollama create phi4-mini-lite -f Modelfile
ollama run phi4-mini-lite
num_ctx 2048 — reduce la ventana de contexto (menos RAM para el KV-cache).
num_thread 4 — limita la cantidad de hilos de CPU para que el sistema
siga siendo receptivo. Este es un parámetro del Modelfile, no una variable de entorno.
La guía paso a paso para la instalación y el primer inicio —
en el artículo Cómo instalar Ollama en Mac, Windows y Linux: guía completa 2026.
Conclusión: Un modelo en memoria + contexto razonable + programas innecesarios cerrados =
funcionamiento estable en 8 GB. Si tienes GPU o Apple Silicon — añade
OLLAMA_FLASH_ATTENTION=1 y OLLAMA_KV_CACHE_TYPE=q8_0:
según la documentación de Ollama, esto reduce aproximadamente a la mitad la memoria del KV-cache.
Sin una configuración básica, incluso un modelo ligero puede provocar swap en disco.
🎯 Lo que NO vale la pena intentar en 8 GB
Respuesta corta:
Modelos 13B+, cualquier modelo en cuantización Q8, intentos de mantener dos
modelos simultáneamente y modelos MoE con gran tamaño total — decepción garantizada en 8 GB.
Aquí están las trampas típicas que enfrenta casi todo el que prueba AI local en hardware así.
Todo el que ha trabajado con Ollama en 8 GB pasa por la misma
etapa: «¿Y si 14B de todos modos cabe?» No, no cabe.
❌ Modelos 13–14B y mayores
Qwen3 14B (9,3 GB en la biblioteca de Ollama), DeepSeek R1 14B (9 GB), CodeLlama 13B —
incluso en cuantización Q4 necesitan 8–9 GB solo para los pesos del modelo.
Añade el KV-cache y el SO, y obtendrás un sistema que hace swap al disco continuamente:
la carga toma minutos, y la velocidad cae a 1–2 tokens por segundo con pausas constantes.
Esto es inutilizable para uso interactivo.
❌ Cualquier modelo 7B en cuantización Q8
La versión Q8 de un modelo 7B pesa alrededor de 8 GB — toda tu memoria
RAM. El SO no desaparece mágicamente, así que el sistema se cuelga o empieza a hacer swap.
Usa siempre Q4_K_M para modelos 7B en 8 GB.
❌ Dos modelos simultáneamente
Por defecto Ollama puede mantener varios modelos en memoria (hasta tres). En 16 GB esto es cómodo —
cambias entre modelos al instante. En 8 GB es una receta para una tormenta de swap.
Mantén OLLAMA_MAX_LOADED_MODELS=1 y no olvides
ollama stop antes de cargar otro modelo.
❌ Ventanas de contexto grandes (8K+ tokens)
Cada duplicación de la ventana de contexto — son cientos de megabytes adicionales
para el KV-cache. En 8 GB mantén el contexto en 4096 tokens como máximo (este ya es el valor por defecto).
Pasarle al modelo un documento de 10 páginas completo — no va a funcionar,
hay que dividirlo en partes.
Ayuda parcialmente OLLAMA_FLASH_ATTENTION=1 +
OLLAMA_KV_CACHE_TYPE=q8_0 de la sección sobre configuración —
reducen el KV-cache aproximadamente a la mitad. Pero 8K+ en 8 GB sigue siendo zona de riesgo.
❌ Modelos MoE con gran tamaño total (Mixtral, Llama 4 Scout, Qwen3.5/3.6 35B-A3B)
La arquitectura MoE (Mixture of Experts) engaña con los nombres.
Mixtral 8x7B activa solo 2 de 8 «expertos» por cada token —
pero los 8 deben estar en memoria simultáneamente, y eso son 26+ GB en Q4.
Llama 4 Scout (año 2025) parece un «17B», pero en la biblioteca de Ollama
su etiqueta llama4:16x17b pesa alrededor de 67 GB.
Modelos como Qwen 35B-A3B activan solo 3B parámetros por token,
pero mantienen en memoria los 35B completos — son 20+ GB en Q4. La regla es simple: mira el tamaño total
de la etiqueta en Ollama Library, no la cantidad de parámetros activos.
❌ Thinking mode con contexto diminuto
Qwen3 8B, Qwen3.5 4B y Phi-4 Mini Reasoning generan «thinking tokens»
antes de la respuesta final — a veces miles de tokens de razonamiento interno.
Estos tokens también ocupan espacio en el contexto. En tareas complejas la cadena de pensamiento puede ocupar 2000–5000 tokens
antes de que el modelo empiece a responder. Si el contexto es demasiado pequeño, el razonamiento se corta
o la respuesta sale vacía o truncada; si es grande — crece el KV-cache y el modelo se ralentiza.
Solución: para tareas de razonamiento mantén el contexto no menor a 4096 y desactiva el thinking
para consultas simples (con el flag --think=false, el comando /set nothink
o el interruptor /no_think en los modelos Qwen3).
Regla general: si ollama run
tarda más de 30 segundos en cargar y la primera respuesta llega después de
un minuto — el modelo es demasiado grande para tu sistema. No esperes que
«se caliente» — ciérralo y toma un modelo de menor tamaño.
La comparación de modelos por tamaño, calidad y tareas —
en el artículo Top-10 modelos Ollama en 2026: cuál elegir.
Conclusión: La historia típica es así: la persona piensa que un modelo
más grande dará mejor resultado, carga un 13–14B, espera un minuto para la primera
respuesta y lo elimina. Después de pasarse a 3–4B, la productividad crece de inmediato.
En 8 GB la mejor estrategia — elegir un modelo que funcione rápido y estable,
que sufrir con uno que «casi cabe». A las trampas clásicas se añadió una más —
thinking mode: los nuevos modelos piensan en voz alta y se comen silenciosamente
tu contexto antes de la primera palabra de la respuesta.
🎯 Velocidad aproximada: qué esperar en la práctica
Respuesta corta:
En Mac M1 con 8 GB, los modelos de 3–4B ofrecen aproximadamente 15–28 tokens/seg, y los de 7–8B, 8–12 tokens/seg.
En un portátil con Windows solo con CPU, la velocidad es de dos a tres veces menor para modelos grandes,
pero los modelos de 3–4B en CPUs modernas ofrecen 8–12 tokens/seg, lo cual es suficiente para un trabajo cómodo.
A continuación, se presenta una tabla resumen para orientación.
Los benchmarks en internet a menudo se realizan en un sistema limpio sin
otro software. En la realidad, con VS Code abierto y 5 pestañas de Chrome,
las cifras serán menores.
⚠️ Honestidad sobre el origen de las cifras. Estas no son mis mediciones propias, sino un resumen de pruebas públicas
(LocalLLM.in, SitePoint, LocalAIMaster). Deben tomarse como rangos de referencia. A continuación, muestro
cómo medir la velocidad real en tu hardware en dos minutos.
Tabla resumen de rendimiento
| Modelo |
Tamaño en Ollama |
Mac M1 8 GB |
Solo CPU 8 GB |
RTX 4060 8 GB VRAM |
| Llama 3.2 3B (Q4) |
2,0 GB |
~25–28 tok/s |
~9–12 tok/s |
~45–50 tok/s |
| Phi-4 Mini 3.8B (Q4) |
2,5 GB |
~18–22 tok/s |
~10–12 tok/s |
~42–45 tok/s |
| Qwen3.5 4B (Q4) |
3,4 GB |
~18–21 tok/s |
~6–8 tok/s |
~40–42 tok/s |
| Qwen3 8B (Q4) |
5,2 GB |
~9–11 tok/s |
~3–5 tok/s |
~35–38 tok/s |
| DeepSeek R1 8B (Q4) |
5,2 GB |
~8–10 tok/s |
~3 tok/s |
~33–35 tok/s |
Datos aproximados, recopilados de
LocalLLM.in,
SitePoint
y LocalAIMaster.
La velocidad real depende de la carga del sistema, el tamaño del contexto
y los procesos en segundo plano. Para GPU y Apple Silicon, habilitar
OLLAMA_FLASH_ATTENTION=1 puede ayudar con contextos largos.
Gemma 4 E4B no está en la tabla a propósito: su etiqueta estándar (9,6 GB) no cabe en 8 GB.
📏 Cómo medir la velocidad en tu hardware
ollama run phi4-mini --verbose
# después de la respuesta, mira la línea "eval rate: ... tokens/s" — esta es la velocidad de generación

ollama ps
# en la columna PROCESSOR debería decir "100% GPU" (si tienes GPU) — de lo contrario, parte de las capas están en la CPU
La línea eval rate es la velocidad real de generación de la respuesta; prompt eval rate muestra la rapidez con la que el modelo procesa tu consulta.
Mide con los programas que sueles tener abiertos (IDE, navegador), así las cifras serán honestas.
¿Qué significan estas cifras en la práctica?
- ✔️ 15+ tok/s: chat interactivo cómodo — la respuesta aparece más rápido de lo que puedes leer
- ✔️ 8–15 tok/s: se puede trabajar, pero se nota un retraso en respuestas largas
- ⚠️ 3–6 tok/s: aceptable para tareas puntuales (depuración, análisis), frustrante en chat activo
- ❌ <3 tok/s: el modelo es demasiado grande para este sistema
Conclusión: Para el trabajo diario con 8 GB, enfócate
en modelos de 3–4B — ofrecen 15–28 tok/s en Apple Silicon y 8–12 tok/s
en CPU, manteniendo el sistema receptivo. Phi-4 Mini destaca
por el mejor rendimiento en CPU de su clase (~12 tok/s en un i7 moderno) —
sustancialmente mejor que Phi-3 Mini, a la que reemplaza. Los modelos de 7–8B (Qwen3 8B, DeepSeek R1 8B) son
para tareas específicas cuando estás dispuesto a cerrar todo lo innecesario y esperar.
❓ Preguntas frecuentes (FAQ)
¿Se puede ejecutar Ollama en un portátil con 8 GB de RAM?
Sí. Los modelos de 1–4B parámetros (Phi-4 Mini, Llama 3.2 3B, Qwen3 4B)
funcionan cómodamente en cualquier sistema con 8 GB. Los modelos de 7–8B
funcionan al límite — es necesario cerrar programas innecesarios.
Más detalles — en la
guía de instalación de Ollama.
¿Cuál es el mejor modelo para 8 GB de RAM?
Depende de la tarea. Para código — Qwen3 4B (2,5 GB) o Qwen3.5 4B (3,4 GB).
Para texto y chat — Llama 3.2 3B o Gemma 3 4B.
Para razonamiento y depuración — DeepSeek R1 8B (al límite de 8 GB) o
Phi-4 Mini Reasoning (una versión más ligera con chain-of-thought).
Una herramienta para todo — Qwen3.5 4B: multimodal,
256K de contexto, modo de pensamiento, pero más pesado que Qwen3 4B.
Comparación completa de modelos —
en el artículo Top 10 modelos de Ollama en 2026.
¿Se necesita GPU para Ollama?
No, Ollama también funciona en CPU. Pero con GPU (dedicada o Apple Silicon)
la velocidad es varias veces mayor. En un sistema solo con CPU y 8 GB
limítate a modelos de 3–4B para un trabajo cómodo.
Phi-4 Mini es una de las mejores opciones para solo CPU: según resultados de pruebas de terceros,
alrededor de 12 tok/s en un i7 moderno sin GPU.
¿Qué es mejor: un modelo 7B en Q2 o un 3B en Q4?
Casi siempre — 3B en Q4. La cuantización agresiva (Q2) reduce significativamente
la calidad de las respuestas, especialmente en tareas complejas.
Un modelo más pequeño con cuantización normal dará un mejor resultado.
Si Q4_K_M literalmente no cabe por unos cientos de MB —
prueba IQ4_XS para el mismo modelo, si esa etiqueta existe en Hugging Face.
¿Los modelos pequeños soportan el idioma ucraniano?
Varía. Llama 3.2 soporta oficialmente 8 idiomas, el ucraniano no está entre ellos.
Qwen3 y Gemma declaran soporte para más de 100 idiomas, incluido el ucraniano.
La calidad del ucraniano en cada modelo es mejor verificarla con tus propios textos:
haz algunas consultas típicas y compara las respuestas.
¿Puede Ollama con 8 GB reemplazar a ChatGPT?
Para tareas diarias — resumen, preguntas sencillas, generación de código —
sí. Para multimodalidad básica (análisis de imágenes, capturas de pantalla) —
también: Gemma 3 4B y Qwen3.5 4B aceptan imágenes.
Para análisis complejo de múltiples pasos, trabajo con gran contexto
y tareas que requieren máxima precisión — los modelos en la nube son aún más potentes.
El enfoque óptimo es híbrido:
Ollama para tareas regulares, ChatGPT/Claude para las complejas.
Más detalles —
en el artículo Ollama vs ChatGPT vs Claude: cuándo la IA local es mejor.
¿Cuánto espacio en disco se necesita?
Un modelo de 3–4B en Q4 — aproximadamente 2–3,5 GB en disco. Tres modelos para diferentes
tareas — 7–9 GB. Ollama almacena los modelos en ~/.ollama,
los modelos descargados se pueden eliminar con el comando ollama rm nombre_del_modelo.
¿Vale la pena actualizar a 16 GB?
Si planeas trabajar regularmente con IA local — definitivamente sí.
16 GB abren acceso a modelos de 9–14B (Qwen3.5 9B con 6,6 GB, Qwen3 14B con 9,3 GB),
modelos de 7B en mayor calidad y trabajo cómodo con grandes ventanas de contexto.
El backend MLX de Ollama está actualmente enfocado en Mac con 32 GB+, por lo que 16 GB no lo desbloquearán.
La diferencia en capacidades entre 8 y 16 GB es la mayor en todo el espectro.
✅ Conclusiones
8 GB de RAM no son una sentencia para la IA local,
pero es un límite que requiere decisiones conscientes. Aquí lo principal:
- ✔️ Modelos de 3–4B — zona de confort: Phi-4 Mini, Llama 3.2 3B, Qwen3 4B, Qwen3.5 4B, Gemma 3 4B funcionan rápido y estable, dejando espacio para IDE y navegador
- ✔️ Modelos de 7–8B — zona de trabajo: DeepSeek R1 8B, Qwen3 8B funcionan al límite (5,2 GB cada uno), pero ofrecen una calidad notablemente mejor para tareas específicas
- ✔️ Q4_K_M — la única opción de cuantización sensata en 8 GB: un modelo más pequeño con Q4 siempre es mejor que uno más grande con Q2
- ✔️ Apple Silicon con 8 GB — la mejor opción económica: la memoria unificada da una ventaja sobre los sistemas solo con CPU
- ✔️ No vale la pena intentar: modelos de 13B+, Q8, dos modelos simultáneamente, MoE con un tamaño total grande y modo de pensamiento sin suficiente contexto
- ✔️ Mira el tamaño de la etiqueta, no el nombre: las nuevas generaciones como Gemma 4 tienen etiquetas más pesadas por defecto, y no caben en 8 GB
Yo mismo uso este enfoque: mantengo varios modelos
para diferentes tareas — uno para código, otro para texto, uno separado para depuración.
Cada modelo tiene su punto fuerte, y en lugar de uno grande,
que podría no caber en memoria, es mejor tener 2–3 especializados y ligeros.
Cambiar entre ellos a través de ollama run es cuestión de segundos.
Si recién empiezas —
instala Ollama con
nuestra guía,
descarga phi4-mini y pruébalo.
En cinco minutos tendrás una IA local funcionando —
sin suscripciones, sin internet, sin enviar datos al exterior.
Y si necesitas un sitio web, blog o aplicación web con integración
de funcionalidades de IA —
escríbenos a WebsCraft,
te ayudaremos a implementarlo.
📖 Fuentes