Я підключив свій блог до Claude через MCP. Тепер, коли хтось питає в Claude «яку модель Ollama обрати для 8 ГБ RAM», модель може сама знайти відповідь у статтях webscraft.org і дати посилання. У цій статті пояснюю, що таке MCP без жаргону, як він працює під капотом і які рішення довелося прийняти, щоб сервер був корисним, безпечним і не з'їдав гроші. Мова програмування тут не головне: принципи однакові для Java, Python, Node.js чи PHP. Якщо шукаєте готові MCP-сервери для роботи — дивіться топ-10 MCP-серверів для розробника з плюсами, мінусами і ризиками, а помилки, на які я наступив при створенні власного, розібрані в статті «Типові помилки при створенні MCP-сервера»
⚡ Коротко
✅ MCP — це стандарт, через який AI-асистенти підключаються до зовнішніх даних і інструментів. Не API для інших сайтів, а «розетка» саме для Claude, ChatGPT, Cursor та інших AI-клієнтів.
✅ Для блогу достатньо трьох інструментів: пошук по статтях, зміст статті і список нових публікацій. Модель сама вирішує, коли їх викликати.
✅ Головні рішення: віддавати фрагменти, а не готову відповідь; stateless-транспорт; відкритий доступ із лімітами замість токена.
✅ Чесно про трафік: MCP майже не приводить відвідувачів на сайт — людина читає відповідь у Claude. Це витрина і досвід, а не джерело трафіку.
🎯 Ви отримаєте: розуміння, як влаштований MCP, які архітектурні рішення прийняти для свого сайту і на що звернути увагу з безпекою.
👇 Нижче — детальні пояснення, таблиці порівнянь і реальний досвід запуску.
Коротка відповідь: MCP (Model Context Protocol) — відкритий стандарт, який дозволяє AI-асистенту підключитися до вашого сервісу і користуватися ним як інструментом: шукати, читати, а якщо ви дозволите — і змінювати дані.
До MCP кожна інтеграція була окремою: плагін для одного чат-бота, свій формат для іншого, третій формат для IDE. MCP зробив одну «розетку»: ви один раз пишете MCP-сервер, і до нього підключаються Claude, ChatGPT, Cursor, Claude Code, OpenCode та інші клієнти, які підтримують протокол.
Стандарт запустила Anthropic наприкінці 2024 року, а в грудні 2025-го передала його у новостворений Agentic AI Foundation під егідою Linux Foundation. Співзасновниками фонду стали Anthropic, Block і OpenAI, підтримали Google, Microsoft, AWS, Cloudflare і Bloomberg. Тобто MCP більше не «протокол однієї компанії», а нейтральний галузевий стандарт.
⚠️ Головне непорозуміння: MCP — це не API, через який інші сайти робитимуть запити до вашого. Клієнт MCP — це AI-модель. Вона читає список ваших інструментів і сама вирішує, коли їх викликати. Якщо вам потрібно, щоб інший сайт зі свого бекенду отримував ваші дані, — це звичайний REST API.
Чим MCP відрізняється від REST API:
REST API
MCP
Хто викликає
програміст пише код виклику
AI-модель вирішує сама
Як клієнт дізнається, що вміє сервер
документація для людей
сервер сам віддає список інструментів з описами
Для кого опис
для розробника
для моделі (опис = частина промпту)
Типовий клієнт
інший сервіс, фронтенд, мобільний застосунок
Claude, ChatGPT, Cursor, AI-агент
Чого MCP не вміє:
Не замінює API. Інші сайти і бекенди через MCP до вас не ходять — для них потрібен звичайний REST API.
Не гарантує, що вас викличуть. Модель сама вирішує, чи потрібен їй ваш інструмент. Нечіткий опис — і вона просто відповість з власних знань.
Не шукає за вас. MCP — лише «розетка». Якість відповідей залежить від того, як ви реалізували пошук усередині сервера.
Не пам'ятає розмову. Контекст діалогу тримає клієнт; сервер отримує лише окремі виклики.
Не захищає сам по собі. Авторизація, ліміти і що саме віддавати назовні — це ваша відповідальність.
Висновок розділу: MCP — це спосіб зробити ваш сервіс «інструментом» для будь-якого AI-асистента, а не ще один API.
🌍 Розділ 2. Де MCP вже використовують і навіщо він блогу
Найкраще MCP показав себе там, де AI-асистенту потрібні живі дані, яких немає в його навчанні:
Розробка: GitHub має офіційний MCP-сервер для роботи з репозиторіями, issues і pull requests; Sentry — для помилок продакшену; Linear — для задач. Асистент у редакторі коду бачить реальні дані, а не вгадує.
Документація: Microsoft Learn має відкритий MCP-сервер для пошуку по своїй документації — без авторизації, бо дані публічні. Context7 віддає актуальну документацію бібліотек, щоб модель не писала код за застарілим API.
Бізнес-сервіси: Stripe (платежі), Notion (бази знань), Figma (дизайн) мають власні віддалені MCP-сервери з OAuth.
Корпоративні дані: внутрішні регламенти, CRM, бази знань — це найчастіший сценарій у компаніях.
А навіщо MCP блогу? Коли я вперше почув про MCP, він здавався чимось складним: протокол, транспорти, сесії, JSON-RPC, а більшість матеріалів одразу починалися з коду, без пояснення, що це взагалі таке. Тому я вирішив розібратися на практиці — підключив до MCP свій блог і написав цей гайд: що таке MCP простими словами, як він працює і які рішення доводиться приймати. Чесно про трафік: його MCP майже не дає — людина читає відповідь у Claude, а не на сайті. Але розуміння технології і досвід, який тепер можна застосувати в клієнтських проєктах, того варті.
👤 З мого досвіду: на блозі вже є RAG-чат по статтях і SEO-агент на даних Search Console. MCP став логічним наступним кроком: той самий векторний пошук, але доступний не лише на сайті, а й у будь-якому AI-асистенті.
⚙️ Розділ 3. Як це працює під капотом
Розмова клієнта з MCP-сервером — це звичайні HTTP POST-запити з JSON (формат JSON-RPC). Три основні кроки:
1. initialize   → «привіт, я Claude, ось мої можливості»
                ← «привіт, я webscraft, ось мої можливості й інструкція»

2. tools/list   → «які в тебе інструменти?»
                ← search_articles, get_article, latest_articles + описи

3. tools/call   → search_articles({"query": "ollama 8 ГБ RAM"})
                ← 3 статті з фрагментами і посиланнями
Перші два кроки клієнт робить один раз при підключенні. Третій — щоразу, коли модель вирішує, що їй потрібні ваші дані.
💡 Головне, що варто зрозуміти: контекст розмови тримає клієнт, а не сервер. Якщо користувач пише «а на Windows?», сервер не знає, що мова про Ollama. Це знає Claude — і сам формулює повний запит: search_articles("ollama windows 8gb"). Ваш сервер просто шукає. Він не бачить розмову і не повинен її пам'ятати.
Звідси важливий наслідок для дизайну: кожен виклик інструмента має бути самодостатнім. Усе потрібне для відповіді — у параметрах виклику.
🧩 Розділ 4. Рішення №1: фрагменти чи готова відповідь
Перше питання, яке я собі поставив: у мене вже є RAG-чат на сайті, який отримує питання, шукає в базі і генерує відповідь через LLM. Чому б не віддавати через MCP готову відповідь?
Різниця в тому, хто стоїть по той бік. RAG-чат на сайті спілкується з людиною — їй потрібна готова відповідь, тому її пише моя модель. У MCP по той бік вже є модель, і зазвичай сильніша за мою. Їй потрібні не переказ, а першоджерело.
Віддавати фрагменти
Віддавати готову відповідь
Вартість одного виклику
лише ембединг запиту — частки цента
ембединг + генерація LLM за ваш рахунок
Швидкість
100–300 мс
3–10 с
Якість
сильна модель клієнта працює з першоджерелом
«зіпсований телефон»: ваша модель переказала, модель клієнта переказує переказ
Гнучкість
клієнт може уточнити пошук, поєднати з іншими джерелами
отримує готовий текст, копнути глибше не може
Ризик
зловживання дешеве
кожен виклик будь-кого з інтернету — ваші витрати на LLM
Моє рішення — фрагменти. Готова відповідь має сенс лише у двох випадках: коли ваш RAG робить щось, чого не повторити по фрагментах (складна бізнес-логіка, власне ранжування), або коли клієнти — слабкі локальні моделі.
А якщо RAG і векторної бази немає? MCP їх не вимагає. Варіанти від простого до складного:
Лише список і зміст статей — інструменти «останні статті» і «зміст статті». Модель зорієнтується за заголовками.
Повнотекстовий пошук — вбудований пошук сайту або повнотекстовий індекс у базі (наприклад, PostgreSQL full-text search). Працює добре, якщо запит містить ті самі слова, що й стаття.
Векторний пошук — знаходить статті за змістом, навіть якщо слова інші («слабкий ноутбук» → стаття про 8 ГБ RAM). Найкраща якість, але потрібні ембединги. Детальніше — у статтях про локальний AI і RAG.
🔄 Розділ 5. Рішення №2: сесія чи stateless
Для віддалених серверів MCP використовує транспорт Streamable HTTP. У нього два режими, і різниця тут не в тому, «чи пам'ятає сервер розмову» (не пам'ятає в жодному), а в тому, чи тримає він з'єднання.
Із сесією — як телефонний дзвінок. При підключенні сервер видає ідентифікатор сесії, клієнт додає його до кожного запиту. Сервер може написати клієнту першим: прогрес довгої операції, повідомлення «список інструментів змінився».
Stateless — як віконце довідкової. Кожен запит незалежний, сервер нічого не зберігає і першим не пише — лише відповідає.
Ситуація
Із сесією
Stateless
Деплой / перезапуск сервера
сесії зникають, клієнт отримує помилку і має перепідключитися
наступний запит просто обробляється
Кілька інстансів за балансувальником
потрібні «липкі» сесії
працює будь-який інстанс
Cloudflare та інші проксі
довгі з'єднання рвуться за таймаутом
звичайні короткі запити
Довгі операції з прогресом
✅ підходить
❌ не вміє
Моє рішення — stateless. Пошук триває 100–300 мс, стрімити нічого. А сайт стоїть за Cloudflare і регулярно деплоїться — сесії тут лише додали б проблем. Сесії потрібні, якщо ваш інструмент працює хвилинами (генерація звіту, обробка файлів) і має показувати прогрес.
🔐 Розділ 6. Рішення №3: відкритий доступ, токен чи OAuth
Перша думка — «все треба закривати». Але правильна відповідь залежить від того, які дані віддає сервер і хто підключатиметься.
Варіант
Як працює
Коли використовувати
Обмеження
Відкритий + ліміти
будь-хто підключається за URL
публічні дані: статті, документація, каталог
захист лише лімітами запитів
Bearer-токен
ключ у заголовку Authorization
інструменти для себе або кількох довірених людей
веб-версії Claude і ChatGPT не дають вписати заголовок — підключиться лише Claude Code, Cursor та подібні
OAuth 2.1
користувач натискає «Увійти» і «Дозволити»
особисті чи корпоративні дані багатьох користувачів
потрібен сервер авторизації — це дні роботи
Моє рішення для блогу — відкритий доступ із лімітами. Статті й так публічні — їх можна прочитати на сайті або зібрати краулером. Токен тут нічого б не захистив, а відрізав би найбільшу аудиторію: веб-клієнти Claude і ChatGPT підтримують лише підключення без авторизації або з OAuth.
Антипатерни, яких варто уникати:
❌ Один спільний токен, опублікований на сторінці «Як підключити». Це вже не захист: ключ є в усіх. Або відкрийте сервер, або видавайте ключі кожному окремо.
❌ Ключ у URL (/mcp?key=...). URL потрапляють у логи серверів, проксі та історію браузера.
❌ OAuth для публічних даних «про всяк випадок». Дні роботи і бар'єр для користувачів без жодної вигоди.
❌ Відкритий доступ до приватних даних. Аналітика, дані клієнтів, внутрішні документи — лише з авторизацією.
❌ Інструменти запису без авторизації. Відкритим може бути лише читання.
Для блогу я зробив три інструменти, і всі лише читають:
Інструмент
Що повертає
Навіщо
search_articles(query, limit)
до 5 статей: заголовок, URL, дата, категорія, релевантність і 1–2 фрагменти
основний сценарій — знайти відповідь
get_article(slug)
заголовок, URL, короткий зміст і список розділів (без повного тексту)
подивитися, що ще є в статті
latest_articles(limit)
останні публікації
«що нового на блозі?»
Опис вирішує, чи вас взагалі викличуть
Модель бачить лише назву, опис і параметри інструмента. За ними вона вирішує, чи варто його викликати. Тому опис — це не документація, а частина промпту. Що я в нього пишу:
про що дані — «україномовний технічний блог: AI-інструменти, локальні LLM, Spring Boot, RAG, SEO»;
коли викликати — «коли користувач питає, як щось зробити в цих темах, або просить джерело»;
як краще формулювати запит — «пиши query українською» (блог українською, так пошук точніший);
що робити з результатом — «це фрагменти, а не повні статті: завжди давай користувачу посилання».
Описи я пишу англійською: моделі однаково добре розуміють обидві мови, а англійська універсальніша для різних клієнтів.
Відповідь зі статусом
Модель має розрізняти «статті немає» і «сервер зламався» — від цього залежить, що вона скаже користувачу. Тому кожна відповідь має поле status:
{"status": "ok",          "articles": [...]}
{"status": "not_found",   "message": "Нічого не знайдено на webscraft.org за цим запитом."}
{"status": "unavailable", "message": "Пошук тимчасово недоступний. Спробуйте пізніше."}
Гігієна фрагментів
Розмір: до ~900 символів на фрагмент і не більше 1–2 фрагментів на статтю. Інакше замість п'яти різних статей прийдуть п'ять шматків однієї, а контекст клієнта з'їсться за один виклик.
Обрізки слів: при нарізці тексту на шматки (чанки) вони часто починаються з середини слова. Відрізаю такий обрізок до першого пробілу.
Лише опубліковане: у векторній базі можуть лишитися чанки чернеток або видалених статей. Фільтрую за статусом публікації на рівні запиту — інакше назовні витече те, чого ще немає на сайті.
Модель може передати URL замість slug — get_article приймає і те, і те.
💡 Лайфхак: у моїх статтях на початку є блок «⚡ Коротко». Його текст і став коротким змістом у get_article — безкоштовне summary без генерації через LLM. Якщо у ваших статтях є лід або анотація — використайте їх.
🛡 Розділ 8. Безпека і гроші
Відкритий сервер — це сервер, до якого може підключитися будь-хто, включно з ботами. Кожен виклик пошуку — це ембединг запиту, тобто реальні гроші. Ось що я зробив:
Ліміт на IP: 30 запитів на хвилину. Більше звичайному користувачу не потрібно: при підключенні клієнт робить 2–3 службові запити, далі — по одному на пошук. Що відбувається при перевищенні — нижче.
Реальний IP за проксі. Сайт стоїть за Cloudflare, тому «IP клієнта» в запиті — це IP Cloudflare. Справжній IP — у заголовку CF-Connecting-IP. Якщо брати адресу з'єднання, ліміт стане спільним для всіх користувачів одразу.
Добовий запобіжник: загальний ліміт на весь сервер, наприклад 5000 викликів на добу. Він рахує всі запити разом, тому його не обходять ні багато різних IP, ні підроблений заголовок при зверненні напряму до сервера в обхід Cloudflare.
Ліміт витрат у провайдера ембедингів — остання лінія захисту, яка не залежить від коду застосунку. Найкраще — окремий API-ключ для MCP зі своїм лімітом.
Лише читання. Жоден інструмент нічого не змінює. ChatGPT, до речі, вважає інструменти без позначки «лише читання» такими, що можуть змінювати дані, — тому позначка readOnlyHint має значення.
⚠️ Найнебезпечніша пастка — автоматична реєстрація інструментів. Багато фреймворків самі збирають усі інструменти в застосунку і публікують їх через MCP. У моєму застосунку, крім блогу, є SEO-агент з інструментами для даних Search Console і Google Analytics. Одна необережна конфігурація — і ці дані опинилися б на публічному сервері. Без помилок і попереджень. Що допомагає: тримати MCP-інструменти в окремому модулі, логувати список зареєстрованих інструментів при старті і після кожного деплою перевіряти, що віддає tools/list.
Що відбувається, коли ліміт перевищено: HTTP 429
Ліміт — це не лише «заблокувати зайве». Важливо, як сервер відмовляє: клієнт має зрозуміти, що сталося і коли можна спробувати знову. Інакше модель просто скаже користувачу «сервер не працює».
Лічильник. Я рахую запити в Redis — одним атомарним скриптом:
-- KEYS[1] = "rate_limit:mcp:ip:{ip}",  ARGV[1] = 60 (секунд)
local count = redis.call('INCR', KEYS[1])
if count == 1 then
    redis.call('EXPIRE', KEYS[1], ARGV[1])
end
return count
Чому скрипт, а не два окремі виклики INCR і EXPIRE: якщо між ними щось піде не так (обірветься з'єднання, впаде застосунок), ключ залишиться без терміну життя — і IP буде заблокований назавжди. Скрипт у Redis виконується цілком або ніяк. Такий самий підхід працює з будь-якої мови.
Відповідь при перевищенні. Коли лічильник більший за 30, сервер не виконує пошук, а одразу відповідає:
HTTP/1.1 429
Retry-After: 60
Content-Type: application/json

{"jsonrpc":"2.0","id":null,"error":{"code":-32000,
 "message":"Rate limit exceeded: too many requests from your IP. Retry in a minute."}}
429 — стандартний код «забагато запитів», його розуміє будь-який HTTP-клієнт;
Retry-After: 60 — через скільки секунд можна повторити;
тіло у форматі JSON-RPC — так MCP-клієнт покаже зрозумілу причину, а не «невідому помилку».
Як я це перевірив. 35 запитів поспіль з одного IP:
for i in $(seq 1 35); do
  curl -s -o /dev/null -w "%{http_code}\n" -X POST http://localhost:1911/mcp \
    -H "Content-Type: application/json" \
    -H "Accept: application/json, text/event-stream" \
    -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'
done | sort | uniq -c

  30 200
   5 429
Рівно 30 пройшли, 5 отримали відмову, а через хвилину ліміт скинувся сам.
👤 Два рішення, які я прийняв свідомо: якщо Redis недоступний, запити пропускаються (fail-open) — MCP не повинен лягати через проблеми з кешем. Ціна цього рішення: поки Redis лежить, лімітів немає зовсім, тому остання лінія захисту — ліміт витрат у кабінеті провайдера ембедингів. Для дорогих операцій (генерація через LLM) я б обрав протилежне — відмовляти. І про перевищення ліміту я пишу в лог один раз за хвилину, а не на кожен відхилений запит — інакше бот, який б'ється в ліміт, засмітив би логи тисячами рядків.
Тут же перевіряю безпеку: у списку мають бути лише публічні інструменти, а адмінка сайту має лишатися закритою.
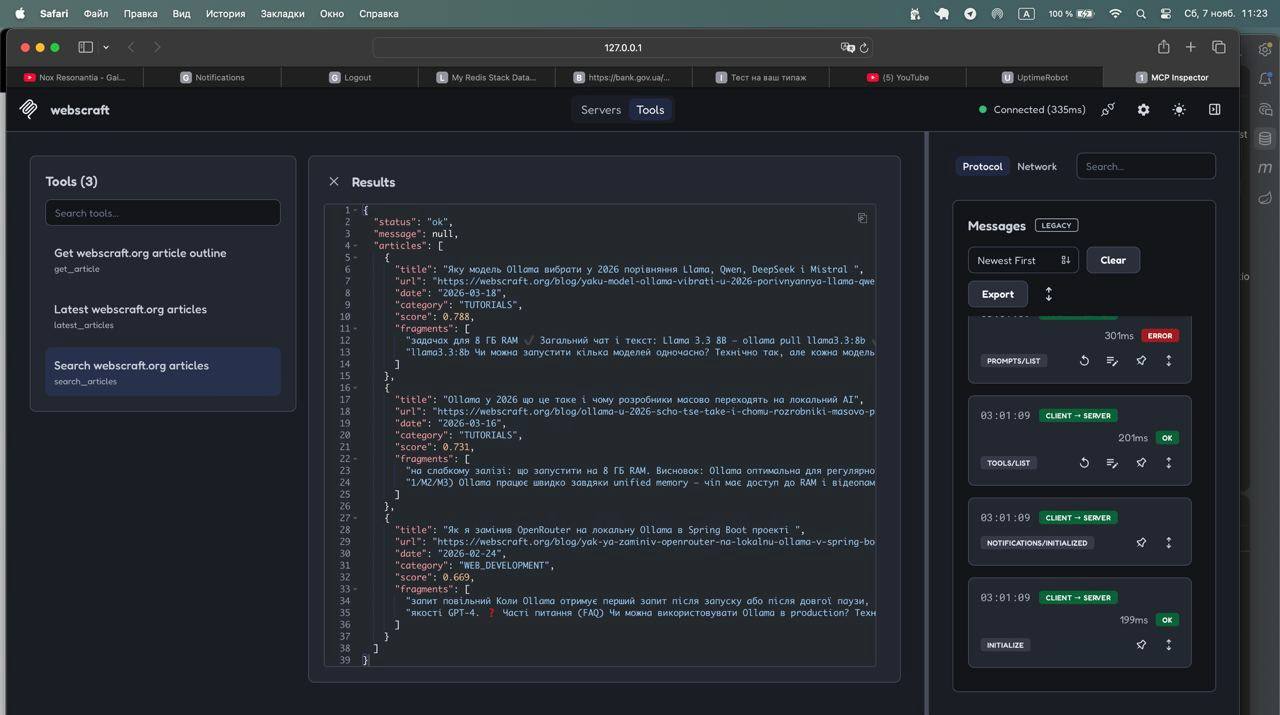
Крок 2. MCP Inspector — офіційний інструмент для налагодження з веб-інтерфейсом. Запускається однією командою:
npx @modelcontextprotocol/inspector
У ньому додаєте сервер з типом Streamable HTTP (не stdio — на цьому легко помилитися), підключаєтеся і викликаєте інструменти вручну. Головна користь — ви бачите свої описи очима клієнта. Якщо опис незрозумілий вам, моделі він теж незрозумілий.
Крок 3. Справжній клієнт. Claude Code, OpenCode, Cursor або веб-версія Claude чи ChatGPT. Ставлю звичайне питання, не згадуючи інструменти, — наприклад, «яку модель Ollama обрати для ноутбука з 8 ГБ RAM? дай джерело» — і дивлюся в логах сервера, який запит сформулювала модель.
Крок 3. Справжній клієнт. Найнаочніше — підключити сервер до веб-версії Claude. Але спершу важливе обмеження:
⚠️ Важливо: веб-клієнти (Claude, ChatGPT) підключаються до MCP-сервера зі своїх серверів, а не з вашого комп'ютера. Тому localhost для них недоступний — перевіряти веб-версії можна лише на сервері з публічною адресою.
1. Задеплойте сервер і перевірте, що він доступний ззовні. Виконайте з будь-якого комп'ютера:
У відповідь має прийти JSON зі списком інструментів. Якщо натомість приходить HTML-сторінка — запит перехопив проксі чи захист від ботів (наприклад, Cloudflare), і для адреси /mcp потрібне правило-виняток.
2. Додайте сервер у Claude. У налаштуваннях Claude відкрийте розділ Connectors → Add custom connector (назви пунктів можуть трохи відрізнятися):
Name: будь-яка зрозуміла назва, наприклад webscraft;
URL:https://ваш-сайт.com/mcp;
авторизацію не вказуйте, якщо сервер відкритий.
3. Поставте звичайне питання. Відкрийте новий чат, переконайтеся, що конектор увімкнений (іконка інструментів біля поля введення), і запитайте, не згадуючи інструменти:
Яку модель Ollama обрати для ноутбука з 8 ГБ RAM? Дай джерело.
Claude сам вирішить викликати пошук, покаже виклик інструмента і відповість із посиланням на статтю. У логах сервера в цей момент видно, яким запитом модель сформулювала питання, — це найцікавіше в перевірці.
Так само сервер підключається до ChatGPT — як власний конектор у режимі розробника, і до Claude Code, Cursor чи OpenCode — у їхніх налаштуваннях MCP.
На що я наступив: клієнт на новій версії протоколу відмовлявся підключатися до сервера на старій; локальні й продакшн-ембединги давали різну релевантність, тому поріг відсіювання довелося калібрувати окремо. Детально про ці та інші помилки — у статті «Типові помилки при створенні MCP-сервера» (скоро).
☕ Розділ 10. Для Java / Spring-розробників
Якщо у вас Spring Boot і Spring AI, MCP-сервер додається у вже існуючий застосунок без окремого сервісу. Стартер:
Інструмент — це звичайний метод бін-класу з анотацією:
@McpTool(
        name = "search_articles",
        description = "Semantic search over webscraft.org ... Always give the user the article URL.",
        annotations = @McpTool.McpAnnotations(readOnlyHint = true))
public SearchResult searchArticles(
        @McpToolParam(description = "Search query, preferably in Ukrainian", required = true) String query,
        @McpToolParam(description = "Number of articles, 1–5", required = false) Integer limit) {
    // пошук, обробка помилок, статус ok / not_found / unavailable
}
Ендпоінт /mcp з'являється автоматично. Два нюанси: у Spring AI 1.1 MCP SDK підтримує версію протоколу 2025-06-18, а свіжі клієнти вже говорять на 2025-11-25 — може знадобитися фільтр сумісності або перехід на Spring AI 2.x. І якщо у вас є Spring Security, не забудьте відкрити /mcp і вимкнути для нього CSRF. Детальний технічний розбір — в окремій статті «MCP-сервер на Spring AI: покроковий розбір» . Основи — у статті Spring AI: що це таке і як використовувати у Spring Boot.
💼 Потрібен MCP для вашого сайту чи компанії?
Ми робимо MCP-сервери під ключ:
Для сайту чи блогу — пошук по статтях, каталогу товарів, документації.
Для внутрішніх документів компанії — регламенти, база знань, договори. Цей підхід ми вже використовуємо в AskYourDocs — платформі пошуку по корпоративних документах.
Для вашого сервісу чи API — щоб клієнти підключали ваш продукт до Claude, ChatGPT і Cursor.
Ваші дані стають доступними в AI-асистентах — з контролем доступу, лімітами і лише тими інструментами, які ви дозволите. Напишіть нам — обговоримо ваш випадок.
❓ Часті питання (FAQ)
Чи потрібно вміти програмувати, щоб зробити MCP-сервер?
Так, MCP-сервер — це код, який працює на сервері. Але для типового випадку «пошук по моїх даних» він невеликий: кілька сотень рядків разом із лімітами і обробкою помилок. Офіційні SDK є для Python, TypeScript, Java, C# та інших мов.
Чи безпечно відкривати MCP-сервер без авторизації?
Так, якщо він віддає лише публічні дані, лише читає і має ліміти запитів. Приватні дані та будь-які інструменти запису — тільки з авторизацією.
Скільки коштує MCP-сервер на місяць?
Якщо він працює у вже існуючому застосунку і віддає фрагменти, а не генерує відповіді, — майже нічого. Основна витрата — ембединг пошукового запиту, а це частки цента за виклик. Добовий ліміт гарантує, що рахунок не вийде за межу.
Чи можна зробити MCP для WordPress чи на Python?
Так. Протокол не залежить від мови: на Python сервер пишеться за допомогою офіційного SDK, а для WordPress можна зробити MCP-сервер поверх його REST API [ПЕРЕВІРИТИ: актуальні плагіни для WordPress]. Принципи з цієї статті — ті самі.
Чи дасть MCP трафік на сайт?
Небагато. Модель дає посилання на статтю, але більшість людей задовольняються відповіддю в чаті. MCP — це про присутність у AI-асистентах і досвід, а не про трафік. [ДОПОВНИТИ ЦИФРАМИ ЧЕРЕЗ 2–3 ТИЖНІ]
Чим MCP відрізняється від плагінів ChatGPT чи GPTs?
Плагіни і GPTs працюють лише в ChatGPT. MCP — відкритий стандарт: один сервер працює з Claude, ChatGPT, Cursor та іншими клієнтами. У ChatGPT MCP-сервери підключаються як власні конектори в режимі розробника.
✅ Висновки
MCP — це спосіб зробити ваші дані інструментом для будь-якого AI-асистента. Для сайту з публічним контентом достатньо трьох інструментів на читання, stateless-транспорту і відкритого доступу з лімітами. Найважливіші рішення — віддавати фрагменти замість готових відповідей, писати описи інструментів як промпт і стежити, щоб назовні не потрапило нічого зайвого.
Для блогу MCP — це передусім витрина і досвід. Справжня цінність цього підходу розкривається там, де дані приватні й живі: документи компанії, CRM, внутрішні сервіси.
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
{
"@type": "Question",
"name": "Чи потрібно вміти програмувати, щоб зробити MCP-сервер?",
"acceptedAnswer": { "@type": "Answer", "text": "Так, MCP-сервер — це код, який працює на сервері. Але для типового випадку «пошук по моїх даних» він невеликий: кілька сотень рядків разом із лімітами і обробкою помилок. Офіційні SDK є для Python, TypeScript, Java, C# та інших мов." }
},
{
"@type": "Question",
"name": "Чи безпечно відкривати MCP-сервер без авторизації?",
"acceptedAnswer": { "@type": "Answer", "text": "Так, якщо він віддає лише публічні дані, лише читає і має ліміти запитів. Приватні дані та будь-які інструменти запису — тільки з авторизацією." }
},
{
"@type": "Question",
"name": "Скільки коштує MCP-сервер на місяць?",
"acceptedAnswer": { "@type": "Answer", "text": "Якщо він працює у вже існуючому застосунку і віддає фрагменти, а не генерує відповіді, — майже нічого. Основна витрата — ембединг пошукового запиту, частки цента за виклик. Добовий ліміт гарантує, що рахунок не вийде за межу." }
},
{
"@type": "Question",
"name": "Чи можна зробити MCP для WordPress чи на Python?",
"acceptedAnswer": { "@type": "Answer", "text": "Так. Протокол не залежить від мови: на Python сервер пишеться за допомогою офіційного SDK, для WordPress — поверх його REST API. Принципи ті самі." }
},
{
"@type": "Question",
"name": "Чи дасть MCP трафік на сайт?",
"acceptedAnswer": { "@type": "Answer", "text": "Небагато. Модель дає посилання на статтю, але більшість людей задовольняються відповіддю в чаті. MCP — це про присутність у AI-асистентах і досвід, а не про трафік." }
},
{
"@type": "Question",
"name": "Чим MCP відрізняється від плагінів ChatGPT чи GPTs?",
"acceptedAnswer": { "@type": "Answer", "text": "Плагіни і GPTs працюють лише в ChatGPT. MCP — відкритий стандарт: один сервер працює з Claude, ChatGPT, Cursor та іншими клієнтами. У ChatGPT MCP-сервери підключаються як власні конектори в режимі розробника." }
}
]
}