Ich habe meinen Blog über MCP an Claude angebunden. Wenn nun jemand Claude fragt „welches Ollama-Modell für 8 GB RAM wählen“, kann das Modell die Antwort selbst in den Artikeln von webscraft.org finden und einen Link dazu geben. In diesem Artikel erkläre ich, was MCP ohne Fachjargon ist, wie es unter der Haube funktioniert und welche Entscheidungen getroffen werden mussten, damit der Server nützlich, sicher und nicht geldverschlingend ist. Die Programmiersprache ist hier nicht wichtig: Die Prinzipien sind für Java, Python, Node.js oder PHP gleich. Wenn Sie nach fertigen MCP-Servern für die Arbeit suchen, sehen Sie sich die Top 10 MCP-Server für Entwickler mit Vor- und Nachteilen sowie Risiken an, und die Fehler, die ich bei der Erstellung meines eigenen gemacht habe, werden im Artikel „Typische Fehler bei der Erstellung eines MCP-Servers“ behandelt.
⚡ Kurz
✅ MCP ist ein Standard, über den KI-Assistenten auf externe Daten und Tools zugreifen. Kein API für andere Websites, sondern eine „Steckdose“ speziell für Claude, ChatGPT, Cursor und andere KI-Clients.
✅ Für einen Blog reichen drei Tools: Suche in Artikeln, Inhaltsverzeichnis und Liste neuer Veröffentlichungen. Das Modell entscheidet selbst, wann es sie aufruft.
✅ Ehrlich über Traffic: MCP bringt fast keine Besucher auf die Website – die Person liest die Antwort in Claude. Es ist eine Visitenkarte und Erfahrung, kein Traffic-Generator.
🎯 Sie erhalten: ein Verständnis dafür, wie MCP funktioniert, welche architektonischen Entscheidungen Sie für Ihre Website treffen sollten und worauf Sie bei der Sicherheit achten müssen.
👇 Unten finden Sie detaillierte Erklärungen, Vergleichstabellen und reale Erfahrungen mit dem Start.
Kurze Antwort: MCP (Model Context Protocol) ist ein offener Standard, der es einem KI-Assistenten ermöglicht, sich mit Ihrem Dienst zu verbinden und ihn als Werkzeug zu nutzen: Daten suchen, lesen und, wenn Sie es erlauben, auch ändern.
Vor MCP war jede Integration separat: ein Plugin für einen Chatbot, ein eigenes Format für einen anderen, ein drittes Format für eine IDE. MCP hat eine „Steckdose“ geschaffen: Sie schreiben einmal einen MCP-Server, und Claude, ChatGPT, Cursor, Claude Code, OpenCode und andere Clients, die das Protokoll unterstützen, verbinden sich damit.
Der Standard wurde Ende 2024 von Anthropic gestartet und im Dezember 2025 an die neu gegründete Agentic AI Foundation unter der Schirmherrschaft der Linux Foundation übergeben. Anthropic, Block und OpenAI wurden Mitbegründer der Stiftung, unterstützt von Google, Microsoft, AWS, Cloudflare und Bloomberg. Das bedeutet, MCP ist kein „Protokoll eines Unternehmens“ mehr, sondern ein neutraler Industriestandard.
⚠️ Hauptmissverständnis: MCP ist kein API, über das andere Websites Anfragen an Ihre senden. Der MCP-Client ist ein KI-Modell. Es liest die Liste Ihrer Tools und entscheidet selbst, wann es sie aufruft. Wenn Sie möchten, dass eine andere Website Ihre Daten von ihrem Backend abruft, ist das ein normales REST API.
Was unterscheidet MCP von REST API:
REST API
MCP
Wer ruft auf
Programmierer schreibt Aufrufs-Code
KI-Modell entscheidet selbst
Wie der Client erfährt, was der Server kann
Dokumentation für Menschen
Server liefert selbst eine Liste von Tools mit Beschreibungen
Für wen die Beschreibung
Für den Entwickler
Für das Modell (Beschreibung = Teil des Prompts)
Typischer Client
Anderer Dienst, Frontend, mobile Anwendung
Claude, ChatGPT, Cursor, KI-Agent
Was MCP nicht kann:
Ersetzt kein API. Andere Websites und Backends greifen nicht über MCP auf Sie zu – dafür benötigen Sie ein normales REST API.
Garantiert nicht, dass Sie aufgerufen werden. Das Modell entscheidet selbst, ob es Ihr Werkzeug benötigt. Eine unklare Beschreibung – und es antwortet einfach mit seinem eigenen Wissen.
Sucht nicht für Sie. MCP ist nur eine „Steckdose“. Die Qualität der Antworten hängt davon ab, wie Sie die Suche innerhalb des Servers implementiert haben.
Erinnert sich nicht an Gespräche. Der Gesprächskontext wird vom Client gehalten; der Server erhält nur einzelne Aufrufe.
Schützt nicht von sich aus. Autorisierung, Limits und was genau nach außen gegeben wird – das ist Ihre Verantwortung.
Fazit des Abschnitts: MCP ist eine Möglichkeit, Ihren Dienst zu einem „Werkzeug“ für jeden KI-Assistenten zu machen, nicht nur zu einem weiteren API.
🌍 Abschnitt 2. Wo MCP bereits verwendet wird und warum es für einen Blog nützlich ist
MCP hat sich am besten dort bewährt, wo KI-Assistenten aktuelle Daten benötigen, die nicht in ihrem Training enthalten sind:
Entwicklung: GitHub hat einen offiziellen MCP-Server für die Arbeit mit Repositories, Issues und Pull Requests; Sentry – für Produktionsfehler; Linear – für Aufgaben. Der Assistent im Code-Editor sieht reale Daten und rät nicht.
Dokumentation: Microsoft Learn hat einen offenen MCP-Server zur Suche in seiner Dokumentation – ohne Authentifizierung, da die Daten öffentlich sind. Context7 liefert aktuelle Dokumentationen von Bibliotheken, damit das Modell keinen Code nach veralteten APIs schreibt.
Business-Dienste: Stripe (Zahlungen), Notion (Wissensdatenbanken), Figma (Design) haben eigene entfernte MCP-Server mit OAuth.
Unternehmensdaten: Interne Vorschriften, CRM, Wissensdatenbanken – das ist das häufigste Szenario in Unternehmen.
Und warum MCP für einen Blog? Als ich zum ersten Mal von MCP hörte, erschien es mir kompliziert: Protokoll, Transporte, Sitzungen, JSON-RPC, und die meisten Materialien begannen sofort mit Code, ohne zu erklären, was es überhaupt ist. Deshalb beschloss ich, es praktisch zu verstehen – ich verband meinen Blog mit MCP und schrieb diesen Leitfaden: Was MCP in einfachen Worten ist, wie es funktioniert und welche Entscheidungen getroffen werden müssen. Ehrlich über Traffic: Er bringt fast keinen Traffic – die Person liest die Antwort in Claude, nicht auf der Website. Aber das Verständnis der Technologie und die Erfahrung, die nun in Kundenprojekten angewendet werden kann, sind es wert.
👤 Aus meiner Erfahrung: Der Blog hat bereits einen RAG-Chat zu Artikeln und einen SEO-Agenten mit Search Console-Daten. MCP war der logische nächste Schritt: die gleiche Vektorsuche, aber nicht nur auf der Website zugänglich, sondern auch in jedem KI-Assistenten.
⚙️ Abschnitt 3. Wie es unter der Haube funktioniert
Die Kommunikation eines Clients mit einem MCP-Server sind normale HTTP POST-Anfragen mit JSON (JSON-RPC-Format). Drei Hauptschritte:
1. initialize   → „Hallo, ich bin Claude, das sind meine Fähigkeiten“
                ← „Hallo, ich bin webscraft, das sind meine Fähigkeiten und Anweisungen“

2. tools/list   → „Welche Werkzeuge hast du?“
                ← search_articles, get_article, latest_articles + Beschreibungen

3. tools/call   → search_articles({"query": "ollama 8 GB RAM"})
                ← 3 Artikel mit Fragmenten und Links
Die ersten beiden Schritte führt der Client einmalig beim Verbindungsaufbau aus. Der dritte Schritt – jedes Mal, wenn das Modell entscheidet, dass es Ihre Daten benötigt.
💡 Das Wichtigste, was man verstehen sollte: Der Gesprächskontext wird vom Client gehalten, nicht vom Server. Wenn der Benutzer „und unter Windows?“ schreibt, weiß der Server nicht, dass es um Ollama geht. Das weiß Claude – und formuliert selbst die vollständige Anfrage: search_articles("ollama windows 8gb"). Ihr Server sucht einfach. Er sieht das Gespräch nicht und muss es sich nicht merken.
Daraus ergibt sich eine wichtige Design-Konsequenz: Jeder Werkzeugaufruf muss eigenständig sein. Alles, was für die Antwort benötigt wird, muss in den Aufrufparametern enthalten sein.
🧩 Kapitel 4. Lösung Nr. 1: Fragmente oder fertige Antwort
Die erste Frage, die ich mir stellte: Ich habe bereits einen RAG-Chat auf der Website, der Fragen entgegennimmt, in der Datenbank sucht und eine Antwort über LLM generiert. Warum nicht über MCP eine fertige Antwort ausgeben?
Der Unterschied liegt darin, wer auf der anderen Seite steht. Der RAG-Chat auf der Website kommuniziert mit einem Menschen – er braucht eine fertige Antwort, deshalb schreibt sie mein Modell. Bei MCP steht auf der anderen Seite bereits ein Modell, und normalerweise ist es stärker als meines. Es braucht keine Umschreibung, sondern die Primärquelle.
Fragmente ausgeben
Fertige Antwort ausgeben
Kosten eines Aufrufs
nur Embedding der Anfrage – Bruchteile eines Cents
Embedding + LLM-Generierung auf Ihre Kosten
Geschwindigkeit
100–300 ms
3–10 s
Qualität
starkes Kundenmodell arbeitet mit der Primärquelle
«stille Post»: Ihr Modell hat umgeschrieben, das Kundenmodell schreibt die Umschreibung um
Flexibilität
Kunde kann die Suche verfeinern, mit anderen Quellen kombinieren
erhält fertigen Text, kann nicht tiefer graben
Risiko
Missbrauch ist billig
jeder Aufruf von irgendjemandem aus dem Internet – Ihre Kosten für LLM
Meine Lösung – Fragmente. Eine fertige Antwort ist nur in zwei Fällen sinnvoll: wenn Ihr RAG etwas tut, das nicht aus Fragmenten wiederholt werden kann (komplexe Geschäftslogik, eigene Rangfolge), oder wenn die Kunden schwache lokale Modelle sind.
Und wenn es keinen RAG und keine Vektordatenbank gibt? MCP verlangt sie nicht. Optionen von einfach bis komplex:
Nur Liste und Inhalt von Artikeln – Werkzeuge «letzte Artikel» und «Inhalt des Artikels». Das Modell orientiert sich an den Titeln.
Volltextsuche – integrierte Website-Suche oder Volltextindex in der Datenbank (z. B. PostgreSQL full-text search). Funktioniert gut, wenn die Anfrage dieselben Wörter enthält wie der Artikel.
Vektorsuche – findet Artikel nach Inhalt, auch wenn die Wörter anders sind («schwacher Laptop» → Artikel über 8 GB RAM). Beste Qualität, aber Embeddings sind erforderlich. Mehr dazu – in den Artikeln über lokales AI und RAG.
🔄 Kapitel 5. Lösung Nr. 2: Session oder Stateless
Für Remote-Server verwendet MCP den Streamable HTTP-Transport. Er hat zwei Modi, und der Unterschied liegt nicht darin, ob der Server «sich an das Gespräch erinnert» (er erinnert sich in keinem Fall), sondern ob er die Verbindung hält.
Mit Session – wie ein Telefonanruf. Bei der Verbindung gibt der Server eine Session-ID aus, der Client fügt sie jeder Anfrage hinzu. Der Server kann den Client zuerst anschreiben: Fortschritt einer langen Operation, Nachricht «die Liste der Werkzeuge hat sich geändert».
Stateless – wie ein Hilfefenster. Jede Anfrage ist unabhängig, der Server speichert nichts und schreibt nicht zuerst – er antwortet nur.
Situation
Mit Session
Stateless
Deployment / Server-Neustart
Sessions verschwinden, der Client erhält einen Fehler und muss sich neu verbinden
die nächste Anfrage wird einfach verarbeitet
Mehrere Instanzen hinter einem Load Balancer
«Sticky Sessions» sind erforderlich
jede Instanz funktioniert
Cloudflare und andere Proxys
lange Verbindungen werden durch Timeout unterbrochen
normale kurze Anfragen
Lange Operationen mit Fortschritt
✅ geeignet
❌ kann nicht
Meine Lösung – stateless. Die Suche dauert 100–300 ms, es gibt nichts zu streamen. Und die Website steht hinter Cloudflare und wird regelmäßig deployed – Sessions hätten hier nur Probleme verursacht. Sessions sind nötig, wenn Ihr Werkzeug Minuten dauert (Berichtgenerierung, Dateiverarbeitung) und den Fortschritt anzeigen muss.
🔐 Kapitel 6. Lösung Nr. 3: Offener Zugang, Token oder OAuth
Der erste Gedanke ist: «Alles muss geschlossen werden». Aber die richtige Antwort hängt davon ab, welche Daten der Server ausgibt und wer sich verbinden wird.
Werkzeuge für sich selbst oder wenige vertrauenswürdige Personen
Webversionen von Claude und ChatGPT erlauben keine Eingabe von Headern – nur Claude Code, Cursor und ähnliche können sich verbinden
OAuth 2.1
der Benutzer klickt auf «Anmelden» und «Erlauben»
persönliche oder Unternehmensdaten vieler Benutzer
ein Autorisierungsserver ist erforderlich – das sind Tage Arbeit
Meine Lösung für den Blog – offener Zugang mit Limits. Artikel sind ohnehin öffentlich – sie können auf der Website gelesen oder von einem Crawler gesammelt werden. Ein Token hätte hier nichts geschützt, sondern die größte Zielgruppe abgeschnitten: Webclients von Claude und ChatGPT unterstützen nur Verbindungen ohne Authentifizierung oder mit OAuth.
Antipatterns, die es zu vermeiden gilt:
❌ Ein gemeinsames Token, das auf der Seite «Wie verbinden» veröffentlicht wird. Das ist kein Schutz mehr: der Schlüssel ist bei allen. Entweder den Server öffnen oder jedem einzeln Schlüssel geben.
❌ Schlüssel in der URL (/mcp?key=...). URLs landen in Server-Logs, Proxys und im Browserverlauf.
❌ OAuth für öffentliche Daten «nur für den Fall». Tage Arbeit und eine Barriere für Benutzer ohne jeglichen Nutzen.
❌ Offener Zugang zu privaten Daten. Analysen, Kundendaten, interne Dokumente – nur mit Authentifizierung.
❌ Schreibwerkzeuge ohne Authentifizierung. Nur Lesen kann offen sein.
Für den Blog habe ich drei Werkzeuge erstellt, und alle lesen nur:
Werkzeug
Was wird zurückgegeben
Wozu
search_articles(query, limit)
bis zu 5 Artikel: Titel, URL, Datum, Kategorie, Relevanz und 1–2 Fragmente
Hauptszenario – Antwort finden
get_article(slug)
Titel, URL, kurze Zusammenfassung und Liste der Abschnitte (ohne Volltext)
sehen, was sonst noch im Artikel steht
latest_articles(limit)
letzte Veröffentlichungen
«was gibt es Neues im Blog?»
Beschreibung entscheidet, ob Sie überhaupt aufgerufen werden
Das Modell sieht nur den Namen, die Beschreibung und die Parameter des Werkzeugs. Anhand dieser entscheidet es, ob es sich lohnt, es aufzurufen. Daher ist die Beschreibung keine Dokumentation, sondern Teil des Prompts. Was ich hineinschreibe:
Worum es bei den Daten geht – «ukrainischsprachiger technischer Blog: AI-Werkzeuge, lokale LLMs, Spring Boot, RAG, SEO»;
Wann aufrufen – «wenn der Benutzer fragt, wie etwas in diesen Themen gemacht wird, oder nach einer Quelle fragt»;
Wie man die Anfrage besser formuliert – «schreibe query auf Ukrainisch» (Blog auf Ukrainisch, so ist die Suche genauer);
Was mit dem Ergebnis zu tun ist – «das sind Fragmente, keine vollständigen Artikel: gib dem Benutzer immer einen Link».
Ich schreibe die Beschreibungen auf Englisch: Modelle verstehen beide Sprachen gleich gut, und Englisch ist für verschiedene Clients universeller.
Antwort mit Status
Das Modell muss zwischen «Artikel nicht gefunden» und «Server kaputt» unterscheiden – davon hängt ab, was es dem Benutzer sagt. Daher hat jede Antwort ein Feld status:
{"status": "ok",          "articles": [...]}
{"status": "not_found",   "message": "Nichts gefunden auf webscraft.org für diese Anfrage."}
{"status": "unavailable", "message": "Suche vorübergehend nicht verfügbar. Versuchen Sie es später erneut."}
Fragment-Hygiene
Größe: bis zu ~900 Zeichen pro Fragment und nicht mehr als 1–2 Fragmente pro Artikel. Sonst kommen statt fünf verschiedener Artikel fünf Teile eines einzigen, und der Kontext des Clients wird in einem Aufruf aufgebraucht.
Wortabschnitte: beim Zerlegen von Text in Stücke (Chunks) beginnen sie oft mitten im Wort. Ich schneide einen solchen Abschnitt bis zum ersten Leerzeichen ab.
Nur veröffentlichte: in der Vektordatenbank können noch Chunks von Entwürfen oder gelöschten Artikeln sein. Ich filtere nach dem Veröffentlichungsstatus auf Anfrageebene – sonst sickert nach außen, was noch nicht auf der Website ist.
Das Modell kann eine URL anstelle eines Slugs übergeben – get_article akzeptiert beides.
💡 Lifehack: In meinen Artikeln gibt es am Anfang einen Block «⚡ Kurz». Sein Text wurde zum kurzen Inhalt in get_article – eine kostenlose Zusammenfassung ohne LLM-Generierung. Wenn Ihre Artikel eine Einleitung oder eine Zusammenfassung haben – nutzen Sie diese.
🛡 Kapitel 8. Sicherheit und Geld
Ein offener Server ist ein Server, mit dem sich jeder verbinden kann, einschließlich Bots. Jeder Suchaufruf ist ein Embedding der Anfrage, also echtes Geld. Hier ist, was ich getan habe:
Limit pro IP: 30 Anfragen pro Minute. Mehr braucht ein normaler Benutzer nicht: bei der Verbindung macht der Client 2–3 Service-Anfragen, danach – eine pro Suche. Was passiert bei Überschreitung – weiter unten.
Reale IP hinter Proxy. Die Website steht hinter Cloudflare, daher ist die «Client-IP» in der Anfrage die IP von Cloudflare. Die echte IP – im Header CF-Connecting-IP. Wenn man die Verbindungsadresse nimmt, wird das Limit für alle Benutzer gleichzeitig gelten.
Tägliche Sicherung: ein Gesamtlimit für den gesamten Server, z. B. 5000 Aufrufe pro Tag. Es zählt alle Anfragen zusammen, daher wird es weder von vielen verschiedenen IPs umgangen noch von gefälschten Headern bei direkter Serveransprache umgangen, die Cloudflare umgeht.
Ausgabenlimit beim Embedding-Anbieter – die letzte Verteidigungslinie, die nicht vom Anwendungscode abhängt. Am besten – ein separater API-Schlüssel für MCP mit eigenem Limit.
Nur Lesen. Kein Werkzeug ändert etwas. ChatGPT betrachtet übrigens Werkzeuge ohne die Markierung «nur Lesen» als solche, die Daten ändern können – daher hat die Markierung readOnlyHint Bedeutung.
⚠️ Die gefährlichste Falle – automatische Registrierung von Werkzeugen. Viele Frameworks sammeln selbst alle Werkzeuge in der Anwendung und veröffentlichen sie über MCP. In meiner Anwendung gibt es neben dem Blog einen SEO-Agenten mit Werkzeugen für Search Console und Google Analytics Daten. Eine unvorsichtige Konfiguration – und diese Daten wären auf einem öffentlichen Server gelandet. Ohne Fehler und Warnungen. Was hilft: MCP-Werkzeuge in einem separaten Modul halten, die Liste der registrierten Werkzeuge beim Start protokollieren und nach jedem Deployment prüfen, was tools/list ausgibt.
Was passiert, wenn das Limit überschritten wird: HTTP 429
Das Limit ist nicht nur «das Überflüssige blockieren». Wichtig ist, wie der Server ablehnt: der Client muss verstehen, was passiert ist und wann er es erneut versuchen kann. Sonst sagt das Modell dem Benutzer einfach «Server funktioniert nicht».
Zähler. Ich zähle Anfragen in Redis – mit einem atomaren Skript:
-- KEYS[1] = "rate_limit:mcp:ip:{ip}",  ARGV[1] = 60 (Sekunden)
local count = redis.call('INCR', KEYS[1])
if count == 1 then
    redis.call('EXPIRE', KEYS[1], ARGV[1])
end
return count
Warum ein Skript und nicht zwei separate Aufrufe von INCR und EXPIRE: wenn dazwischen etwas schiefgeht (Verbindung unterbrochen, Anwendung stürzt ab), bleibt der Schlüssel ohne Lebensdauer – und die IP wird für immer blockiert. Das Skript in Redis wird ganz oder gar nicht ausgeführt. Ein ähnlicher Ansatz funktioniert in jeder Sprache.
Antwort bei Überschreitung. Wenn der Zähler größer als 30 ist, führt der Server keine Suche aus, sondern antwortet sofort:
HTTP/1.1 429
Retry-After: 60
Content-Type: application/json

{"jsonrpc":"2.0","id":null,"error":{"code":-32000,
 "message":"Rate limit exceeded: too many requests from your IP. Retry in a minute."}}
429 – Standardcode «zu viele Anfragen», den jeder HTTP-Client versteht;
Retry-After: 60 – nach wie vielen Sekunden man es erneut versuchen kann;
Body im JSON-RPC-Format – so zeigt der MCP-Client einen verständlichen Grund und keine «unbekannte Fehlermeldung».
Wie ich das getestet habe. 35 Anfragen hintereinander von einer IP:
for i in $(seq 1 35); do
  curl -s -o /dev/null -w "%{http_code}\n" -X POST http://localhost:1911/mcp \
    -H "Content-Type: application/json" \
    -H "Accept: application/json, text/event-stream" \
    -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'
done | sort | uniq -c

  30 200
   5 429
Genau 30 liefen durch, 5 erhielten eine Ablehnung, und nach einer Minute wurde das Limit selbst zurückgesetzt.
👤 Zwei Entscheidungen, die ich bewusst getroffen habe: Wenn Redis nicht verfügbar ist, werden Anfragen durchgelassen (fail-open) – MCP sollte wegen Cache-Problemen nicht ausfallen. Der Preis dieser Entscheidung: Solange Redis ausfällt, gibt es überhaupt keine Limits, daher ist die letzte Verteidigungslinie – das Ausgabenlimit im Kundenbereich des Embedding-Anbieters. Für teure Operationen (LLM-Generierung) hätte ich das Gegenteil gewählt – ablehnen. Und über die Limitüberschreitung schreibe ich einmal pro Minute ins Log, nicht bei jeder abgewiesenen Anfrage – sonst würde ein Bot, der gegen das Limit stößt, die Logs mit Tausenden von Zeilen zumüllen.
Hier überprüfe ich auch die Sicherheit: In der Liste sollten nur öffentliche Tools enthalten sein, während die Website-Administration geschlossen bleiben muss.
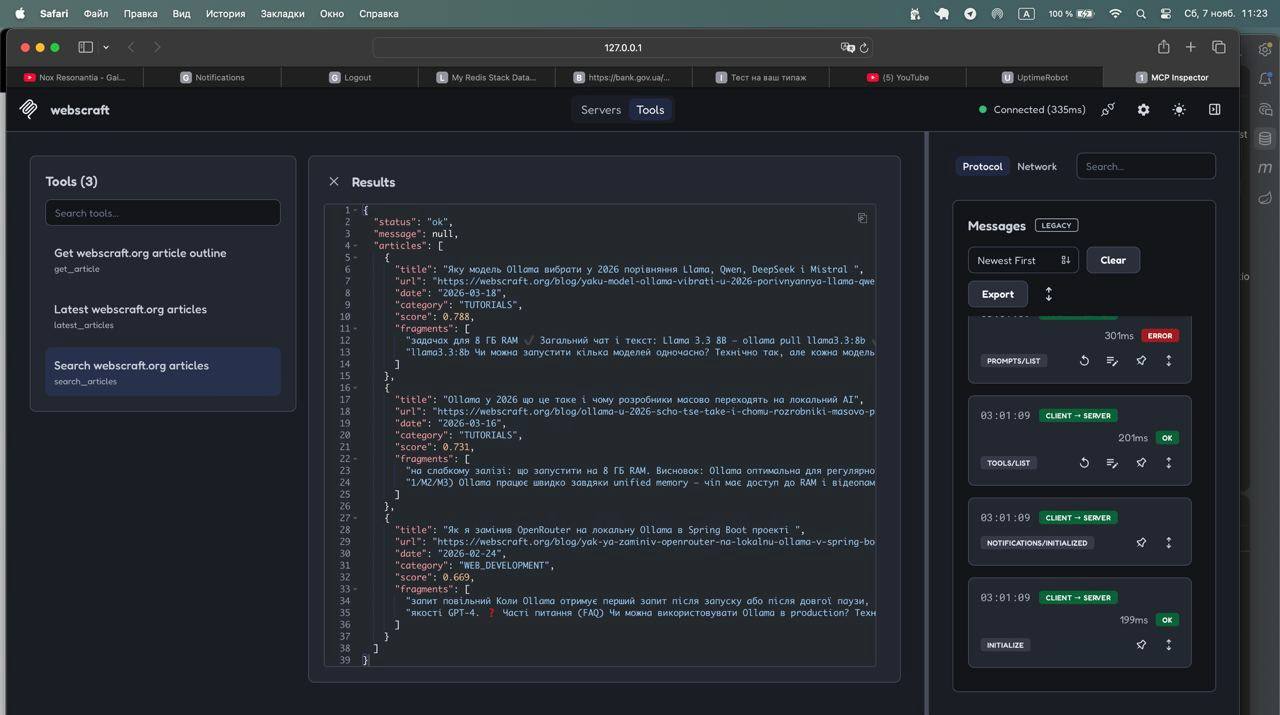
Schritt 2. MCP Inspector – das offizielle Tool für das Debugging mit einer Weboberfläche. Es wird mit einem einzigen Befehl gestartet:
npx @modelcontextprotocol/inspector
Fügen Sie dort den Server mit dem Typ Streamable HTTP hinzu (nicht stdio – hier kann man sich leicht irren), verbinden Sie sich und rufen Sie die Tools manuell auf. Der Hauptvorteil ist, dass Sie Ihre Beschreibungen mit den Augen des Clients sehen. Wenn eine Beschreibung für Sie unverständlich ist, ist sie auch für die Modelle unverständlich.
Schritt 3. Echter Client. Claude Code, OpenCode, Cursor oder die Webversion von Claude oder ChatGPT. Ich stelle eine normale Frage, ohne die Tools zu erwähnen – zum Beispiel: „Welches Ollama-Modell sollte ich für einen Laptop mit 8 GB RAM wählen? Gib die Quelle an“ – und schaue in den Server-Logs, welche Anfrage das Modell formuliert hat.
Schritt 3. Echter Client. Am anschaulichsten ist es, den Server mit der Webversion von Claude zu verbinden. Aber zuerst eine wichtige Einschränkung:
⚠️ Wichtig: Webclients (Claude, ChatGPT) verbinden sich mit dem MCP-Server von ihren Servern aus, nicht von Ihrem Computer. Daher ist localhost für sie nicht zugänglich – Sie können Webversionen nur auf einem Server mit einer öffentlichen Adresse testen.
1. Stellen Sie den Server bereit und stellen Sie sicher, dass er von außen erreichbar ist. Führen Sie dies von jedem Computer aus:
Als Antwort sollte ein JSON mit der Liste der Tools kommen. Wenn stattdessen eine HTML-Seite zurückkommt, hat ein Proxy oder ein Bot-Schutz (z. B. Cloudflare) die Anfrage abgefangen, und für die Adresse /mcp ist eine Ausnahmeregel erforderlich.
2. Fügen Sie den Server in Claude hinzu. Öffnen Sie in den Claude-Einstellungen den Abschnitt Connectors → Add custom connector (die Namen der Punkte können leicht abweichen):
Name: Ein beliebiger verständlicher Name, z. B. webscraft;
URL:https://ihre-website.com/mcp;
Geben Sie keine Autorisierung an, wenn der Server offen ist.
3. Stellen Sie eine normale Frage. Öffnen Sie einen neuen Chat, stellen Sie sicher, dass der Connector aktiviert ist (Symbol der Tools neben dem Eingabefeld) und fragen Sie, ohne die Tools zu erwähnen:
Welches Ollama-Modell sollte ich für einen Laptop mit 8 GB RAM wählen? Gib die Quelle an.
Claude entscheidet selbst, ob er eine Suche aufrufen soll, zeigt den Aufruf des Tools an und antwortet mit einem Link zu einem Artikel. In den Server-Logs ist zu diesem Zeitpunkt sichtbar, mit welcher Anfrage das Modell die Frage formuliert hat – das ist das Interessanteste an der Überprüfung.
Ebenso wird der Server mit ChatGPT verbunden – als eigener Connector im Entwicklermodus, und mit Claude Code, Cursor oder OpenCode – in deren MCP-Einstellungen.
Worauf ich gestoßen bin: Ein Client mit einer neuen Protokollversion weigerte sich, sich mit einem Server mit der alten zu verbinden; lokale und Produktions-Embeddings lieferten unterschiedliche Relevanz, daher musste der Schwellenwert für die Filterung separat kalibriert werden. Details zu diesen und anderen Fehlern – im Artikel „Typische Fehler bei der Erstellung eines MCP-Servers“ (bald).
☕ Kapitel 10. Für Java / Spring-Entwickler
Wenn Sie Spring Boot und Spring AI verwenden, wird der MCP-Server zu einer bestehenden Anwendung hinzugefügt, ohne einen separaten Dienst zu benötigen. Starter:
Ein Tool ist eine normale Methode einer Bean-Klasse mit einer Annotation:
@McpTool(
        name = "search_articles",
        description = "Semantic search over webscraft.org ... Always give the user the article URL.",
        annotations = @McpTool.McpAnnotations(readOnlyHint = true))
public SearchResult searchArticles(
        @McpToolParam(description = "Search query, preferably in Ukrainian", required = true) String query,
        @McpToolParam(description = "Number of articles, 1–5", required = false) Integer limit) {
    // Suche, Fehlerbehandlung, Status ok / not_found / unavailable
}
Der Endpunkt /mcp erscheint automatisch. Zwei Nuancen: In Spring AI 1.1 unterstützt das MCP SDK die Protokollversion 2025-06-18, und neuere Clients sprechen bereits 2025-11-25 – ein Kompatibilitätsfilter oder ein Upgrade auf Spring AI 2.x kann erforderlich sein. Und wenn Sie Spring Security haben, vergessen Sie nicht, /mcp zu öffnen und CSRF dafür zu deaktivieren. Eine detaillierte technische Analyse – in einem separaten Artikel „MCP-Server auf Spring AI: Schritt-für-Schritt-Analyse“. Grundlagen – im Artikel Spring AI: Was es ist und wie man es in Spring Boot verwendet.
💼 Benötigen Sie MCP für Ihre Website oder Ihr Unternehmen?
Wir erstellen MCP-Server schlüsselfertig:
Für Websites oder Blogs – Suche nach Artikeln, Produktkatalogen, Dokumentationen.
Für interne Unternehmensdokumente – Vorschriften, Wissensdatenbanken, Verträge. Diesen Ansatz nutzen wir bereits in AskYourDocs – einer Plattform für die Suche in Unternehmensdokumenten.
Für Ihren Dienst oder Ihre API – damit Kunden Ihr Produkt mit Claude, ChatGPT und Cursor verbinden können.
Ihre Daten werden in KI-Assistenten verfügbar – mit Zugriffskontrolle, Limits und nur den von Ihnen erlaubten Tools. Schreiben Sie uns – wir besprechen Ihren Fall.
❓ Häufig gestellte Fragen (FAQ)
Muss ich programmieren können, um einen MCP-Server zu erstellen?
Ja, ein MCP-Server ist Code, der auf dem Server läuft. Aber für den typischen Fall „Suche in meinen Daten“ ist er klein: ein paar hundert Zeilen inklusive Limits und Fehlerbehandlung. Offizielle SDKs gibt es für Python, TypeScript, Java, C# und andere Sprachen.
Ist es sicher, einen MCP-Server ohne Autorisierung zu öffnen?
Ja, wenn er nur öffentliche Daten liefert, nur liest und Anfragelimits hat. Private Daten und alle Schreibwerkzeuge – nur mit Autorisierung.
Wie viel kostet ein MCP-Server pro Monat?
Wenn er in einer bestehenden Anwendung läuft und Fragmente liefert, anstatt Antworten zu generieren, – fast nichts. Die Hauptkosten sind das Embedding der Suchanfrage, das sind Bruchteile eines Cents pro Aufruf. Ein Tageslimit garantiert, dass die Rechnung nicht aus dem Ruder läuft.
Kann man einen MCP für WordPress oder in Python erstellen?
Ja. Das Protokoll ist sprachunabhängig: In Python wird der Server mit dem offiziellen SDK erstellt, und für WordPress kann ein MCP-Server über dessen REST API erstellt werden [PRÜFEN: aktuelle WordPress-Plugins]. Die Prinzipien aus diesem Artikel sind dieselben.
Wird MCP Traffic auf die Website bringen?
Nicht viel. Das Modell liefert einen Link zum Artikel, aber die meisten Leute sind mit der Antwort im Chat zufrieden. MCP steht für Präsenz in KI-Assistenten und Erfahrung, nicht für Traffic. [MIT ZAHLEN IN 2–3 WOCHEN ERGÄNZEN]
Was unterscheidet MCP von ChatGPT-Plugins oder GPTs?
Plugins und GPTs funktionieren nur in ChatGPT. MCP ist ein offener Standard: Ein Server funktioniert mit Claude, ChatGPT, Cursor und anderen Clients. In ChatGPT werden MCP-Server als eigene Konnektoren im Entwicklermodus verbunden.
✅ Schlussfolgerungen
MCP ist eine Möglichkeit, Ihre Daten zu einem Werkzeug für jeden KI-Assistenten zu machen. Für eine Website mit öffentlichen Inhalten reichen drei Lese-Tools, ein zustandsloser Transport und offener Zugang mit Limits. Die wichtigsten Entscheidungen sind: Fragmente anstelle von fertigen Antworten zu liefern, Tool-Beschreibungen als Prompts zu schreiben und darauf zu achten, dass nichts Überflüssiges nach außen gelangt.
Für einen Blog ist MCP in erster Linie eine Visitenkarte und ein Erlebnis. Der wahre Wert dieses Ansatzes entfaltet sich dort, wo Daten privat und lebendig sind: Unternehmensdokumente, CRM, interne Dienste.
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
{
"@type": "Question",
"name": "Muss ich programmieren können, um einen MCP-Server zu erstellen?",
"acceptedAnswer": { "@type": "Answer", "text": "Ja, ein MCP-Server ist Code, der auf dem Server läuft. Aber für den typischen Fall „Suche in meinen Daten“ ist er klein: ein paar hundert Zeilen inklusive Limits und Fehlerbehandlung. Offizielle SDKs gibt es für Python, TypeScript, Java, C# und andere Sprachen." }
},
{
"@type": "Question",
"name": "Ist es sicher, einen MCP-Server ohne Autorisierung zu öffnen?",
"acceptedAnswer": { "@type": "Answer", "text": "Ja, wenn er nur öffentliche Daten liefert, nur liest und Anfragelimits hat. Private Daten und alle Schreibwerkzeuge – nur mit Autorisierung." }
},
{
"@type": "Question",
"name": "Wie viel kostet ein MCP-Server pro Monat?",
"acceptedAnswer": { "@type": "Answer", "text": "Wenn er in einer bestehenden Anwendung läuft und Fragmente liefert, anstatt Antworten zu generieren, – fast nichts. Die Hauptkosten sind das Embedding der Suchanfrage, Bruchteile eines Cents pro Aufruf. Ein Tageslimit garantiert, dass die Rechnung nicht aus dem Ruder läuft." }
},
{
"@type": "Question",
"name": "Kann man einen MCP für WordPress oder in Python erstellen?",
"acceptedAnswer": { "@type": "Answer", "text": "Ja. Das Protokoll ist sprachunabhängig: In Python wird der Server mit dem offiziellen SDK erstellt, für WordPress – über dessen REST API. Die Prinzipien sind dieselben." }
},
{
"@type": "Question",
"name": "Wird MCP Traffic auf die Website bringen?",
"acceptedAnswer": { "@type": "Answer", "text": "Nicht viel. Das Modell liefert einen Link zum Artikel, aber die meisten Leute sind mit der Antwort im Chat zufrieden. MCP steht für Präsenz in KI-Assistenten und Erfahrung, nicht für Traffic." }
},
{
"@type": "Question",
"name": "Was unterscheidet MCP von ChatGPT-Plugins oder GPTs?",
"acceptedAnswer": { "@type": "Answer", "text": "Plugins und GPTs funktionieren nur in ChatGPT. MCP ist ein offener Standard: Ein Server funktioniert mit Claude, ChatGPT, Cursor und anderen Clients. In ChatGPT werden MCP-Server als eigene Konnektoren im Entwicklermodus verbunden." }
}
]
}