Warum Gemma 4 26B langsam ist und wann sie gewinnt — 2026
Die Wahrheit über Gemma 4 26B MoE, die in Werbeübersichten nicht erwähnt wird. Swapping auf Mac 24 GB, 2 Tokens/Sek., Flash Attention Bugs.
Nützliche Artikel zu Java, Spring, SEO, Frontend und modernen Technologien. Tipps, Beispiele und Lifehacks für Entwickler
Die Wahrheit über Gemma 4 26B MoE, die in Werbeübersichten nicht erwähnt wird. Swapping auf Mac 24 GB, 2 Tokens/Sek., Flash Attention Bugs.
Was ist der Thinking Mode in Gemma 4, wie funktioniert er über Ollama, wie kann man ihn mit /no_think verkürzen oder deaktivieren. Echte Tests auf M1 16 GB
Was ist Gemma 4, welche Modellgrößen gibt es, die Apache 2.0 Lizenz, ein Vergleich mit Gemma 3 nach Benchmarks und wie man es über Ollama startet. Vollständiger Überblick
Teste Gemma 4 über Ollama auf MacBook Pro M1 16 GB. Vergleich mit Qwen3:8b und Mistral Nemo bei realen Aufgaben: Generierung von Spring Boot Code und Text. Ehrliche Bewer
tool_choice auto vs required, Description als Prompt, Halluzination durch Konfidenz — wie LLMs entscheiden zu suchen und wie man es steuert. Java + Spring AI mit Code.
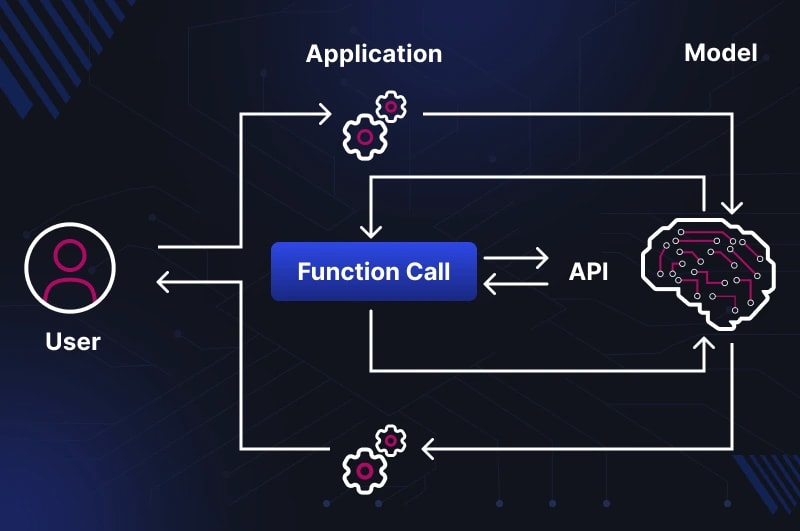
LLMs führen keine Funktionen aus – sie beschreiben sie in JSON. Wir analysieren tool_choice, den vollständigen Aufrufzyklus, den Unterschied zwischen RAG-Pipeline und Too
27 березня 2026 року Google запустив перший широкий Core Update року. Офіційне формулювання — «регулярне оновлення для покращення релевантності результатів». Але за лаштунками тисячі сайтів побачили падіння кліків і показів у Google Search Console. При цьому Google прямо каже: штрафів...
Wie ChatGPT, Claude und Gemini wirklich trainiert werden: Pre-Training, SFT, RLHF, DPO, RLVR. Reale Kosten, Skalierungsgesetze und die neue Ära der synthetischen Daten 20
Vor 3 Tagen habe ich mich mit einem Freund über Vibe Coding und Gemini gestritten. Er will eine Million. Ich bin ein Entwickler. Hier ist, was ich ihm gesagt habe – und w
Wie ich BM25 zur Vektorsuche in einem produktiven RAG-Dienst auf pgvector hinzugefügt habe. Migration, RRF, kundenspezifische Konfiguration – mit Code und Fallstricken.
Wie Hybrid Search (BM25 + Vektor + RRF) und Reranking die RAG-Qualität ohne Modelländerung verbessern. Architektur, Code für Qdrant, Vergleich von Rerankern, Entscheidung
Warum findet ChatGPT ein Dokument ohne exakte Wortübereinstimmung? Wir erklären, was Embeddings sind, wie das Modell Bedeutung kodiert und wo es eingesetzt wird – ohne un
Ви побудували RAG-систему, відповіді генеруються, retrieval працює. Але як дізнатися, чи працює він на 90% запитів чи на 55%? Eyeball evaluation не скейлиться: variance між ревьюерами, нульове покриття edge cases, неможливість відловити регресії. Спойлер: п'ять метрик + 50...
ChromaDB, Qdrant або pgvector: як обрати Vector DB Проблема: Ви запустили перший RAG на ChromaDB — все працює: ~50 000 документів, відповіді стабільні. Але з’являється нова вимога: масштабування. Менеджер очікує мільйон документів, DevOps ставить під сумнів окрему vector DB, якщо...
Ви додали документи у свій RAG-пайплайн, написали запит — і система знаходить відповідь. Але як саме? Чому вона обирає цей фрагмент, а не сусідній? І чому іноді повертає повну нісенітницю? Спойлер: за кожним RAG-пошуком стоїть математика кутів у просторі тисячі вимірів — і її можна...
RAG для PDF: як задавати питання по документах Ви хочете задавати питання по своєму PDF — договору, звіту чи документації. Копіюєте код із туторіалу, запускаєте — і отримуєте беззмістовні відповіді або помилки. Проблема майже ніколи не в LLM. Вона виникає ще на першому кроці —...
RAG-модель видає дивні або хибні відповіді? Не поспішайте звинувачувати LLM. Часто причина криється у chunking-стратегії — саме те, як ви розбиваєте дані. Факт: 60–70% якості відповідей RAG визначається правильним розбиттям контенту на chunks. ⚡ Коротко...
Якщо ти вже запускаєш Ollama на 8 ГБ RAM — і тебе цікавить чи варто оновитись до 16 ГБ — ця стаття дає конкретну відповідь. Не «більше RAM — краще», а що саме відкривається, які моделі стають доступними і де апгрейд не має сенсу. Якщо ще не читав про 8 ГБ tier —...
🔍 Джерело: WebCraft.org · 🌐 Genspark Claw · 🌐 Claude Cowork · 🌐 Perplexity Computer У першому кварталі 2026 року з'явилися одразу три AI-агенти, які претендують на роль «цифрового працівника»: Genspark Claw (березень), Perplexity Computer (лютий) та Claude Cowork (січень). Усі три обіцяють...
Genspark hat Claw gestartet – einen KI-Agenten auf einem dedizierten Cloud-PC. Workspace 4.0, Runde $385M, Preise ab $39.99/Monat. Wir analysieren, was sich geändert hat
Was sind Tokens, wie funktioniert BPE-Tokenisierung, warum kyrillische Zeichen dreimal teurer sind und wie viel Sie 2026 für die API von GPT-4o, Claude, Gemini bezahlen w
Ви побудували RAG-пайплайн, підключили LLM, налаштували vector store — а пошук повертає нерелевантні результати. Проблема майже завжди не в LLM, а в embedding-моделі. Саме вона визначає, наскільки точно система розуміє зміст тексту і знаходить правильні фрагменти....
Щоразу, коли ви відправляєте повідомлення в ChatGPT, Claude або Gemini, за лічені секунди відбувається щось неймовірно складне: система, навчена на трильйонах слів, прогнозує наступний токен, зважує контекст тисяч попередніх слів і генерує відповідь, яка здається осмисленою. Але як саме це працює...
Перша година після підключення Spring AI — і застосунок не стартує. NoUniqueBeanDefinitionException: expected single matching bean but found 2: ollamaChatModel, openAiChatModel. Гугл каже додати spring.ai.openai.chat.enabled=false. Не працює. Документація мовчить. Це була тільки...
RAG mit Ollama – wie Sie lokale KI ohne erneutes Training auf Ihren PDFs und Dokumenten antworten lassen. Schritt-für-Schritt-Erklärung der Pipeline,