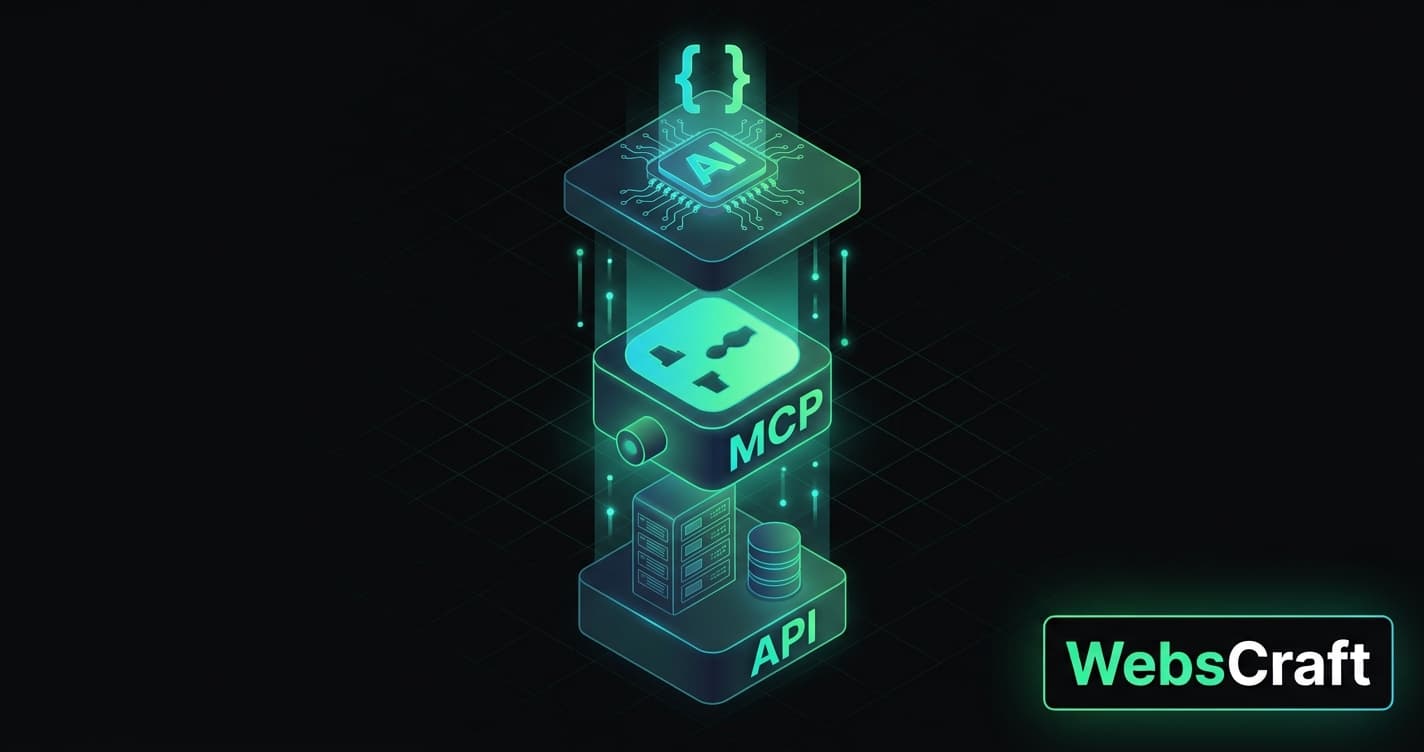
MCP, API і function calling постійно порівнюють між собою, ніби треба обрати щось одне. Насправді це три різні рівні, які працюють разом. Я покажу різницю не на абстрактних схемах, а на одному реальному завданні — пошуку по статтях мого блогу, який у мене існує одразу в кількох формах: сторінка пошуку для людей, інструмент для внутрішнього AI-агента і MCP-сервер OpenCode . На цьому прикладі добре видно, що кожен рівень робить, як правильно і неправильно перетворити endpoint на інструмент для моделі і коли що обирати.
⚡ Коротко
✅ Це не три альтернативи, а три рівні: API — як сервіс віддає дані, function calling — як модель просить викликати функцію, MCP — як інструменти доставляються в AI-застосунок.
✅ Модель нічого не виконує сама. Вона лише пропонує виклик; виконує застосунок — і з function calling, і з MCP.
✅ Головна помилка — обгортати endpoint 1:1. Моделі потрібна задача («знайти статтю»), а не всі технічні параметри API.
✅ Вибір простий: немає LLM серед споживачів — API; агент лише у вашому застосунку — function calling; ваші інструменти мають бути доступні чужим AI-клієнтам — MCP.
🎯 Ви отримаєте: чітку межу між трьома поняттями, приклад правильної обгортки і таблицю «що обрати у вашій ситуації».
👇 Нижче — розбір на реальному коді, порівняльні таблиці і п'ять поширених міфів.
Коротка відповідь: API, function calling і MCP відповідають на три різні питання.
API — як сервіс віддає дані і приймає команди. Контракт між програмами: endpoint, параметри, формат відповіді. Про AI він нічого не знає.
Function calling — як модель просить викликати функцію. Механізм самої моделі: їй передають список функцій з описами, і замість тексту вона може повернути «виклич функцію X з такими аргументами».
MCP — як інструменти потрапляють в AI-застосунок. Протокол доставки: сервер описує свої інструменти, а будь-який сумісний клієнт (Claude, ChatGPT, Cursor, ваш агент) підключає їх без окремої інтеграції.
У реальному виклику всі три рівні працюють разом, один над одним:
Модель           ── function calling: «виклич search_articles("ollama 8 ГБ")»
   ↓
AI-застосунок     ── отримує пропозицію, вирішує, чи виконувати
(Claude, агент)
   ↓
MCP               ── передає виклик на MCP-сервер (tools/call)
   ↓
MCP-сервер        ── виконує пошук
   ↓
API / база даних  ── звідки сервер бере дані
💡 Чому їх взагалі порівнюють: усі три стосуються того, як щось «викликати». Але порівнювати їх як альтернативи — як порівнювати HTTP, REST і браузер: це різні шари однієї системи. Корисніше питання — не «що краще», а «який шар мені потрібно будувати».
⚙️ Розділ 2. Function calling за хвилину
Детально механіку function calling, JSON schema і зв'язок із RAG я розбирав у статті Tool Use vs Function Calling. Тут — лише те, що потрібно для порівняння.
Застосунок передає моделі разом із питанням список функцій: назву, опис і JSON schema параметрів. Модель або відповідає текстом, або повертає структуровану пропозицію: «виклич search_articles з аргументом query = "ollama 8 ГБ"». Застосунок виконує функцію, повертає результат моделі — і вона формує відповідь.
⚠️ Ключовий момент, який часто пропускають: модель нічого не виконує. Вона лише пропонує виклик. Виконує завжди застосунок — і саме він вирішує, чи варто це робити: перевіряє права, питає підтвердження у користувача. Це межа безпеки, і вона однакова і для function calling, і для MCP.
будь-який MCP-клієнт: Claude, ChatGPT, Cursor, агенти
Як споживач дізнається, що доступно
документація, OpenAPI
ви передаєте список функцій у запиті до моделі
сервер сам віддає список (tools/list)
Для кого опис
для розробника
для моделі
для моделі
Хто виконує виклик
код споживача
ваш застосунок
MCP-сервер за командою клієнта
Транспорт
HTTP, gRPC тощо
немає — це частина запиту до моделі
stdio (локально) або Streamable HTTP
Де живе код
у сервісі
у вашому застосунку, поруч з моделлю
в окремому сервері, доступному ззовні
Хто може використати
будь-хто з доступом
лише ваш застосунок
будь-який AI-клієнт, який ви підключите
Висновок розділу: function calling і MCP схожі тим, що опис пишеться для моделі. Різниця — у тому, хто може скористатися інструментом: лише ваш застосунок чи будь-який AI-клієнт.
🔍 Розділ 4. Один пошук — три способи
На webscraft.org пошук по статтях існує в кількох формах — і це найкраща ілюстрація різниці.
Спосіб 1. API: пошук для програм і людей
На сайті є сторінка пошуку для людей. Якби інший сервіс захотів шукати по моїх статтях зі свого бекенду, йому потрібен був би JSON-endpoint на зразок такого (публічного JSON API пошуку в мене немає — це ілюстрація, як він виглядав би):
GET /api/articles/search?q=ollama+8gb&limit=3

[
  {"title": "Яку модель Ollama обрати у 2026...", "url": "https://webscraft.org/blog/...", "score": 0.73},
  ...
]
Розробник читає документацію, пише код виклику, обробляє відповідь. AI тут ні до чого.
Спосіб 2. Function calling: інструмент для мого власного агента
У мене є SEO-агент, який аналізує дані Search Console. Щоб він не радив написати статтю, яка вже є, у нього є інструмент пошуку схожих статей. У Spring AI це звичайний метод з анотацією (спрощено):
@Tool(description = "Find existing webscraft.org articles similar to a phrase. "
        + "Use before suggesting a new article to check if the topic is already covered.")
public List<SimilarArticle> findSimilarArticles(String phrase, String lang) {
    return similarityService.findSimilar(phrase, lang, 5);
}

// у сервісі агента:
chatClient.prompt(question)
        .tools(gscTools, gaTools, demandTools)   // моделі передаються описи цих методів
        .call();
Модель бачить опис і може запропонувати виклик, Spring AI виконує метод і повертає результат моделі. Але цей інструмент існує лише всередині мого застосунку. Ні Claude, ні Cursor про нього не знають і скористатися ним не можуть.
Спосіб 3. MCP: той самий пошук для будь-якого AI-клієнта
Щоб пошуком могли користуватися Claude, ChatGPT чи Cursor, я зробив MCP-сервер з інструментом search_articles:
@McpTool(
        name = "search_articles",
        description = "Semantic search over webscraft.org — a Ukrainian-language tech blog ... "
                + "Always give the user the article URL.",
        annotations = @McpTool.McpAnnotations(readOnlyHint = true))
public SearchResult searchArticles(String query, Integer limit) {
    // пошук, обробка помилок, статус ok / not_found / unavailable
}
Код майже такий самий, як у способі 2. Різниця — у доставці: тепер будь-який MCP-клієнт підключається за адресою https://webscraft.org/mcp, сам отримує список інструментів і викликає їх. Як я робив цей сервер і які рішення приймав — у статті MCP-сервер для сайту.
API
@Tool (function calling)
MCP
Хто користується
інші програми
лише мій SEO-агент
Claude, ChatGPT, Cursor, будь-який агент
Де код
контролер сайту
усередині застосунку агента
окремий пакет з власним endpoint
Що підтримувати
версії API, документацію
опис для моделі
опис для моделі, ліміти, безпеку публічного доступу
👤 З мого досвіду: найцікавіше, що всі три способи використовують один і той самий векторний пошук по базі. Змінюється лише «обгортка» і те, хто може нею скористатися. Саме тому питання «MCP чи API» майже завжди хибне: ви не обираєте між ними, ви обираєте, кому відкрити доступ.
✂️ Розділ 5. Наївна обгортка 1:1 vs обгортка під задачу
Найпоширеніша помилка при створенні інструментів для моделі — взяти внутрішній метод або endpoint і віддати його «як є».
Як зазвичай роблять
Мій внутрішній пошук має багато технічних параметрів. Наївна обгортка показала б їх усі:
search_articles(
    query,          // текст запиту
    minScore,       // поріг схожості, 0..1
    candidates,     // скільки найближчих чанків брати до групування
    perPost,        // скільки фрагментів з однієї статті
    locale,         // uk, en, de, es
    page, size,     // пагінація
    sort,           // score | date
    includeDrafts   // чи включати чернетки
)
Чому це погано:
Модель не знає правильних значень. Який minScore ставити — 0.3 чи 0.7? Це залежить від моделі ембедингів і калібрується на реальних даних. Модель вгадуватиме — і вгадуватиме по-різному в кожному виклику.
Більше параметрів — більше помилок. Кожен параметр — ще одне рішення, яке модель може прийняти неправильно, і довший опис, який з'їдає контекст.
Небезпечні параметри опиняються зовні.includeDrafts у публічному інструменті — це прямий шлях до витоку неопублікованих статей.
Внутрішня реалізація стає контрактом. Захочу змінити алгоритм групування — доведеться ламати інтерфейс для всіх клієнтів.
Те саме стосується автоматичної генерації MCP-інструментів з OpenAPI-специфікації: це швидко, але ви отримуєте саме наївну обгортку — один інструмент на кожен endpoint, з усіма технічними параметрами.
Як зробив я
search_articles(
    query,   // що шукати,
    limit    // скільки статей, 1–5, за замовчуванням 3
)
Усе інше — всередині сервера: поріг схожості відкалібрований і задається конфігурацією, не більше двох фрагментів на статтю, лише українські опубліковані статті, лише перша сторінка результатів. Модель відповідає лише на питання «що шукаємо» і «скільки».
💡 Чому саме так: моделі потрібні задачі, а не endpoints. Інструмент має відповідати на питання «що користувач хоче зробити», а не «які параметри є в базі». Хороше правило: якщо параметр має «правильне» значення, яке ви знаєте краще за модель, — він не повинен бути параметром.
📦 Розділ 6. Що виносити в MCP, а що ні
Агреговані інструменти краще за дрібні. Замість трьох інструментів «знайти статтю», «отримати текст», «отримати метадані» — один пошук, який одразу повертає заголовок, посилання, дату і релевантні фрагменти. Кожен зайвий крок — це ще один виклик, ще одна можливість помилитися і ще трохи контексту.
Читання — сміливо, запис — обережно. Інструменти, що лише читають, безпечні навіть у відкритому доступі. Інструменти, що змінюють дані (створити, видалити, надіслати, оплатити), потребують авторизації, підтвердження користувача і окремого рішення для кожного.
Що краще лишити тільки в API:
Детерміновані інтеграції сервіс-сервіс — синхронізація, вебхуки, імпорт. Там не потрібна модель, яка «вирішує», там потрібна передбачуваність.
Масові операції — оновити тисячу записів одним викликом моделі не варто.
Платежі й незворотні дії — або лишити в API, або винести в MCP лише з явним підтвердженням людини.
Не віддавайте все одразу. Чим більше інструментів бачить модель, тим частіше вона обирає не той. Для блогу мені вистачило трьох. Що робити, коли інструментів десятки, — у статті Tool RAG: що робити, коли у агента забагато інструментів.
🧭 Розділ 7. Коли API, коли function calling, коли MCP
Ситуація
Що обрати
Чому
Інший сервіс чи фронтенд отримує ваші дані
API
споживач — програма, потрібна передбачуваність і документований контракт
AI-агент усередині вашого застосунку, одна модель
Function calling (@Tool)
інструменти не потрібні нікому, крім вашого агента; немає мережі, авторизації, окремого деплою
Ваші дані мають бути доступні в Claude, ChatGPT, Cursor
MCP
чужі клієнти не бачать ваших @Tool; MCP — єдиний стандартний спосіб їх підключити
Кілька внутрішніх агентів у компанії мають користуватися одними інструментами
MCP
один сервер замість копії інструментів у кожному агенті
Ваш агент має користуватися чужими сервісами (GitHub, база даних)
MCP-клієнт у вашому застосунку
готові MCP-сервери вже існують — не треба писати інтеграції самому
Масова синхронізація, вебхуки, платежі
API
тут модель не потрібна і навіть заважає
На практиці ці варіанти часто співіснують. У мене пошук по статтях є і в SEO-агенті як @Tool, і в MCP-сервері для зовнішніх клієнтів — над одним і тим самим сервісом пошуку. Добрий шлях розвитку: почати з @Tool, а коли з'являються зовнішні споживачі — винести ці ж інструменти в MCP.
🧩 Розділ 8. П'ять міфів про різницю
Міф 1. «MCP замінить API».
Ні. MCP працює поверх API чи бази даних — мій MCP-сервер сам звертається до бази. Інтеграції без моделі, вебхуки, мобільні застосунки як працювали через API, так і працюватимуть.
Міф 2. «Function calling і MCP — це одне й те саме».
Ні, це різні рівні. Function calling — механізм моделі: як вона просить виклик. MCP — спосіб доставити інструменти в застосунок. Клієнт MCP отримує інструменти з сервера і передає їх моделі через звичайний function calling. Модель навіть не знає, що інструмент прийшов через MCP.
Міф 3. «З MCP модель сама викликає ваш API».
Ні. Модель пропонує виклик, а виконує його застосунок-клієнт — і він може відмовити, спитати користувача або обмежити права. Це важливо для безпеки: відповідальність за виклик — на застосунку, а не на моделі.
Міф 4. «MCP-сервер — це OpenAPI, перетворений на інструменти».
Технічно так можна, і такі генератори існують. Але результат — наївна обгортка з розділу 5: усі технічні параметри зовні, один інструмент на endpoint. Хороший MCP-сервер проєктують під задачі, а не копіюють з API.
Міф 5. «Якщо є function calling, MCP не потрібен».
Наполовину правда. Якщо агент живе лише у вашому застосунку — так, вистачить function calling (розділ 7). Але щойно ваші інструменти потрібні Claude, Cursor чи іншим агентам, function calling не допоможе: він не вміє «доставити» інструмент у чужий застосунок.
🚫 Розділ 9. Коли все це НЕ потрібно
Серед споживачів немає LLM. Якщо вашими даними користуються лише програми і люди через інтерфейс — потрібен звичайний API. Ні function calling, ні MCP не додадуть нічого, крім складності.
Один застосунок і одна модель. Якщо AI-агент живе лише у вашому сервісі і ніхто ззовні його інструментами не користуватиметься — вистачить @Tool. MCP-сервер додасть мережу, ліміти, безпеку публічного доступу і ще один endpoint, за яким треба стежити.
Модель не потребує живих даних. Якщо відповідь можна дати із загальних знань чи статичного тексту в промпті — інструменти взагалі зайві.
❓ Часті питання (FAQ)
MCP — це API?
У широкому сенсі — так, це програмний інтерфейс. Але він призначений для AI-застосунків: сервер сам описує свої інструменти мовою, зрозумілою моделі, а клієнт підключає їх без окремої інтеграції. Звичайний REST API для інших сервісів він не замінює.
Чи замінить MCP REST?
Ні. MCP працює поверх REST, баз даних та інших сервісів. Інтеграції без моделі — синхронізація, вебхуки, мобільні застосунки — і далі працюватимуть через API.
Чи можна згенерувати MCP-сервер з OpenAPI?
Можна, і для швидкого прототипу це нормально. Але згенеровані інструменти копіюють структуру API: усі технічні параметри і по одному інструменту на endpoint. Для продакшну краще спроєктувати кілька інструментів під задачі користувача.
Чи працює function calling без MCP?
Так. Function calling — механізм самої моделі, він з'явився раніше за MCP. Якщо інструменти потрібні лише вашому застосунку, ви передаєте їх моделі напряму, без жодного MCP-сервера.
✅ Висновки
API, function calling і MCP — не конкуренти, а три рівні однієї системи: як сервіс віддає дані, як модель просить виклик і як інструменти потрапляють в AI-застосунок. Тому правильне питання — не «що краще», а «хто має користуватися моїми інструментами». Лише програми — API. Лише ваш агент — function calling. Будь-який AI-клієнт — MCP.
І незалежно від рівня — проєктуйте інструменти під задачі, а не під endpoints: менше параметрів, розумні значення за замовчуванням усередині, лише те, що безпечно віддавати назовні. Як це виглядає на реальному MCP-сервері — у статті MCP-сервер для сайту, а помилки, на які легко наступити, — у статті «Типові помилки при створенні MCP-сервера» .