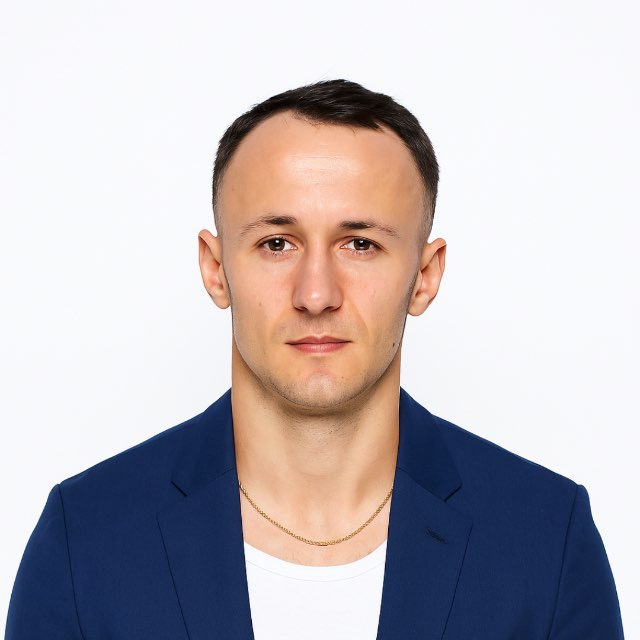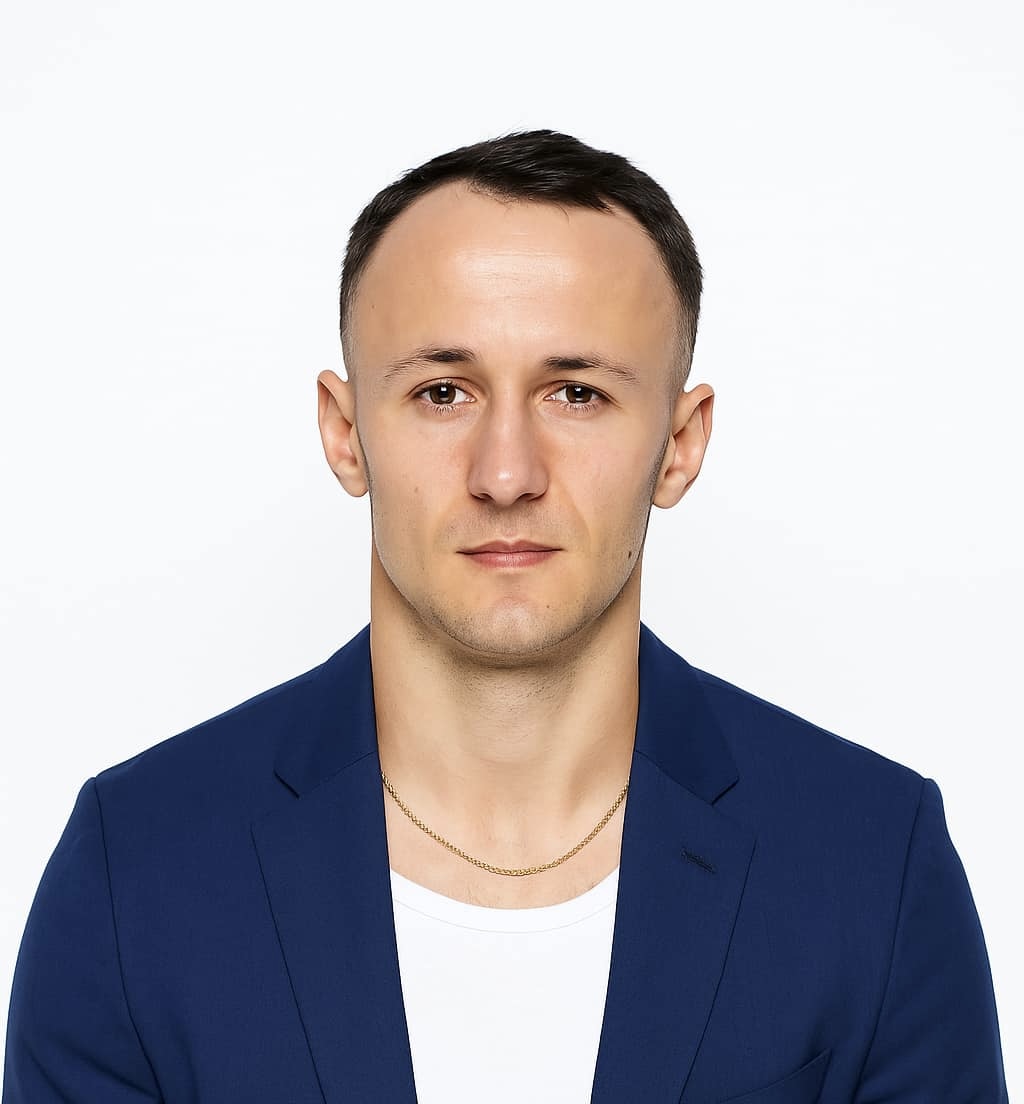
Mein Name ist Vadym Kharovyuk. Ich bin ein Java Backend-Entwickler mit acht Jahren Erfahrung
im Spring-Ökosystem. Heute ist meine Hauptspezialisierung – KI-Lösungen für Unternehmen
in Java: Dokumentensuche, KI-Assistenten, Integrationen mit Sprachmodellen
und Anbindung von Diensten an ChatGPT und Claude.
Parallel zu kommerziellen Projekten führe ich einen technischen Blog
webscraft.org/blog –
ich schreibe über reale Anwendungsfälle aus eigener Erfahrung, nicht über Umschreibungen von Dokumentationen.
📚 Inhalt
⸻
🎯 Über mich
32 Jahre alt, arbeite remote mit Kunden aus verschiedenen Ländern. Ich bin bewusst in die IT eingestiegen – nach dem Studium
erkannte ich, dass ich Produkte entwickeln und nicht nur Code nach einer technischen Spezifikation schreiben wollte. Die ersten Jahre – monolithische Spring Boot Anwendungen, Datenbanken,
REST APIs. Mit der Zeit – Microservices, Message Queues, komplexe Integrationen
mit externen Diensten. Und seit 2024 – tiefes Eintauchen in KI-Integrationen
und die Entwicklung eigener SaaS-Produkte auf Basis großer Sprachmodelle.
Heute arbeite ich hauptsächlich mit dem KI-Stack: Vektorsuche, RAG,
Integrationen mit LLMs und MCP-Servern – alles in Java und Spring. Das ist eine seltene Kombination:
die meisten KI-Lösungen werden in Python geschrieben, und ich helfe Unternehmen, deren Backend
bereits in Java ist, KI hinzuzufügen, ohne einen separaten Dienst in einer anderen Sprache.
Dabei bin ich für den gesamten Zyklus verantwortlich: vom Design der Architektur
bis zum Deployment in die Produktion mit Monitoring und Support. Ich denke nicht nur über den Code nach,
sondern auch über Skalierbarkeit, Infrastrukturkosten, die Erfahrung des Endnutzers
und die Geschäftslogik des Produkts insgesamt.
Der beste Weg, eine Technologie zu verstehen, ist, etwas Reales darauf aufzubauen
und es bis zur Produktion zu bringen. Theorie ohne Praxis ist
nur schönes Gerede im Lebenslauf.
💡 Wie ich Ihrem Unternehmen helfen kann
Ohne technischen Jargon – was Sie bekommen. Fachbegriffe in kleiner Schrift
für diejenigen, die es verstehen wollen; Erklärungen – im Glossar unten.
🔍 KI-Suche in Ihren Dokumenten
Mitarbeiter stellen Fragen in natürlicher Sprache – „welche Rückgabebedingungen
gelten im Lieferantenvertrag?“ – und erhalten in Sekundenschnelle eine Antwort
mit einem Link zum spezifischen Dokument. Ohne stundenlanges Durchblättern von Ordnern
und die Suche nach „wo ist diese Datei“.
Technisch: RAG, Vektorsuche, pgvector
💬 KI-Assistent auf Ihrer Website
Besucher erhalten rund um die Uhr Antworten auf Fragen zu Ihren Dienstleistungen oder Produkten
– basierend auf Ihren Informationen. Weniger wiederholte Fragen an den Support, mehr Anfragen.
Technisch: LLM-Integration, RAG
🤖 Ihre Website oder Ihr Dienst – zugänglich für ChatGPT und Claude
Kunden, die KI-Assistenten nutzen, können Ihre Produkte,
Artikel oder Daten direkt im Chat finden – und Links zu Ihnen sehen. Ein neuer Kanal,
auf dem es derzeit wenig Konkurrenz gibt. Wie das in der Praxis funktioniert – habe ich am
Beispiel meines eigenen Blogs gezeigt.
Technisch: MCP-Server
⚙️ KI in Ihrem bestehenden Produkt
Automatische Zusammenfassungen, Klassifizierung von Anfragen, Texterstellung, Analysen –
ich integriere dies in das bereits funktionierende System, ohne es von Grund auf neu zu schreiben.
Die Daten bleiben unter Ihrer Kontrolle.
Technisch: LLM-Integrationen (OpenAI, Claude, lokale Modelle über Ollama)
🧩 Backend für Webprodukte
Eine solide Grundlage für Dienste: Authentifizierung, Zahlungen, Benutzerkonten,
mobile Version. Von einfachen APIs bis hin zu vollständigen Produkten.
Technisch: Java, Spring Boot, PostgreSQL, PWA
⸻
📂 Eigenes Produkt: AskYourDocs
AskYourDocs – eine B2B-Plattform
für die Suche in Unternehmensdokumenten. Ein Unternehmen lädt seine Verträge,
Anleitungen und Vorschriften hoch, und Mitarbeiter stellen Fragen in natürlicher Sprache
und erhalten Antworten mit Quellenangaben.
Die Schlüsselentscheidung – eine separate isolierte Installation für jeden Kunden.
Die Dokumente eines Unternehmens überschneiden sich physisch nicht mit den Daten eines anderen,
was für vertrauliche Daten und DSGVO-Anforderungen wichtig ist.
- Suche nach Inhalt, nicht nach Wörtern – findet die Antwort, auch wenn sie im Dokument anders formuliert ist
- Antworten mit Quellen – der Benutzer sieht, aus welchem Dokument die Informationen stammen, und kann sie überprüfen
- Datenisolation – Single-Tenant-Installation für jeden Kunden
Stack – Java, Spring Boot, Spring AI, PostgreSQL + pgvector.
🌐 KI-Infrastruktur webscraft.org
Mein Blog ist nicht nur eine Sammlung von Artikeln, sondern auch ein Testfeld für KI-Lösungen,
die ich dann in Kundenprojekten einsetze. Alles läuft in der Produktion.
-
KI-Chat zu Blog-Artikeln – beantwortet Fragen von Lesern
basierend auf den Artikeln und gibt Quellenangaben an. RAG auf pgvector und Spring AI.
-
Öffentlicher MCP-Server – Claude, ChatGPT-kompatible Clients und OpenCode
können direkt im Chat nach Blog-Artikeln suchen. Semantische Suche, Rate Limiting
mit Redis, Schutz durch Cloudflare. Solche Implementierungen in Java sind bisher selten.
Details – im Artikel über den MCP-Server für Websites.
-
SEO-Agent – sammelt täglich Daten von Google Search Console und GA4,
analysiert sie mit LLMs und Tools (Spring AI tools) und sendet
Berichte mit Empfehlungen per E-Mail.
🤖 Neues Projekt: KI-Plattform für die Kommunikation mit Charakteren
Eine vollwertige SaaS-Plattform, auf der Benutzer mit KI-Charakteren kommunizieren –
Psychologen, Mentoren, Begleiter, Komiker, romantische Charaktere
und andere. Jeder Charakter hat seinen eigenen Charakter, Kommunikationsstil
und ein Langzeitgedächtnis über den Benutzer. Bald in Produktion.
Das Projekt wurde komplett selbstständig entwickelt – von der Architektur bis zum Deployment.
Kein Demo- oder Pet-Projekt, sondern ein vollwertiges Produkt mit Abrechnung,
KI-Gedächtnis, semantischer Suche und echter Infrastruktur
auf Railway.
Was ist drin:
-
Spring AI 2.0 + LLM-Integration – OpenRouter als
einheitliches Gateway zu verschiedenen Modellen: DeepSeek V4 Flash als Hauptmodell,
separate Modelle für romantische und provokative Charaktere
(sao10k/l3.3-euryale-70b), Gemini für den Support. Umschaltung
der Modelle über die Konfiguration ohne Codeänderung.
-
KI-Gedächtnis und RAG – Langzeitgedächtnissystem
basierend auf pgvector: extractAllFacts extrahiert 11 Felder aus dem Dialog
in einem LLM-Aufruf, hybride Suche über Reciprocal Rank Fusion
(Vektorsuche + PostgreSQL FTS), semantische und episodische
Zusammenfassungen mit Caffeine-Cache.
-
Streaming über SSE – Antworten des Charakters werden
Token für Token über Server-Sent Events gestreamt, Stopp-Taste zum Unterbrechen,
Token-Warteschlange mit Tippanimation.
-
Abrechnung – WayForPay Prepaid-Integration (einziges
Zahlungssystem in der Ukraine ohne Einzelunternehmer), Token-basiertes Zahlungsmodell,
Abonnements FREE/BASIC/PRO mit unterschiedlichen Limits, Webhook mit Unterstützung
für JSON und form-urlencoded.
-
Szenen und Rollenspiele – Szenensystem mit KI-generiertem
Plot: Auswahl von Tags → LLM generiert Entwurf → Speichern.
Romantische Dates, Detektivermittlungen, Klassentreffen.
-
Telegram-Integration – Kommunikation mit Charakteren
direkt in Telegram, Kontobindung, separater Bot für lokale
Entwicklung, um Konflikte mit dem Produktionsbot zu vermeiden.
-
Moderation und Sicherheit – KeywordCrisisDetectionService,
Reaktionen des Charakters auf Nachrichten, Altersverifizierung für
provokative Inhalte.
-
SEO-Optimierung – separate SEO-Controller für den Katalog
und Charakterseiten, Slug-Routing, JSON-LD Structured Data,
OG-Tags, Sitemap.
-
Infrastruktur – Railway (Spring Boot + pgvector PostgreSQL),
Docker mit G1GC-Tuning, Cloudinary für Bilder, ngrok für
lokale Webhook-Entwicklung.
Der gesamte Stack – Java 21, Spring Boot 3, Spring AI 2.0, PostgreSQL + pgvector,
Thymeleaf + Bootstrap 5, OpenRouter, WayForPay, Cloudinary, Telegram Bot API –
wurde von einer Person entworfen, geschrieben und wird unterstützt.
🚀 Eines meiner Projekte: Kazki AI
Kazki AI ist ein Dienst für personalisierte Hörspiele für Kinder, bei dem das Kind der Hauptdarsteller der Geschichte ist. Eltern geben den Namen des Kindes, seine Interessen und Lieblingscharaktere ein – das System generiert eine einzigartige Geschichte und liest sie mit einer KI-Stimme über ElevenLabs vor.
Das Projekt wurde komplett selbst entwickelt – von der Architektur bis zum Deployment.
Kein Pet-Projekt für den Lebenslauf, sondern ein lebendiger Produktionsservice mit einem Zahlungssystem, Abonnements, Push-Benachrichtigungen für iOS und Android
und echten Nutzern.
Was steckt drin:
-
KI-gestützte Inhaltserstellung – OpenAI generiert den Text der Geschichte
unter Berücksichtigung des Namens und der Vorlieben des Kindes, ElevenLabs liest das Ergebnis
mit natürlicher Stimme vor
-
Zahlungssystem – Stripe mit Abonnementmodell:
verschiedene Preispläne, Zugriffskontrolle, Webhook-Verarbeitung von Ereignissen
-
PWA ohne App Store – Installation auf dem Startbildschirm,
Offline-Modus, Push-Benachrichtigungen über die Web Push API (VAPID)
auf iOS 16.4+ und Android
-
Authentifizierung – Spring Security + OAuth2 (Google),
CSRF-Schutz, Sitzungsverwaltung über Redis
-
SEO und Performance – serverseitiges Rendering
über Thymeleaf, Caching auf Redis-Ebene, Bildoptimierung
über Cloudinary
-
Datenbank – PostgreSQL mit durchdachtem Schema:
Benutzer, Geschichten, Abonnements, Push-Abonnements, Zahlungsereignisse
Der gesamte Stack – Spring Boot, PostgreSQL, Redis, ElevenLabs, Stripe,
Cloudinary, PWA – ist von einer Person in der Produktion bereitgestellt und wird betreut.
👗 Kommerzielles Projekt: FashionI
FashionI ist ein Online-Bekleidungsgeschäft mit einem integrierten KI-System, das ich entwickelt habe, um Kunden in natürlicher Sprache zu verstehen. Anstelle von Standardfiltern und Kategorien –
der Käufer beschreibt einfach, was er sucht: „schwarzes Kleid für eine Hochzeit, Budget 80 $, Größe M“.
Ich habe ein System implementiert, das automatisch die benötigten Produkte findet,
die passende Größe unter Berücksichtigung der Besonderheiten jeder Marke auswählt,
bei der Bestellabwicklung und Rücksendungen hilft und personalisierte
Empfehlungen basierend auf dem Browserverlauf anbietet.
Was ich für das Geschäft gelöst habe:
-
Steigerung der Konversionsrate – ich habe dafür gesorgt, dass Kunden schneller
die richtigen Kleidungsstücke finden, ohne Dutzende von Seiten mit Filtern durchsuchen zu müssen
-
Reduzierung von Retouren – ich habe eine intelligente Größenauswahl entwickelt,
die Körpermaße und die spezifischen Schnitte jeder Marke berücksichtigt
-
Automatisierung des Supports – ich habe einen KI-Agenten eingerichtet, der selbstständig
Fragen zu Bestellungen, Lieferung und Rücksendungen beantwortet
-
Personalisierung ohne Komplexität – ich habe Empfehlungen implementiert, die
automatisch basierend auf dem Nutzerverhalten generiert werden
-
Einsparungen bei der Entwicklung – ich habe ein einheitliches System geschaffen, das
einzelne Module für Suche, Support, Empfehlungen und Größenauswahl ersetzt
Wie es für den Kunden funktioniert:
- Der Kunde gibt eine Anfrage in natürlicher Sprache über den Chat auf der Website ein
- Die KI versteht, was genau benötigt wird: Kategorie, Farbe, Größe, Budget
- Das System zeigt genau die Produkte an, die der Käufer sucht
- Bei Bedarf hilft es bei der Größenauswahl und schließt die Bestellung ab
Ich habe die Architektur des Multi-Agenten-Systems komplett selbst entworfen,
die Interaktion zwischen den Agenten konfiguriert, die semantische Suche für
ein präzises Verständnis von Anfragen implementiert und das Projekt zu einem voll funktionsfähigen Zustand gebracht.
⸻
🛠️ Technologiestack
KI – Hauptspezialisierung
- Spring AI – Integration von LLMs in Spring-Anwendungen, Tools / Function Calling
- RAG und Vektorsuche – pgvector, Embeddings, Chunking, hybride Suche (Vektor + Volltext)
- MCP – Server für Claude, ChatGPT und andere KI-Clients (Streamable HTTP, STDIO)
- LLM-Anbieter – OpenRouter, OpenAI API, Gemini, DeepSeek
- Lokale Modelle – Ollama, LM Studio (für private Daten ohne Cloud)
- Streaming von Antworten – Server-Sent Events
- ElevenLabs – Sprachsynthese (Text-to-Speech)
Backend
- Java 21 – Hauptsprache
- Spring Boot – Produktionsanwendungen jeder Komplexität
- Spring Security – Authentifizierung, OAuth2, JWT, CSRF
- Spring Data JPA / Hibernate, JdbcClient – Arbeit mit relationalen Datenbanken
- Spring MVC / REST API – Erstellung von HTTP-Schnittstellen
- Spring Cloud – Microservice-Patterns
Datenbanken
- PostgreSQL + pgvector – Hauptdatenbank, insbesondere für Vektorsuche
- MySQL – Alternative für bestimmte Projekttypen
- Redis – Caching, Sitzungen, Ratenbegrenzung
Nachrichtenwarteschlangen und Asynchronität
- Apache Kafka – Streaming von Daten, ereignisgesteuerte Architektur
- RabbitMQ – asynchrone Warteschlangen für Microservices
Frontend und PWA
- Thymeleaf – serverseitiges Rendering mit SEO
- JavaScript, HTML, CSS, Tailwind
- PWA (Service Worker, Web App Manifest)
- Web Push API / VAPID – Push-Benachrichtigungen auf iOS und Android
Zahlungen und Integrationen
- Stripe, WayForPay – Abonnements, Webhooks
- Telegram Bot API
- Google Search Console API, GA4 API
- Cloudinary – Medien-Speicher und Bildoptimierung
DevOps und Infrastruktur
- Docker – Containerisierung
- Railway / Render – Deployment von Produktionsanwendungen
- Cloudflare – CDN, Schutz, Kontrolle von KI-Crawlern
- GitHub Actions – CI/CD-Pipelines
💼 Was ich für Kunden tue
In acht Jahren kommerzieller Entwicklung habe ich einen Ansatz entwickelt, der sowohl für Start-ups in der Frühphase als auch für etablierte Unternehmen
mit Legacy-Systemen gut funktioniert. Von kleinen REST-APIs bis hin zu vollwertigen SaaS-Plattformen
mit KI-Integrationen, Abrechnung und Tausenden von Benutzern.
Ich beginne mit der Architektur, nicht mit dem Code
Bevor ich die erste Zeile schreibe – analysieren wir die Geschäftsaufgabe,
identifizieren wir die Engpässe und wählen den Stack für den spezifischen
Anwendungsfall aus. Monolithisches Spring Boot oder Microservices – das hängt vom
Umfang und dem Team ab, nicht von der Mode. Ich zwinge kein Over-Engineering auf,
wo eine einfache Lösung ausreicht, und vereinfache nicht, wo eine
ernsthafte Architektur erforderlich ist.
Vollständiger Zyklus ohne Lücken
Entwurf des Datenbankschemas, REST-API mit Dokumentation,
Authentifizierung über Spring Security und OAuth2, Integrationen
mit Zahlungssystemen (WayForPay, Stripe), Telegram Bot API,
externen KI-Anbietern. Deployment über Docker auf Railway, VPS
oder der eigenen Infrastruktur des Kunden. Der Kunde erhält ein fertiges Produkt,
keine Sammlung von Komponenten, die noch zusammengesetzt werden müssen.
KI-Integrationen als Teil des Produkts
Seit 2024 integriere ich große Sprachmodelle in kommerzielle Produkte:
Suche in Dokumenten mit pgvector, Streaming von Antworten über SSE,
langfristiger Speicher für Personalisierung, multimodale Strategien
über OpenRouter, MCP-Server für die Anbindung an Claude und ChatGPT.
Ich achte besonders darauf, dass die KI ehrlich „nicht gefunden“ sagt und keine Antwort erfindet –
und darauf, dass die Daten des Kunden nicht dorthin gelangen, wo sie nicht hingehören.
KI ist kein Buzzword im Lebenslauf, sondern konkrete technische Lösungen, die bereits in der Produktion funktionieren.
Performance von Anfang an eingeplant
Caching auf Caffeine- oder Redis-Ebene, Optimierung von SQL-Abfragen
und Indizes in PostgreSQL, asynchrone Verarbeitung von rechenintensiven Operationen,
HikariCP-Tuning für kontrollierte Datenbanklast –
all das wird von Anfang an in die Architektur integriert. Nicht als „Optimierung“
nachdem das System unter Last zusammengebrochen ist, sondern als Teil
des Designs vom ersten Tag an.
Wartbarer Code
Der Code, den ich liefere, ist auch nach einem Jahr ohne den Autor daneben lesbar.
Klare Paketstruktur, Trennung in Schichten (Controller → Service → Repository),
separate DTOs und Mapper, Konstanten anstelle von magischen Zeichenketten,
explizites Logging für das Debugging in der Produktion. Testabdeckung
für kritische Pfade – denn die Wartung des Projekts nach dem Start
wird Ihnen oder einem anderen Entwickler obliegen.
Portfolio der Arbeiten –
webscraft.org/portfolio
⸻
📝 Technisches Blog
Gemeinsam mit dem Team führen wir einen technischen Blog
webscraft.org/blog –
wir schreiben über reale Anwendungsfälle aus der Entwicklung, neue Tools und Ansätze,
die wir in der Praxis verwenden. Keine Wiedergabe von Dokumentationen,
sondern konkrete Lösungen aus Live-Projekten. Hauptthemen – RAG, Vektorsuche,
MCP, Spring AI und lokale Modelle.
Wenn Sie eine technische Frage haben, die Architektur eines
Projekts besprechen möchten oder einfach nicht wissen, wo Sie anfangen sollen –
schreiben Sie mir direkt,
ich antworte persönlich.
⸻
🎯 Entwicklungsansatz
In acht Jahren habe ich in verschiedenen Projekten immer wieder dieselben Probleme gesehen.
Nicht technische – organisatorische. Die Entwicklung beginnt ohne klare Architektur,
der erste Release erscheint später als geplant, und dann geht die Hälfte der Zeit
für Refactoring statt für neue Features drauf. Mein Ansatz ist darauf aufgebaut,
dies zu verhindern.
Problem: "Erst machen, dann sehen wir weiter"
Die häufigste Situation: Ein Projekt startet ohne Datenbankdesign
und Architektur. Nach drei Monaten stellt sich heraus, dass das Schema den
realen Daten nicht standhält und das Hinzufügen eines neuen Features das Umschreiben
der halben Codebasis bedeutet. Ich beginne immer mit der Datenmodellierung und der
Definition der Systemgrenzen – auch wenn der Kunde "nur schnell starten" will.
Problem: Microservices um der Microservices willen
Ein Zweierteam baut ein verteiltes System aus fünf Services,
Kafka und separaten Datenbanken – weil "das so richtig ist". Das Ergebnis:
90% der Zeit gehen für Infrastruktur statt für das Produkt drauf. Für ein Startup
im Frühstadium ist ein gut geschriebener Monolith auf Spring Boot
oft die bessere Lösung. Microservices entstehen, wenn es einen echten Bedarf gibt,
nicht vom ersten Tag an.
Problem: KI um der KI willen
"Fügen wir einen Chatbot hinzu" – ohne zu verstehen, welche Fragen er beantworten soll
und auf Basis welcher Daten. Das Ergebnis: Ein Bot, der selbstbewusst Antworten erfindet
oder allgemeine Phrasen wiederholt. Ich beginne mit der Frage, welches Geschäftsproblem
die KI lösen soll, auf welchen Daten sie arbeitet und wie man überprüft, ob sie
korrekt antwortet. Manchmal ist die ehrliche Antwort, dass KI hier nicht benötigt wird,
sondern eine normale Suche oder Filterung ausreicht.
Problem: Performance als nachträglicher Gedanke
"Erst machen wir, dass es funktioniert, dann optimieren wir" –
ein Klassiker, der teuer zu stehen kommt. N+1-Abfragen in Hibernate, fehlende
Indizes, fehlendes Caching – all das lässt sich leicht in der Architekturphase lösen
und ist im produktiven Betrieb unter Last nur schwer zu beheben. Redis, richtige Indizes,
asynchrone Verarbeitung von schweren Operationen – das lege ich von Anfang an fest.
Problem: Code, den nur der Autor versteht
Nach einem Jahr arbeitet der Entwickler, der das System geschrieben hat, nicht mehr im Unternehmen.
Ein neuer Entwickler verbringt Wochen damit, zu verstehen, was passiert.
Lesbarer Code, verständliche Struktur, Dokumentation kritischer
Entscheidungen – das ist kein Perfektionismus, das ist die Kosten der Wartung.
Eine gute Architektur ist nicht die, die auf einem Diagramm schön aussieht,
sondern die, die leicht zu ändern ist, wenn sich die Geschäftsanforderungen ändern.
⸻
📖 Glossar
Kurz – für diejenigen, die die Begriffe auf der Seite verstehen wollen.
-
LLM – Large Language Model: ChatGPT, Claude, Gemini und andere.
Das "Gehirn", das Fragen versteht und Antworten formuliert.
-
RAG – Retrieval-Augmented Generation: Eine Methode, um KI dazu zu bringen,
basierend auf Ihren Dokumenten statt auf allgemeinem Wissen zu antworten: Das System findet zuerst die relevanten Fragmente,
dann antwortet das Modell darauf basierend und verweist auf die Quelle.
-
Vektorsuche (Embeddings) – Suche nach Bedeutung, nicht nach exakten Wörtern:
"Abonnement kündigen" findet ein Dokument über "Tarifbeendigung".
Details – im Artikel Embeddings in einfachen Worten.
-
MCP – Ein Standard, über den KI-Assistenten (Claude, ChatGPT und andere)
sich mit externen Diensten verbinden: Ihrer Website, Datenbank, CRM.
Wie das am Beispiel eines Blogs funktioniert – im Artikel über MCP-Server.
-
pgvector – Eine Erweiterung für PostgreSQL, die Vektorsuche in einer normalen Datenbank ermöglicht,
ohne ein separates, teures System.
-
Spring AI – Eine Bibliothek zur Integration von KI in Java-Anwendungen mit Spring.
⸻
❓ FAQ
Was ist Ihre Hauptspezialisierung?
KI-Lösungen in Java und Spring: Suche in Dokumenten (RAG), Vektorsuche,
Integrationen mit LLMs und MCP-Servern. Plus vollständiger Backend-Entwicklungszyklus auf Spring Boot:
Autorisierung, Zahlungen (Stripe, WayForPay), PWA und Web Push.
Kann man einem bestehenden Java-Produkt KI hinzufügen?
Ja, und das ist meine Hauptspezialisierung. KI-Funktionen werden in bestehende
Spring-Anwendungen integriert, ohne einen separaten Python-Service und ohne die Systemneuschreibung.
Kann man meine Website mit ChatGPT oder Claude verbinden?
Ja, über einen MCP-Server: KI-Assistenten können nach Ihren Produkten, Artikeln
oder Daten suchen und auf Ihre Website verlinken. Ich habe das für meinen eigenen Blog gemacht –
hier sehen Sie, wie es funktioniert.
Ist es sicher, Unternehmensdokumente an KI zu übergeben?
Das hängt von der Architektur ab. Für vertrauliche Daten erstelle ich isolierte Installationen
für jeden Kunden und bei Bedarf die Arbeit mit lokalen Modellen,
bei denen die Daten Ihre Infrastruktur überhaupt nicht verlassen.
Nehmen Sie kommerzielle Projekte an?
Ja. Ich betrachte KI-Integrationen, Backend-Entwicklung, technische Beratung
und den vollständigen Entwicklungszyklus von Webprodukten. Kontaktieren Sie mich zur Besprechung der Details.
Was kostet die Entwicklung?
Abhängig von der Komplexität. Eine einfache REST API – ab $200,
ein vollwertiges Produkt mit Autorisierung, Zahlungen und PWA – ab $1000.
Ich gebe immer eine detaillierte Schätzung nach Analyse der Anforderungen.
Wo kann man den Code sehen?
github.com/VadimKharovyuk
⸻
Wenn Sie ein Projekt oder Fragen haben – schreiben Sie: