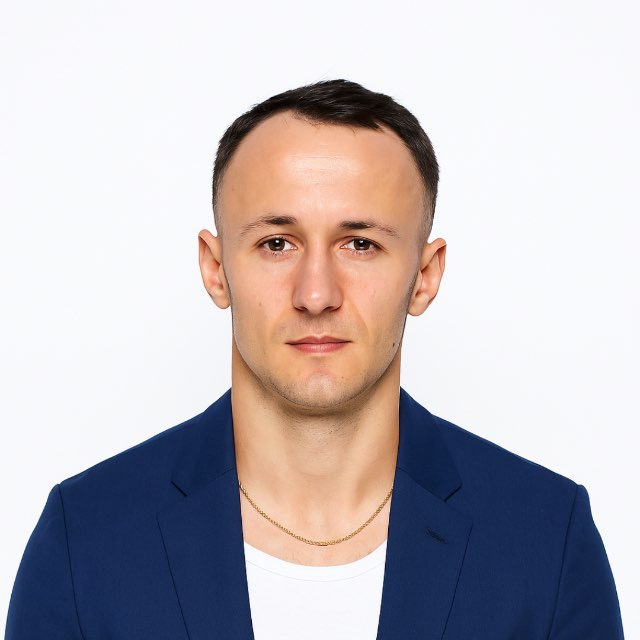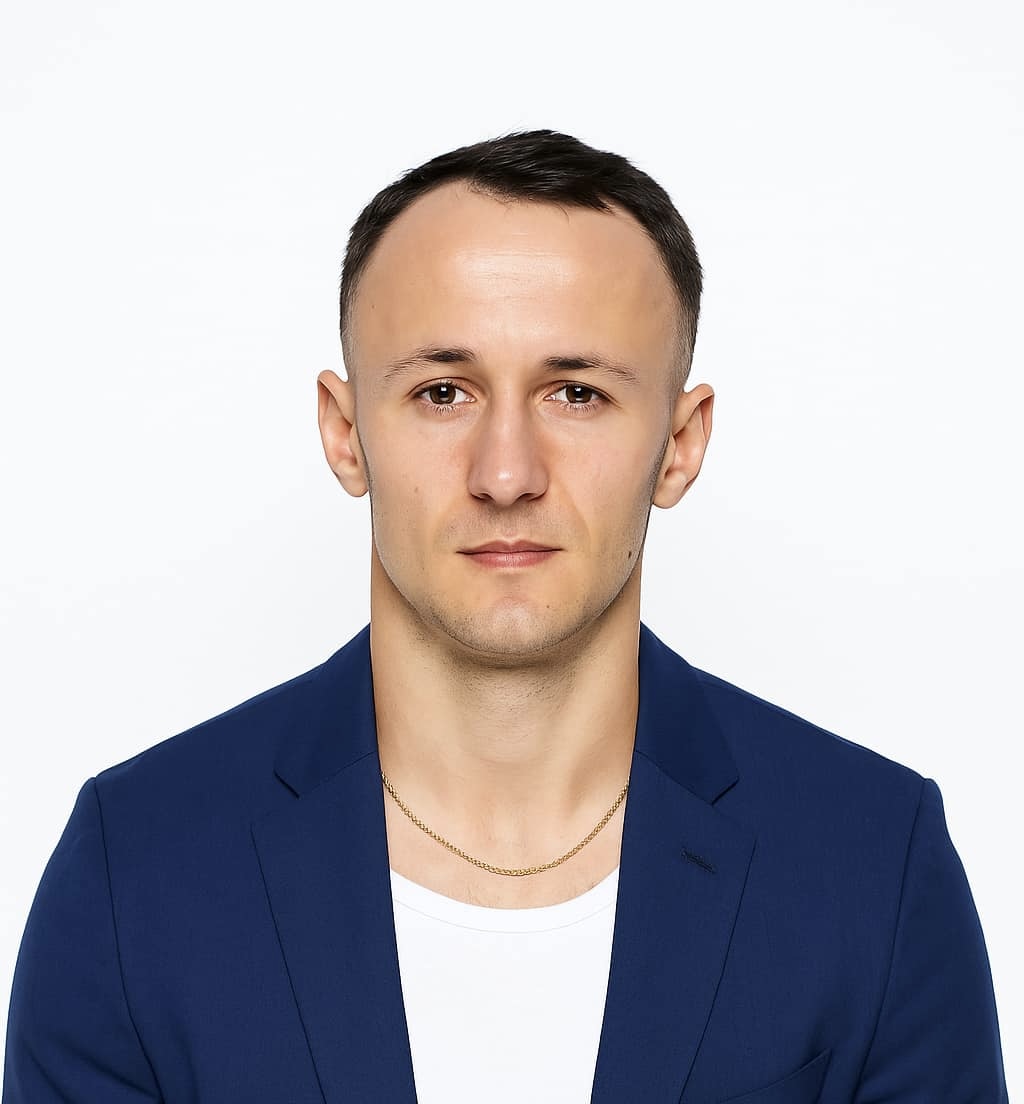
Мене звати Вадим Харовюк. Я Java Backend розробник з восьмирічним досвідом
у Spring екосистемі. Сьогодні моя основна спеціалізація — AI-рішення для бізнесу
на Java: пошук по документах, AI-асистенти, інтеграції з мовними моделями
та підключення сервісів до ChatGPT і Claude.
Паралельно з комерційними проєктами веду технічний блог
webscraft.org/blog —
пишу про реальні кейси з власного досвіду, а не переказ документації.
📚 Зміст
⸻
🎯 Про мене
32 роки, працюю віддалено з клієнтами з різних країн. В IT прийшов усвідомлено — після університету
зрозумів що хочу будувати продукти, а не просто писати код за технічним
завданням. Перші роки — монолітні Spring Boot додатки, бази даних,
REST API. З часом — мікросервіси, черги повідомлень, складні інтеграції
з зовнішніми сервісами. А з 2024 року — глибоке занурення в AI-інтеграції
та розробку власних SaaS-продуктів на базі великих мовних моделей.
Сьогодні я працюю переважно з AI-стеком: векторний пошук, RAG,
інтеграції з LLM і MCP-сервери — усе на Java та Spring. Це рідкісне поєднання:
більшість AI-рішень пишуть на Python, а я допомагаю компаніям, у яких backend
уже на Java, додати AI без окремого сервісу на іншій мові.
При цьому я відповідаю за повний цикл: від проєктування архітектури
до деплою на продакшн з моніторингом і підтримкою. Думаю не лише про код,
а й про масштабованість, вартість інфраструктури, досвід кінцевого
користувача та бізнес-логіку продукту в цілому.
Найкращий спосіб розібратися в технології — побудувати на ній
щось реальне і довести до продакшну. Теорія без практики —
це просто красиві слова в резюме.
💡 Чим можу допомогти вашому бізнесу
Без технічного жаргону — що ви отримуєте. Терміни дрібним шрифтом
для тих, хто хоче розібратися; пояснення — у словнику нижче.
🔍 AI-пошук по ваших документах
Співробітники ставлять питання звичайною мовою — «які умови повернення
в договорі з постачальником?» — і за секунди отримують відповідь
із посиланням на конкретний документ. Без годин гортання папок
і пошуку «а де той файл».
Технічно: RAG, векторний пошук, pgvector
💬 AI-асистент на вашому сайті
Відвідувачі отримують відповіді на питання про ваші послуги чи товари
цілодобово — на основі вашої інформації. Менше однакових питань
у підтримку, більше заявок.
Технічно: інтеграція з LLM, RAG
🤖 Ваш сайт чи сервіс — доступний для ChatGPT і Claude
Клієнти, які користуються AI-асистентами, можуть знаходити ваші товари,
статті чи дані прямо в чаті — і бачити посилання на вас. Новий канал,
у якому зараз мало конкурентів. Як це працює на практиці — показав на
прикладі власного блогу.
Технічно: MCP-сервер
⚙️ AI у вашому існуючому продукті
Автоматичні підсумки, класифікація заявок, генерація текстів, аналітика —
вбудовую в систему, яка вже працює, без переписування з нуля.
Дані залишаються під вашим контролем.
Технічно: інтеграції з LLM (OpenAI, Claude, локальні моделі через Ollama)
🧩 Backend для веб-продуктів
Надійна основа сервісу: авторизація, платежі, кабінети користувачів,
мобільна версія. Від простого API до повного продукту.
Технічно: Java, Spring Boot, PostgreSQL, PWA
⸻
📂 Власний продукт: AskYourDocs
AskYourDocs — B2B-платформа
для пошуку по корпоративних документах. Компанія завантажує свої договори,
інструкції та регламенти, а співробітники ставлять питання звичайною мовою
й отримують відповідь із посиланням на джерело.
Ключове рішення — окрема ізольована інсталяція для кожного клієнта.
Документи однієї компанії фізично не перетинаються з даними іншої,
що важливо для конфіденційних даних і вимог GDPR.
- Пошук за змістом, а не за словами — знаходить відповідь, навіть якщо в документі вона сформульована інакше
- Відповіді з джерелами — користувач бачить, з якого документа взято інформацію, і може перевірити
- Ізоляція даних — single-tenant інсталяція під кожного клієнта
Стек — Java, Spring Boot, Spring AI, PostgreSQL + pgvector.
🌐 AI-інфраструктура webscraft.org
Мій блог — це не лише статті, а й робочий полігон для AI-рішень,
які потім застосовую в клієнтських проєктах. Усе працює в продакшні.
-
AI-чат по статтях блогу — відповідає на питання читачів
на основі статей і дає посилання на джерела. RAG на pgvector і Spring AI.
-
Публічний MCP-сервер — Claude, ChatGPT-сумісні клієнти та OpenCode
можуть шукати по статтях блогу прямо в чаті. Семантичний пошук, rate limiting
на Redis, захист за Cloudflare. Таких реалізацій на Java поки одиниці.
Детально — у статті про MCP-сервер для сайту.
-
SEO-агент — щодня збирає дані з Google Search Console та GA4,
аналізує їх через LLM з інструментами (Spring AI tools) і надсилає
звіти з рекомендаціями на пошту.
🤖 Новий проєкт: AI платформа для спілкування з персонажами
Повноцінна SaaS-платформа де користувачі спілкуються з AI-персонажами —
психологами, менторами, компаньйонами, коміками, романтичними персонажами
та іншими. Кожен персонаж має власний характер, стиль спілкування
і довгострокову пам'ять про користувача. Скоро в продакшні.
Проєкт написаний повністю самостійно — від архітектури до деплою.
Не демо і не pet project, а повноцінний продукт з біллінгом,
AI-пам'яттю, семантичним пошуком і реальною інфраструктурою
на Railway.
Що всередині:
-
Spring AI 2.0 + LLM інтеграція — OpenRouter як
єдиний шлюз до різних моделей: DeepSeek V4 Flash як основна модель,
окремі моделі для романтичних та провокативних персонажів
(sao10k/l3.3-euryale-70b), Gemini для підтримки. Перемикання
моделей через конфіг без зміни коду.
-
AI-пам'ять та RAG — система довгострокової пам'яті
на базі pgvector: extractAllFacts витягує 11 полів з діалогу
за один LLM-виклик, гібридний пошук через Reciprocal Rank Fusion
(векторний пошук + PostgreSQL FTS), семантичні та епізодичні
summary з Caffeine-кешем.
-
Стрімінг через SSE — відповіді персонажа стримляться
токен за токеном через Server-Sent Events, кнопка Stop для переривання,
черга токенів з анімацією друку.
-
Біллінг — WayForPay prepaid інтеграція (єдина
платіжна система доступна в Україні без ФОП), токенна модель оплати,
підписки FREE/BASIC/PRO з різними лімітами, webhook з підтримкою
JSON та form-urlencoded.
-
Сцени та рольові ігри — система сцен з AI-генерацією
сюжету: вибір тегів → LLM генерує драфт → збереження.
Романтичні побачення, детективні розслідування, зустрічі випускників.
-
Telegram інтеграція — спілкування з персонажами
прямо в Telegram, прив'язка акаунту, окремий бот для локальної
розробки щоб уникнути конфліктів з продакшн-ботом.
-
Модерація та безпека — KeywordCrisisDetectionService,
реакції персонажа на повідомлення, вікова верифікація для
провокативного контенту.
-
SEO-оптимізація — окремі SEO-контролери для каталогу
та сторінок персонажів, slug-маршрутизація, JSON-LD structured data,
OG-теги, sitemap.
-
Інфраструктура — Railway (Spring Boot + pgvector PostgreSQL),
Docker з G1GC тюнінгом, Cloudinary для зображень, ngrok для
локальної розробки webhook'ів.
Весь стек — Java 21, Spring Boot 3, Spring AI 2.0, PostgreSQL + pgvector,
Thymeleaf + Bootstrap 5, OpenRouter, WayForPay, Cloudinary, Telegram Bot API —
спроєктований, написаний і підтримується однією людиною.
🚀 Один з проєктів: Kazki AI
Kazki AI — сервіс персоналізованих аудіоказок для дітей, де дитина є головним
героєм історії. Батьки вводять ім'я дитини, її інтереси та улюблених
персонажів — система генерує унікальну казку і озвучує її за допомогою
AI-голосу через ElevenLabs.
Проєкт написаний повністю самостійно — від архітектури до деплою.
Не pet project для резюме, а живий продакшн-сервіс з платіжною
системою, підписками, push-сповіщеннями на iOS та Android
і реальними користувачами.
Що всередині:
-
AI-генерація контенту — OpenAI генерує текст казки
з урахуванням імені дитини та вподобань, ElevenLabs озвучує результат
натуральним голосом
-
Платіжна система — Stripe з моделлю підписок:
різні тарифні плани, управління доступом, webhook-обробка подій
-
PWA без App Store — встановлення на домашній екран,
офлайн-режим, push-сповіщення через Web Push API (VAPID)
на iOS 16.4+ та Android
-
Авторизація — Spring Security + OAuth2 (Google),
захист від CSRF, управління сесіями через Redis
-
SEO та продуктивність — серверний рендеринг
через Thymeleaf, кешування на рівні Redis, оптимізація зображень
через Cloudinary
-
База даних — PostgreSQL з продуманою схемою:
користувачі, казки, підписки, push-підписки, платіжні події
Весь стек — Spring Boot, PostgreSQL, Redis, ElevenLabs, Stripe,
Cloudinary, PWA — розгорнутий і підтримується в production
однією людиною.
👗 Комерційний проєкт: FashionI
FashionI — це інтернет-магазин одягу з вбудованою AI-системою, яку я розробив
для розуміння клієнтів природною мовою. Замість стандартних фільтрів і категорій —
покупець просто описує, що шукає: «чорне плаття на весілля, бюджет $80, розмір M».
Я реалізував систему, яка автоматично знаходить потрібні товари, підбирає
відповідний розмір з урахуванням особливостей кожного бренду, допомагає
з оформленням замовлення та поверненнями, а також пропонує персоналізовані
рекомендації на основі історії переглядів.
Що я вирішив для бізнесу:
-
Підвищення конверсії — я зробив так, щоб клієнти швидше
знаходили потрібний одяг без потреби перебирати десятки сторінок з фільтрами
-
Зниження повернень — я створив інтелектуальний підбір розміру,
який враховує параметри тіла та специфіку крою кожного бренду
-
Автоматизацію підтримки — я налаштував AI-агента, який самостійно
відповідає на питання про замовлення, доставку та повернення
-
Персоналізацію без складнощів — я реалізував рекомендації, які
формуються автоматично на основі поведінки користувача
-
Економію на розробці — я створив єдину систему, яка замінює
окремі модулі для пошуку, підтримки, рекомендацій та підбору розмірів
Як це працює для клієнта:
- Клієнт пише запит природною мовою через чат на сайті
- AI розуміє, що саме потрібно: категорію, колір, розмір, бюджет
- Система показує саме ті товари, які шукає покупець
- За потреби допомагає з вибором розміру та оформлює замовлення
Я повністю самостійно спроєктував архітектуру мульти-агентної системи,
налаштував взаємодію між агентами, реалізував семантичний пошук для
точного розуміння запитів, і довів проєкт до повністю робочого стану.
⸻
🛠️ Технологічний стек
AI — основна спеціалізація
- Spring AI — інтеграція LLM у Spring-застосунки, tools / function calling
- RAG і векторний пошук — pgvector, embeddings, chunking, гібридний пошук (векторний + full-text)
- MCP — сервери для Claude, ChatGPT та інших AI-клієнтів (Streamable HTTP, STDIO)
- LLM-провайдери — OpenRouter, OpenAI API, Gemini, DeepSeek
- Локальні моделі — Ollama, LM Studio (для приватних даних без хмари)
- Стрімінг відповідей — Server-Sent Events
- ElevenLabs — генерація мовлення (Text-to-Speech)
Backend
- Java 21 — основна мова
- Spring Boot — продакшн-додатки будь-якої складності
- Spring Security — автентифікація, OAuth2, JWT, CSRF
- Spring Data JPA / Hibernate, JdbcClient — робота з реляційними БД
- Spring MVC / REST API — побудова HTTP-інтерфейсів
- Spring Cloud — мікросервісні патерни
Бази даних
- PostgreSQL + pgvector — основна БД, зокрема для векторного пошуку
- MySQL — альтернатива для певних типів проєктів
- Redis — кешування, сесії, rate limiting
Черги повідомлень та асинхронність
- Apache Kafka — потокова обробка даних, event-driven архітектура
- RabbitMQ — асинхронні черги для мікросервісів
Frontend та PWA
- Thymeleaf — серверний рендеринг з SEO
- JavaScript, HTML, CSS, Tailwind
- PWA (Service Worker, Web App Manifest)
- Web Push API / VAPID — push-сповіщення на iOS та Android
Платежі та інтеграції
- Stripe, WayForPay — підписки, webhook'и
- Telegram Bot API
- Google Search Console API, GA4 API
- Cloudinary — медіа-сховище та оптимізація зображень
DevOps та інфраструктура
- Docker — контейнеризація
- Railway / Render — деплой продакшн-додатків
- Cloudflare — CDN, захист, контроль AI-краулерів
- GitHub Actions — CI/CD пайплайни
💼 Що я роблю для клієнтів
За вісім років комерційної розробки виробив підхід який однаково
добре працює для стартапу на ранній стадії і для зрілого бізнесу
з legacy-системою. Від невеликих REST API до повноцінних SaaS-платформ
з AI-інтеграціями, біллінгом і тисячами користувачів.
Починаю з архітектури, а не з коду
Перед тим як писати перший рядок — розбираємо задачу бізнесу,
визначаємо де будуть вузькі місця, і обираємо стек під конкретний
кейс. Монолітний Spring Boot або мікросервіси — залежить від
масштабу і команди, а не від моди. Я не нав'язую оверінжиніринг
там де достатньо простого рішення, і не спрощую там де потрібна
серйозна архітектура.
Повний цикл без розривів
Проєктування схеми бази даних, REST API з документацією,
авторизація через Spring Security і OAuth2, інтеграції
з платіжними системами (WayForPay, Stripe), Telegram Bot API,
зовнішніми AI-провайдерами. Деплой через Docker на Railway, VPS
або власну інфраструктуру клієнта. Клієнт отримує готовий продукт,
а не набір компонентів які ще треба зібрати докупи.
AI-інтеграції як частина продукту
З 2024 року інтегрую великі мовні моделі в комерційні продукти:
пошук по документах на pgvector, стрімінг відповідей через SSE,
довгострокова пам'ять для персоналізації, мультимодельні стратегії
через OpenRouter, MCP-сервери для підключення до Claude і ChatGPT.
Окремо дбаю про те, щоб AI чесно казав «не знайдено», а не вигадував
відповідь, — і про те, щоб дані клієнта не виходили туди, куди не повинні.
AI — не buzzword в резюме, а конкретні технічні рішення, які вже працюють
у продакшні.
Продуктивність закладена з початку
Кешування на рівні Caffeine або Redis, оптимізація SQL-запитів
та індексів у PostgreSQL, асинхронна обробка важких операцій,
HikariCP тюнінг для контрольованого навантаження на БД —
все це закладається в архітектуру одразу. Не як "оптимізація"
після того як система впала під навантаженням, а як частина
проєктування з першого дня.
Підтримуваний код
Код який я здаю — читається через рік без автора поруч.
Чітка структура пакетів, розділення на шари (controller → service → repository),
окремі DTO і mapper'и, константи замість магічних рядків,
явне логування для дебагу в продакшні. Покриття тестами
для критичних шляхів — бо підтримувати проєкт після запуску
доведеться вам або іншому розробнику.
Портфоліо робіт —
webscraft.org/portfolio
⸻
📝 Технічний блог
Разом з командою ведемо технічний блог
webscraft.org/blog —
пишемо про реальні кейси з розробки, нові інструменти та підходи
які використовуємо на практиці. Не переказ документації,
а конкретні рішення з живих проєктів. Основні теми — RAG, векторний пошук,
MCP, Spring AI та локальні моделі.
Якщо у вас є технічне питання, хочете обговорити архітектуру
проєкту або просто не знаєте з чого почати —
пишіть напряму,
відповідаю особисто.
⸻
🎯 Підхід до розробки
За вісім років я бачив одні й ті самі проблеми в різних проєктах.
Не технічні — організаційні. Розробка починається без чіткої архітектури,
перший реліз виходить пізніше ніж планувалось, а потім половина часу
іде на рефакторинг замість нових фіч. Мій підхід побудований навколо
того щоб цього не допустити.
Проблема: "спочатку зробимо, потім розберемось"
Найпоширеніша ситуація — проєкт стартує без проєктування бази даних
і архітектури. Через три місяці з'ясовується що схема не витримує
реальних даних, а додати нову фічу означає переписати половину коду.
Я завжди починаю з моделювання даних і визначення меж системи —
навіть якщо клієнт хоче "просто швидко запустити".
Проблема: мікросервіси заради мікросервісів
Команда з двох людей будує розподілену систему з п'яти сервісів,
Kafka і окремими базами даних — бо "так правильно". В результаті
90% часу іде на інфраструктуру, а не на продукт. Для стартапу
на ранній стадії добре написаний моноліт на Spring Boot —
це часто правильніше рішення. Мікросервіси з'являються тоді
коли є реальна потреба, а не з першого дня.
Проблема: AI заради AI
«Давайте додамо чат-бота» — без розуміння, на які питання він має
відповідати і з яких даних. Результат — бот, який впевнено вигадує
відповіді або повторює загальні фрази. Я починаю з питання, яку задачу
бізнесу вирішує AI, на яких даних він працює і як перевірити, що він
відповідає правильно. Іноді чесна відповідь — що AI тут не потрібен,
а достатньо звичайного пошуку чи фільтра.
Проблема: продуктивність як afterthought
"Спочатку зробимо щоб працювало, потім оптимізуємо" —
класика яка коштує дорого. N+1 запити в Hibernate, відсутність
індексів, відсутність кешування — все це легко вирішується
на етапі архітектури і дуже важко виправляється в продакшні
під навантаженням. Redis, правильні індекси, асинхронна обробка
важких операцій — я закладаю це одразу.
Проблема: код який розуміє тільки автор
Через рік розробник який писав систему вже не працює в компанії.
Новий розробник витрачає тижні щоб розібратись що відбувається.
Читабельний код, зрозуміла структура, документація критичних
рішень — це не про перфекціонізм, це про вартість підтримки.
Хороша архітектура — це не та що виглядає красиво на діаграмі,
а та яку легко змінювати коли бізнес-вимоги змінились.
⸻
📖 Словник термінів
Коротко — для тих, хто хоче розібратися в термінах зі сторінки.
-
LLM — велика мовна модель: ChatGPT, Claude, Gemini та інші.
«Мозок», який розуміє питання і формулює відповідь.
-
RAG — спосіб змусити AI відповідати на основі ваших документів,
а не загальних знань: спочатку система знаходить потрібні фрагменти,
потім модель відповідає на їх основі й посилається на джерело.
-
Векторний пошук (embeddings) — пошук за змістом, а не за точними словами:
«скасувати підписку» знайде документ про «припинення тарифу».
Детально — у статті Embeddings простими словами.
-
MCP — стандарт, через який AI-асистенти (Claude, ChatGPT та інші)
підключаються до зовнішніх сервісів: вашого сайту, бази даних, CRM.
Як це працює на прикладі блогу — у статті про MCP-сервер.
-
pgvector — розширення для PostgreSQL, яке дозволяє робити
векторний пошук у звичайній базі даних, без окремої дорогої системи.
-
Spring AI — бібліотека для інтеграції AI у Java-застосунки на Spring.
⸻
❓ FAQ
Яка ваша основна спеціалізація?
AI-рішення на Java та Spring: пошук по документах (RAG), векторний пошук,
інтеграції з LLM і MCP-сервери. Плюс повний цикл Backend розробки на Spring Boot:
авторизація, платежі (Stripe, WayForPay), PWA та Web Push.
Чи можна додати AI до вже існуючого продукту на Java?
Так, і це моя основна спеціалізація. AI-функції вбудовуються в існуючий
Spring-застосунок без окремого сервісу на Python і без переписування системи.
Чи можна підключити мій сайт до ChatGPT або Claude?
Так, через MCP-сервер: AI-асистенти зможуть шукати по ваших товарах, статтях
чи даних і давати посилання на ваш сайт. Я зробив це для власного блогу —
ось як це працює.
Чи безпечно передавати AI корпоративні документи?
Залежить від архітектури. Для конфіденційних даних я роблю ізольовані інсталяції
під кожного клієнта, а за потреби — роботу з локальними моделями,
коли дані взагалі не залишають вашу інфраструктуру.
Чи берете комерційні проєкти?
Так. Розглядаю AI-інтеграції, Backend розробку, технічний консалтинг
та повний цикл розробки веб-продуктів. Зв'яжіться для обговорення деталей.
Скільки коштує розробка?
Залежить від складності. Простий REST API — від $200,
повноцінний продукт з авторизацією, платежами та PWA — від $1000.
Завжди даю детальну оцінку після аналізу вимог.
Де можна побачити код?
github.com/VadimKharovyuk
⸻
Якщо у вас є проєкт або питання — пишіть: