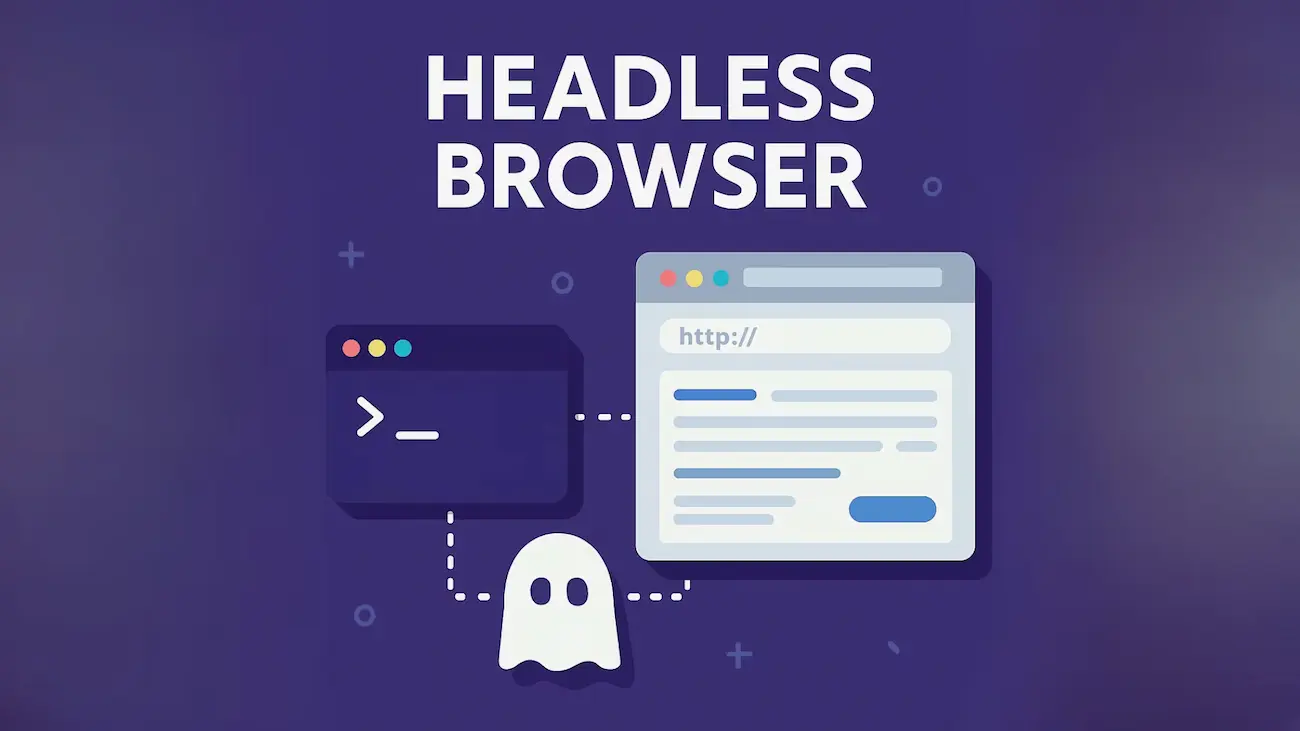
Headless Chrome — це браузер, який ви ніколи не бачите, але з яким стикаєтеся постійно. Він запускає автотести, генерує PDF і скриншоти, а пошукові системи використовують схожу технологію для рендерингу сторінок. У цій статті розбираю, як він працює всередині, чим відрізняються його режими, як ним керують і де його варто застосовувати. Про те, як боти на його основі потрапляють у звіти й як їх виявити: «Підозрілий трафік у GA4: як боти з headless-браузерами маскуються під людей і як їх виявити».
⚡ Коротко: що таке Headless Chrome
✅ Це справжній Chrome без видимого інтерфейсу.Документація Chrome описує його як запуск браузера в середовищі без нагляду та без UI. Запускається прапорцем --headless.
✅ Починаючи з Chrome 112 це той самий браузер. Режим створює вікна платформи, але не показує їх, і решта функцій працює без обмежень.
✅ Керують ним програмно: через Chrome DevTools Protocol, WebDriver BiDi або бібліотеки Puppeteer, Playwright, Selenium.
⚠️ Для сайту це повноцінний відвідувач, бо він виконує JavaScript. Тому легітимні тести й шкідливі боти виглядають для аналітики однаково.
🧠 Як це працює всередині: новий headless і chrome-headless-shell
Раніше headless був окремою реалізацією браузера, яка постачалася в тому самому бінарнику, але не використовувала код Chrome з каталогу //chrome. Сьогодні режими об'єднані: у Chrome 112 headless оновили так, щоб Chrome створював вікна платформи, але не показував їх. Стара реалізація, починаючи з версії 132.0.6793.0, доступна лише як окремий бінарник chrome-headless-shell, який можна завантажити зі сторінки Chrome for Testing.
Полегшена обгортка навколо модуля Chromium //content
Залежності
Повний набір, як у Chrome
Значно менше: не потребує X11/Wayland і D-Bus
Сильна сторона
Автентичність, надійність, більше функцій
Швидкість і легкість у деяких сценаріях
Для чого підходить
Точне наскрізне тестування, тестування розширень
Автоматичні скриншоти, збір даних зі сторінок
Простіше кажучи, вибір залежить від компромісу між продуктивністю й «автентичністю» браузера. У Puppeteer це видно з параметра запуску: headless: true вмикає новий режим (так за замовчуванням), headless: 'shell' — chrome-headless-shell, а headless: false — звичайний режим із вікном. Обидва режими на рівні двигуна (Blink, V8) виконують ту саму веб-платформу, тому JavaScript, CSS і запити до мережі працюють так само, як у звичайному Chrome.
Обмеження, через які поведінка режимів і інтерфейс можуть відрізнятися від звичайного Chrome, я розбираю окремо: Обмеження Headless Chrome.
🔌 Як ним керують: DevTools Protocol і WebDriver BiDi
Без вікна браузером керують командами. Зазвичай це робиться через протокол. Коли Chrome запускають із прапорцем --remote-debugging-port=9222, вмикається Chrome DevTools Protocol: через нього інструменти надсилають браузеру команди, і саме так працюють відлагоджувачі в редакторах. Адреса http://localhost:9222 у іншому браузері показує список сторінок, які можна інспектувати. Порт налагодження дає повний контроль над браузером, тому відкривати його назовні не слід.
Chrome DevTools Protocol (CDP) — власний протокол Chromium. Повний довідник команд доступний у DevTools Protocol Viewer. Як зазначають у описі Selenium BiDi, CDP підтримують лише браузери на Chromium.
WebDriver BiDi — двонаправлений стандарт W3C, створений командою Selenium разом з вендорами браузерів. Він має стати стабільним міжбраузерним API: події йдуть від браузера до керуючого коду через WebSocket. Як пояснюють у документації Selenium, підтримка CDP там тимчасова, доки не буде реалізовано BiDi. У блозі Chrome за 2023 рік підтримку BiDi у Puppeteer називали експериментальною, тож перевіряйте актуальний стан у документації.
Схема: як скрипт керує Headless Chrome
🛠️ Puppeteer, Playwright, Selenium: чим відрізняються
Існуючі WebDriver-набори тестів і точний контроль над драйвером конкретного браузера
Для Java-розробника важливо, що і Playwright, і Selenium мають офіційні Java-клієнти. Не існує «найкращого» інструмента: Puppeteer простіший для швидких завдань у Chrome, Playwright зручніший, коли потрібні кілька двигунів, а Selenium вибирають тоді, коли вже є WebDriver-інфраструктура. Перш ніж фіксувати вибір у проєкті, перевірте поточні версії та підтримувані браузери в документації кожного інструмента.
🚀 Що можна робити з командного рядка
Для простих завдань скрипти не потрібні. За довідником прапорців Chrome, у headless-режимі та в chrome-headless-shell доступні такі команди (замість chrome підставте шлях до Chrome у вашій системі):
Серіалізований DOM
chrome --headless --dump-dom https://example.com/
Це не те саме, що вивантажити HTML через curl. Chrome спершу розбирає HTML у DOM, виконує скрипти, які можуть його змінити, а потім серіалізує DOM назад у рядок. Тож ви бачите сторінку після роботи JavaScript.
Зберігає сторінку як output.pdf; прапорець --no-pdf-header-footer прибирає колонтитули з датою й адресою.
Очікування
--timeout=5000 — максимальний час очікування (мс), після якого вміст знімається, навіть якщо сторінка ще завантажується.
--virtual-time-budget=42000 — «перемотує» час для коду на сторінці (setTimeout, setInterval): браузер виконує його якомога швидше, а сторінка вважає, що час справді минув.
🧪 Для чого його використовують легально
Автоматичні тести. Розробники Chrome прямо називають headless інструментом для автоматичного тестування та серверних середовищ, де інтерфейс не потрібен: можна прогнати тести на справжній сторінці, створити її PDF або перевірити, як браузер її відображає.
Генерація PDF і зображень: рахунки, звіти, прев'ю для соцмереж зі шаблонів HTML.
Моніторинг: регулярне відкриття ключових сторінок і перевірка, чи вони справді відображаються після виконання JavaScript.
SEO-аудит: порівняння сирого HTML і сторінки після рендерингу (див. наступний розділ).
Збір публічних даних, якщо дозволяють правила сайту (див. розділ про етику).
📈 Headless і SEO: як пошуковики рендерять JavaScript
Для SEO-фахівців headless-браузер важливий ще й тому, що схожу технологію використовує пошукова система. Google пояснює, що Google Search виконує JavaScript за допомогою актуальної версії Chromium. Googlebot бере URL із черги сканування, читає robots.txt і ставить сторінки в чергу на рендеринг. Коли дозволяють ресурси, headless Chromium відображає сторінку та виконує JavaScript. Якщо сторінка або її скрипти заблоковані в robots.txt, Google не буде виконувати цей JavaScript.
З цього випливають практичні висновки:
Не блокуйте у robots.txt файли JS і CSS, потрібні для відображення сторінки. Про те, що робить robots.txt і чого він не робить, я писав у статті «Robots.txt: повний гайд для SEO».
Стратегія рендерингу впливає на продуктивність і надійність. У матеріалі web.dev зазначено, що серверний рендеринг із гідратацією може покращити швидкість і досвід користувача, а сторінки варто регулярно тестувати, чи доступний їхній вміст для Googlebot.
Швидка локальна перевірка. Команда --dump-dom показує DOM після виконання скриптів. Це наближає вас до того, що побачить рендерер, але не замінює перевірку в Google Search Console.
🐳 Запуск у Docker і CI
На серверах і в CI-пайплайнах headless Chrome працює без графічного середовища. За FAQ документації Chrome, віртуальний дисплей на кшталт Xvfb не потрібен, бо вікна немає. Там само зазначено, що прапорець --no-sandbox не потрібен, якщо правильно налаштувати користувача в контейнері. Не вимикайте пісочницю («sandbox») без потреби: це знижує безпеку, особливо коли браузер відкриває чужі сторінки. (Сторінка FAQ давня, тому перевірте рекомендації для вашої версії Chrome.)
Щоб не тягнути повний браузер, можна завантажити легку версію з Chrome for Testing за допомогою утиліти Puppeteer:
З погляду сайту headless Chrome — це клієнт, який завантажує сторінку, виконує її скрипти і запускає все, що на ній є, зокрема й теги аналітики. Саме тому GA4 не відрізняє його від людини за замовчуванням: він відсікає лише відомих ботів зі списку. Як це виглядає у звітах, як підтвердити підозру в Cloudflare і що з цим робити, я детально розібрав у статті «Підозрілий трафік у GA4: як боти з headless-браузерами маскуються під людей і як їх виявити». Про відмінності бота від реального користувача за логами також можна прочитати тут: «Як відрізнити бота від реального користувача».
Практична деталь для власників сайтів: ваші власні автотести й моніторинг, які ходять на продакшн із тегом GA4, теж потрапляють у статистику. Виключайте їх (наприклад, через внутрішній трафік або трафік розробників), щоб не забруднювати дані.
⚖️ Етика й правила використання
robots.txt не є доступом за дозволом.Стандарт RFC 9309 прямо зазначає, що ці правила не є формою авторизації. Файл просить ботів поводитися чемно, але технічно нічого не забороняє. Докладніше: гайд із robots.txt.
Не навантажуйте чужі сайти. Обмежуйте частоту запитів, не запускайте паралельно сотні вкладок.
Читайте умови використання сайту і враховуйте закони вашої країни щодо збору даних. Це не юридична консультація, а нагадування перевірити правила до початку роботи.
Не використовуйте headless-браузери для накрутки трафіку, кліків чи переглядів реклами. Це порушує правила рекламних мереж і може призвести до блокування акаунта.
⚠️ Типові проблеми
Динамічний контент не встиг з'явитися. Знімок зроблено до завершення завантаження. У командному рядку допомагають --timeout і --virtual-time-budget, у бібліотеках — очікування конкретних елементів чи подій.
Різні результати в headless і зі вікном. Розбіжності можуть бути через розмір вікна, шрифти, налаштування й режим запуску. Тому ставте розмір вікна явно (--window-size) і відтворюйте проблему в тому самому режимі, де вона виникла.
Нестабільні тести. Типова причина — залежність від таймінгів. Замість «спати» певний час чекайте на явну умову.
Ресурси сервера. Кожен екземпляр браузера споживає пам'ять і процесор, тож закривайте браузер після завершення роботи й обмежуйте паралелізм.
Більше про межі можливостей режиму та відмінності від звичайного Chrome читайте в окремій статті: Обмеження Headless Chrome.
❓ Часті питання (FAQ)
Чим Headless Chrome відрізняється від звичайного Chrome?
Починаючи з Chrome 112 це той самий браузер: він створює, але не показує вікна, і всі інші функції доступні. Різниця насамперед у тому, що немає видимого інтерфейсу, а керування відбувається програмно. Деталі й відмінності в поведінці я збираюсь описати в статті «Обмеження Headless Chrome».
Чи потрібен Xvfb для headless Chrome?
Ні. За FAQ документації Chrome, вікна немає, тож віртуальний дисплей не потрібен.
Що обрати: Puppeteer чи Playwright?
Puppeteer зручний для швидкої автоматизації Chrome в Node. Playwright варто брати, коли потрібні Chromium, Firefox і WebKit в одному API або клієнти для Python, .NET чи Java.
Чи можна користуватися headless Chrome на Java?
Так: Playwright має офіційний Java-клієнт, а Selenium підтримує Java серед основних мов.
Чи є різниця між chrome-headless-shell і режимом --headless?
Так. --headless запускає справжній Chrome без вікна, а chrome-headless-shell — окремий полегшений бінарник зі старою реалізацією, у якого менше залежностей.
✅ Висновки
🔹 Headless Chrome — це справжній браузер без видимого інтерфейсу. Від Chrome 112 його режим об'єднаний зі звичайним Chrome.
🔹 Старий варіант тепер доступний як окремий chrome-headless-shell: легший, але менш «автентичний».
🔹 Керують ним через CDP, WebDriver BiDi або бібліотеки Puppeteer, Playwright і Selenium. Вибір залежить від мови, браузерів і наявної інфраструктури.
🔹 Для швидких завдань вистачає командного рядка: --dump-dom, --screenshot, --print-to-pdf.
🔹 Для SEO важливо розуміти, що Google теж рендерить сторінки через headless Chromium, тому не блокуйте ресурси, потрібні для відображення.
🔹 Для сайту headless-браузер виглядає як відвідувач, тому дивіться також статтю про боти в GA4 і використовуйте інструмент відповідально.
Важливо: версії Chrome, прапорці та підтримка браузерів у Puppeteer, Playwright і Selenium змінюються. Перед використанням перевіряйте актуальну документацію. Матеріал актуальний на жовтень 2026 року.