17 жовтня 2026 року DeepSeek разом з оновленням моделі V4.1-Flash-1017 відкрила для всіх власний пошук і завантаження сторінок через API. Для розробників AI-застосунків це зачіпає нудний, але важливий шар: у своїх проєктах я будував пошук як набір @Tool-методів, і значна частина роботи йшла не на модель, а на пошукову й обробну обв'язку навколо неї. Нижче — що саме з'явилося, скільки це коштує, які в API обмеження й чого він за вас не вирішить. Це розбір документації та офіційних заяв, мої власні заміри я опублікую окремо: заміри Search і Fetch API DeepSeek.
⚡ Коротко: що відкрила DeepSeek 17 жовтня
- ✅ Search API шукає сторінки й повертає структуровані результати, а Fetch API завантажує одну сторінку й повертає її текст у Markdown. Обидва — звичайні JSON API з тією самою авторизацією, що й решта API DeepSeek.
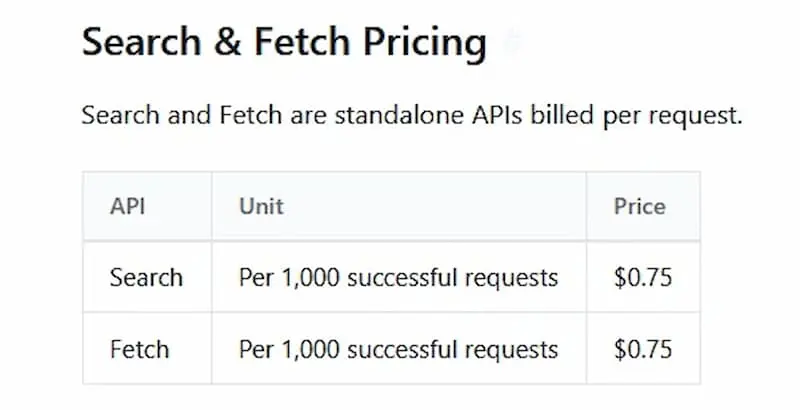
- 💸 Ціна: $0,75 за 1000 успішних запитів до кожного з двох API. Порожні відповіді, помилки й таймаути не тарифікуються.
- ⏱️ Ліміт: 5 запитів на секунду на акаунт окремо для Search і Fetch, а для Fetch є ще й ліміт на кожен домен.
- 🧠 Модель:
deepseek-flash тепер обслуговується версією V4.1-Flash-1017. Спосіб виклику й ціни моделі не змінилися.
- ⚠️ Що API не прибирає: ранжування під ваш продукт, кеш, дедуплікацію, контроль джерел і захист від prompt injection. Вони лишаються вашою справою.
📚 Зміст статті
Що в цій статті перевірено, а що ні. Усі факти про API (ендпоінти, поля, ціни, ліміти, помилки) взято з офіційної документації DeepSeek станом на 18 жовтня 2026 року. Бенчмарки моделі — заяви самої компанії. Власних вимірювань швидкості, якості результатів і вартості в реальному RAG у цій статті немає, вони будуть у окремій статті із замірами.
🧩 Що саме вийшло: Search, Fetch і V4.1-Flash-1017
Згідно з журналом змін DeepSeek, 17 жовтня компанія відкрила пошук, який працює на її власній пошуковій системі. DeepSeek описує її як AI-native пошук загального призначення з індексом із сотень мільярдів сторінок, підтримкою багатьох мов і результатами в реальному часі, а також заявляє, що система відсікає SEO-спам, GEO-маніпуляції та неякісний AI-контент. Це твердження самої компанії, незалежно воно не перевірялося.
Search API
Шукає сторінки за запитом і повертає структуровані результати.
Fetch API
Завантажує одну сторінку й повертає її вміст як Markdown. Відповідь залежить від доступності цільового сайту та його правил доступу.
V4.1-Flash-1017
Паралельно DeepSeek оновила модель V4.1 Flash до версії 1017. Згідно з документацією, спосіб виклику й ціни не змінилися: потрібна модель deepseek-flash. Компанія також заявляє, що знизила час виконання завдань і довжину відповідей, а зокрема оптимізувала модель для власного DeepSeek Harness, Tencent CodeBuddy, WorkBuddy та інших платформ. Для Harness потрібна версія 0.2.1-rc.1 або новіша.
| Бенчмарк (за даними DeepSeek) |
V4.1-Flash (10 вересня) |
V4.1-Flash-1017 |
| DeepSWE v1.1 | 74,2 | 77,0 |
| Terminal-Bench 4.0 | 31,2 | 42,3 |
| NL2Repo-Bench | 65,4 | 68,2 |
| ProgramBench | 20,3 | 29,1 |
| Automation-Bench | 54,8 | 60,5 (v1.0.6) |
| Agents' Last Exam | 31,8 | 35,4 |
Це заміри компанії, а не незалежне порівняння. Terminal-Bench 4.0 тестувався у фреймворку Claude Code, а DeepSWE — у Mini-SWE-V2, як зазначає DeepSeek. За повідомленнями преси ([Startup Fortune]), ваги нової версії також опубліковані на Hugging Face і ModelScope. Перевірте ліцензію на сторінці моделі.
🔌 Як це працює: запити, відповіді й оператори пошуку
Усі виклики йдуть на https://api.deepseek.com з заголовками Authorization: Bearer <ключ> і Content-Type: application/json.
| API |
Ендпоінт |
| Search | POST /v1/tools/search |
| Fetch | POST /v1/tools/fetch |
Запит до Search
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "DeepSeek V4 release",
    "count": 5,
    "need_content": true
  }'
| Поле |
Опис |
query | Обов'язкове; від 1 до 128 символів Unicode. Підтримує оператори, див. нижче |
count | Кількість результатів від 1 до 50, за замовчуванням 10 |
need_content | Чи повертати текст сторінки в полі content. За замовчуванням false, тоді поле порожнє |
ori_question | Оригінальне питання користувача (1–128 символів): допомагає краще зрозуміти запит |
localization | IP-адреса для локалізації результатів |
Оператори пошуку
| Оператор |
Приклад |
Що робить |
site: | DeepSeek site:github.com | Обмежує результати сайтом; кілька через OR |
-site: | DeepSeek -site:example.com | Виключає сайт |
- та -"..." | DeepSeek -"release notes" | Виключає слово або точну фразу |
"..." | DeepSeek "exact phrase" | Точний збіг фрази |
lang: | DeepSeek lang:zh,en | Обмежує мовою |
after: / before: | DeepSeek after:2025-01-01 | Обмежує датою публікації |
Що повертає Search
Відповідь містить масив results. Для RAG найкорисніші поля: summary (довге резюме на 600–800 символів, розраховане на модель), snippet (короткий опис для інтерфейсу), content (текст, якщо просили), date (дата публікації або null), rerank_score (оцінка 0–3, значення від 1,5 вважаються якісними) та authority (рівень авторитетності від 0 до 4, -1 якщо невідомо).
Fetch
curl https://api.deepseek.com/v1/tools/fetch \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -H "Content-Type: application/json" \
  -d '{ "url": "https://example.com/article" }'
У запиті одне поле url: HTTP або HTTPS-адреса довжиною до 8192 символів, з хостом і без імені користувача та пароля. У відповіді — title і content у Markdown.
💸 Ціна, ліміти й помилки
| Що |
Умови за документацією |
| Ціна |
$0,75 за 1000 успішних запитів, окремо для Search і Fetch. Кількість результатів (count) на ціну не впливає |
| Що вважається успішним запитом |
HTTP 200 з результатом: для Search непорожній results, для Fetch — отриманий вміст сторінки. Помилки, порожні результати й таймаути не тарифікуються |
| Ліміт швидкості |
5 запитів/с на акаунт для Search і окремо 5 запитів/с для Fetch, незалежно від того, який ключ API використано. Для Fetch додатково діє ліміт на домен. Перевищення дає HTTP 429 |
| Через Harness, Claude Code, Codex |
Серверні виклики Search і Fetch з цих інструментів зараз безкоштовні. Тарифікація почнеться о 00:00 за пекінським часом 1 листопада 2026 року |
Коди помилок
| HTTP |
Що означає |
Що робити |
| 400 | Некоректні заголовки або тіло запиту | Виправити запит |
| 401 | Ключ відсутній або недійсний | Перевірити ключ |
| 402 | Недостатньо коштів на балансі | Поповнити баланс |
| 403 | Fetch відхилено політикою безпеки | Не повторювати без змін |
| 404 | Fetch не отримав придатний вміст: адреса недоступна, заблокована політикою сайту, непідтримуваний тип вмісту або немає тексту для Markdown | Не повторювати без змін |
| 408, 5xx, 504 | Таймаут читання запиту, помилка сервера або вниз за потоком | Зачекати й повторити |
| 413 | Тіло запиту завелике | Скоротити запит |
| 429 | Перевищено ліміт швидкості | Зачекати й повторити |
Документація радить повторювати лише 408, 429 і 5xx, а 402 вирішувати поповненням рахунку. Інші 4xx без змін запиту повторювати не слід.
Чи варто будувати власний ретрай (повторні спроби) для 429 і 5xx — залежить від навантаження. [Напишу про реальні результати в окремій статті із замірами.]
🛠️ Як було раніше і що змінюється
Коли я будував пошуковий шар для AI-агентів, я ішов шляхом окремого @Tool для кожного джерела: Tavily для новин, Wikipedia для визначень, ArXiv для наукових статей. Цей підхід і його ціну для вибору інструмента я описував у статті «Search API для AI агентів: що обирають розробники і де помиляються». Поверх такого @Tool зазвичай накопичується обв'язка: пошук, завантаження HTML, очищення сторінки, обробка помилок і передача тексту в модель.
Тепер частину цього шару можна віддати DeepSeek:
- Пошук і ранжування. Search повертає результати вже з
rerank_score та authority.
- Завантаження і витяг тексту. Fetch віддає сторінку у вигляді Markdown, тож парсити HTML самому не потрібно.
- Один постачальник замість двох. Пошук, завантаження сторінки й сама модель обслуговуються одним акаунтом з однією схемою авторизації.
Дві ролі «їхньої інфраструктури»
- Варіант A: ваш
@Tool викликає Search і Fetch. Ви лишаєте за собою цикл викликів інструментів, кеш, обмеження й логування, а замість Tavily або власного парсера всередині інструмента стоїть API DeepSeek. Це типовий сценарій для Spring AI.
- Варіант B: агентні інструменти DeepSeek Harness, Claude Code, Codex. Документація зазначає, що серверні виклики інструментів з них уже використовують Search і Fetch.
Важливе уточнення: Search і Fetch у документації описано як окремі JSON API. Вбудованого автоматичного веб-пошуку в звичайному запиті до chat/completions я там не бачив, тому у власному застосунку цикл інструментів, як і раніше, пишете ви.
☕ Приклад у Spring Boot та Spring AI
Нижче скелет двох інструментів для Spring AI: пошук і завантаження сторінки. Він складений за документацією, але я його не компілював і не запускав, тож перед використанням перевірте під свою версію Spring AI.
@Component
public class DeepSeekWebTools {

    private final RestClient client;

    public DeepSeekWebTools(@Value("${deepseek.api-key}") String apiKey) {
        this.client = RestClient.builder()
                .baseUrl("https://api.deepseek.com")
                .defaultHeader("Authorization", "Bearer " + apiKey)
                .build();
    }

    @Tool(description = "Шукає актуальну інформацію в інтернеті. "
            + "Використовуй, коли питання стосується свіжих подій або фактів, яких немає в базі знань.")
    @SuppressWarnings("unchecked")
    public String webSearch(@ToolParam(description = "Пошуковий запит до 128 символів") String query) {
        Map<String, Object> body = Map.of("query", query, "count", 5, "need_content", false);

        Map<String, Object> response = client.post()
                .uri("/v1/tools/search")
                .contentType(MediaType.APPLICATION_JSON)
                .body(body)
                .retrieve()
                .body(new ParameterizedTypeReference<>() {});

        List<Map<String, Object>> results = (List<Map<String, Object>>) response.get("results");
        return results.stream()
                .map(r -> "- " + r.get("title") + " (" + r.get("url") + "): " + r.get("summary"))
                .collect(Collectors.joining("\n"));
    }

    @Tool(description = "Завантажує одну веб-сторінку за URL і повертає її текст у Markdown.")
    public String fetchPage(@ToolParam(description = "Повний http або https URL") String url) {
        Map<String, Object> response = client.post()
                .uri("/v1/tools/fetch")
                .contentType(MediaType.APPLICATION_JSON)
                .body(Map.of("url", url))
                .retrieve()
                .body(new ParameterizedTypeReference<>() {});

        String content = String.valueOf(response.get("content"));
        // Обмежуємо обсяг, щоб не заповнити контекст моделі однією сторінкою
        return content.length() > 8000 ? content.substring(0, 8000) : content;
    }
}
Підключення до моделі виглядає приблизно так (перевірте метод tools у вашій версії Spring AI):
String answer = chatClient.prompt()
        .user("Що нового з'явилося в DeepSeek API цього тижня?")
        .tools(deepSeekWebTools)
        .call()
        .content();
Модель deepseek-flash підключається через OpenAI-сумісний інтерфейс із базовою адресою https://api.deepseek.com, а також через Anthropic-сумісний інтерфейс (https://api.deepseek.com/anthropic), як зазначено в швидкому старті.
Про типові помилки tool calling у Spring AI (зокрема в 2.0.0-M3) і чому @Tool може «мовчати», я писав у статті «Яку модель Ollama обрати для агента з tool calling».
⚖️ Що API не вирішує
- Ранжування під ваш продукт. Search дає загальну оцінку релевантності, але правила «які джерела для мене надійні» залишаються вашими (наприклад, список дозволених доменів через оператор
site:).
- Дедуплікація й кеш. Ті самі запити й сторінки платні щоразу. Кеш на вашому боці знижує вартість.
- Контроль якості. Навіть якщо система відсікає спам, перевіряйте важливі факти в кількох джерелах.
- Закриті й заблоковані сторінки. Fetch не відкриє те, що закрите політикою сайту (404) або відхилене політикою безпеки (403).
- Ліміти. 5 запитів/с на акаунт для кожного API можуть стати вузьким місцем для агента, який паралельно запускає багато пошуків. Заплануйте чергу й повторні спроби.
- Юридичні питання. Умови використання сайтів, авторське право на витягнутий текст і персональні дані: це ваша відповідальність, а не API.
🛡️ Безпека: prompt injection, приватність і SSRF
Prompt injection через завантажені сторінки
Текст, який повертає Fetch, — це довільний вміст з інтернету, який ви передаєте моделі. Така сторінка може містити інструкції, спрямовані на агента. Це не теорія: у дослідженні «Indirect Prompt Injection in the Wild» проаналізували 1,2 млрд URL з 24,8 млн хостів і знайшли 15,3 тис. підтверджених випадків на 11,7 тис. сторінках. Про механіку такої атаки я детально писав у статті «Indirect Prompt Injection: атака в документі вашого AI».
Практичні заходи (це мої рекомендації, а не вимоги API):
- Розглядайте результат Search і Fetch як дані, а не як інструкції. У системному промпті прямо вкажіть, що вміст сторінок не може змінювати завдання.
- Не давайте агентові, який читає інтернет, чутливих прав (відправка листів, доступ до внутрішніх систем) без підтвердження людиною.
- Обмежуйте довжину вмісту, який передаєте в модель, і логуйте URL, з яких він узятий.
Приватність запитів
Пошукові запити й URL передаються стороннім серверам DeepSeek. Не вставляйте в запити персональні дані, секрети й конфіденційний текст, а перед використанням у комерційному продукті перевірте політику обробки даних. Параметр localization приймає IP-адресу, тому передавайте її лише за потреби.
Де тут SSRF
Fetch виконується на боці DeepSeek, тому класичний SSRF проти вашої внутрішньої мережі через цей API вас не стосується: сервіс не бачить ваших закритих адрес. SSRF повертається, якщо ви пишете власний fetcher або запускаєте headless-браузер на своїй інфраструктурі. Про це я докладно писав у статті про обмеження Headless Chrome: «Обмеження Headless Chrome», розділ про SSRF.
🔍 Порівняння підходів: власний конвеєр, Search + Fetch, гібрид
| Підхід |
Переваги |
Обмеження |
| Власний конвеєр (пошуковий API + власний парсер) |
Повний контроль над джерелами й обробкою |
Складніше розробляти й підтримувати; витрати на інфраструктуру |
| DeepSeek Search + Fetch |
Швидкий старт, готові ранжування й Markdown, один постачальник |
Залежність від зовнішнього API й його лімітів; приватність запитів |
| Гібрид (веб-пошук + власна база знань) |
Свіжі дані з інтернету разом із вашими документами |
Більше компонентів і логіки |
Коли вистачить Search + Fetch. MVP, прототипи, агенти для дослідження й запитів про свіжі події. Коли потрібен власний шар. Суворі вимоги до джерел, великі обсяги, чутливі дані або потреба в нестандартному ранжуванні.
Веб-пошук чи векторна база? Якщо відповідь лежить у ваших власних документах, потрібен векторний пошук з ембедингами. Як вибрати модель ембедингів, я розбирав у статті «Embedding-моделі для RAG у 2026». Якщо ж потрібні свіжі факти поза вашою базою, підключайте веб-пошук. Часто потрібні обидва.
Про ціну. У моєму огляді Search API станом на травень 2026 ціни коливалися від $1 до $10 за 1000 запитів залежно від провайдера (див. порівняння Tavily, Brave, Exa, SerpAPI, Serper). $0,75 за 1000 успішних запитів DeepSeek виглядає дешево, але порівнювати треба однакові сценарії: «пошук», «пошук з вмістом» і «пошук плюс завантаження сторінки» — це різна кількість платних викликів. Тому я не роблю висновку «дешевше» без власних вимірювань.
❓ Часті питання (FAQ)
Скільки коштують Search і Fetch API DeepSeek?
$0,75 за 1000 успішних запитів до кожного API. Помилки, порожні результати й таймаути не тарифікуються. Через DeepSeek Harness, Claude Code та Codex виклики зараз безкоштовні до 1 листопада 2026 року.
Який ліміт запитів?
5 запитів на секунду на акаунт для Search і окремо для Fetch. Fetch також має ліміт на домен. Перевищення дає HTTP 429.
Чи робить модель веб-пошук автоматично?
У документації Search і Fetch описані як окремі JSON API. Автоматичного веб-пошуку в звичайному запиті до chat/completions я там не бачив. У власному застосунку ви підключаєте їх як інструменти.
Як викликати оновлену модель?
Назва моделі deepseek-flash. Вона обслуговується версією V4.1-Flash-1017. Старі назви deepseek-v4-flash і deepseek-v4-flash-vision-exp ще приймаються, але ці моделі виведено з експлуатації, і запити обробляє нова версія за ціною Flash.
✅ Висновки
- 🔹 DeepSeek відкрила Search і Fetch API: пошук і завантаження сторінок у Markdown за $0,75 за 1000 успішних запитів, з лімітом 5 запитів/с кожен.
- 🔹 Це замінює шар пошуку й витягу тексту всередині вашого
@Tool, але не цикл інструментів, кеш, перевірку джерел і безпеку.
- 🔹 Головні ризики: prompt injection зі сторінок, приватність запитів і залежність від зовнішнього API.
- 🔹 Безкоштовний період для Harness, Claude Code і Codex закінчується 1 листопада, тож плануйте бюджет заздалегідь.
- 🔹 Бенчмарки V4.1-Flash-1017 — заяви DeepSeek; перевіряйте модель на власних завданнях.
- 🔹 Мої заміри швидкості, якості й вартості API будуть в окремій статті.
📎 Джерела
Важливо: ціни, ліміти та умови API змінюються. Перед використанням перевіряйте актуальну документацію DeepSeek. Матеріал актуальний на 18 жовтня 2026 року.