Los bots de IA escanean sitios web no para indexarlos, sino para entrenar modelos y generar respuestas sin necesidad de visitar la fuente. El tráfico automatizado ya supera al humano, por lo que los propietarios de sitios web necesitan control de acceso y, si es posible, pago por contenido.
⚡ En resumen
- ✅ Escala: según Cloudflare Radar, a principios de junio de 2026, los bots generan el 57,5% de las solicitudes HTML frente al 42,5% de los humanos. El principal impulsor es el tráfico de IA "agentic" (Tom's Hardware).
- ✅ Propósito: casi el 80% del rastreo de IA se destina al entrenamiento de modelos, no a la búsqueda. Las referencias son mínimas: en julio de 2025, Anthropic realizó ~38 000 rastreos por cada visita (Cloudflare).
- ✅ Control: a partir del 15 de septiembre de 2026, Cloudflare bloqueará por defecto a los rastreadores de "uso mixto" en páginas con publicidad (TechCrunch), y Pay Per Crawl se convierte en Pay Per Use (Technology.org).
🎯 Sección 1: Introducción al rastreo en la era de la IA
El rastreo es el escaneo automatizado de sitios web por parte de bots. Los bots de búsqueda (Googlebot, Bingbot) indexan páginas y devuelven visitantes. Los bots de IA (GPTBot, ClaudeBot, Meta-ExternalAgent) recopilan datos principalmente para entrenar LLMs, así como para RAG y respuestas en tiempo real. Según Cloudflare, en 2025, el entrenamiento representó ~80% del rastreo de IA, la búsqueda 18% y las acciones de usuario 2% (Cloudflare).
La consecuencia para un sitio web: el contenido aparece en las respuestas de IA, pero el visitante y los ingresos por publicidad no. A esto se suma la presión sobre la infraestructura: el tráfico automatizado ya representa el 57,5% de las solicitudes HTML (Tom's Hardware).
Las reglas del juego también están cambiando. A partir del 15 de septiembre de 2026, Cloudflare bloqueará los rastreadores de "uso mixto" (aquellos que combinan búsqueda, agentes y entrenamiento) en páginas con publicidad. Esto se aplica a nuevos clientes, nuevos sitios web y planes gratuitos (TechCrunch). El modelo de pago también está cambiando: en lugar de pagar por la carga de una página, el editor recibe dinero cuando el contenido se utiliza realmente en una respuesta de IA (Technology.org).
📚 Sección 2: Rastreo tradicional — Fundamentos
El rastreo tradicional es la base de la indexación de búsqueda desde los años 90. Un bot comienza con una URL semilla (direcciones conocidas, sitemap), sigue enlaces, extrae texto, metaetiquetas y estructura HTML, renderiza JavaScript y construye un índice. El bot toma las reglas de acceso de robots.txt y indexa la versión móvil de las páginas (mobile-first).
Ejemplos de user-agent:
- Googlebot:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
- Bingbot:
Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)
La diferencia clave con los bots de IA es el tráfico de retorno. En 2025, Google realizó entre 3,8 y 22,5 rastreos por cada visita a un sitio web (enero-julio), es decir, en unidades y decenas, no en miles (Cloudflare). El intercambio de "visibilidad en la búsqueda por acceso al contenido" funcionaba. En el rastreo de IA, este intercambio está casi roto.
🔄 Sección 3: Evolución hacia rastreadores de IA
Hasta 2023, los rastreadores indexaban principalmente páginas para la búsqueda. Tras el auge de la IA generativa, aparecieron bots para entrenar modelos, para buscar en asistentes de IA y para consultas de usuarios en tiempo real. Meta, OpenAI y Anthropic utilizan bots separados para esto, mientras que Google y Microsoft utilizan rastreadores unificados (Cloudflare). Son precisamente estos bots "mixtos", sin separación de propósitos, los que Cloudflare ahora bloquea por defecto.
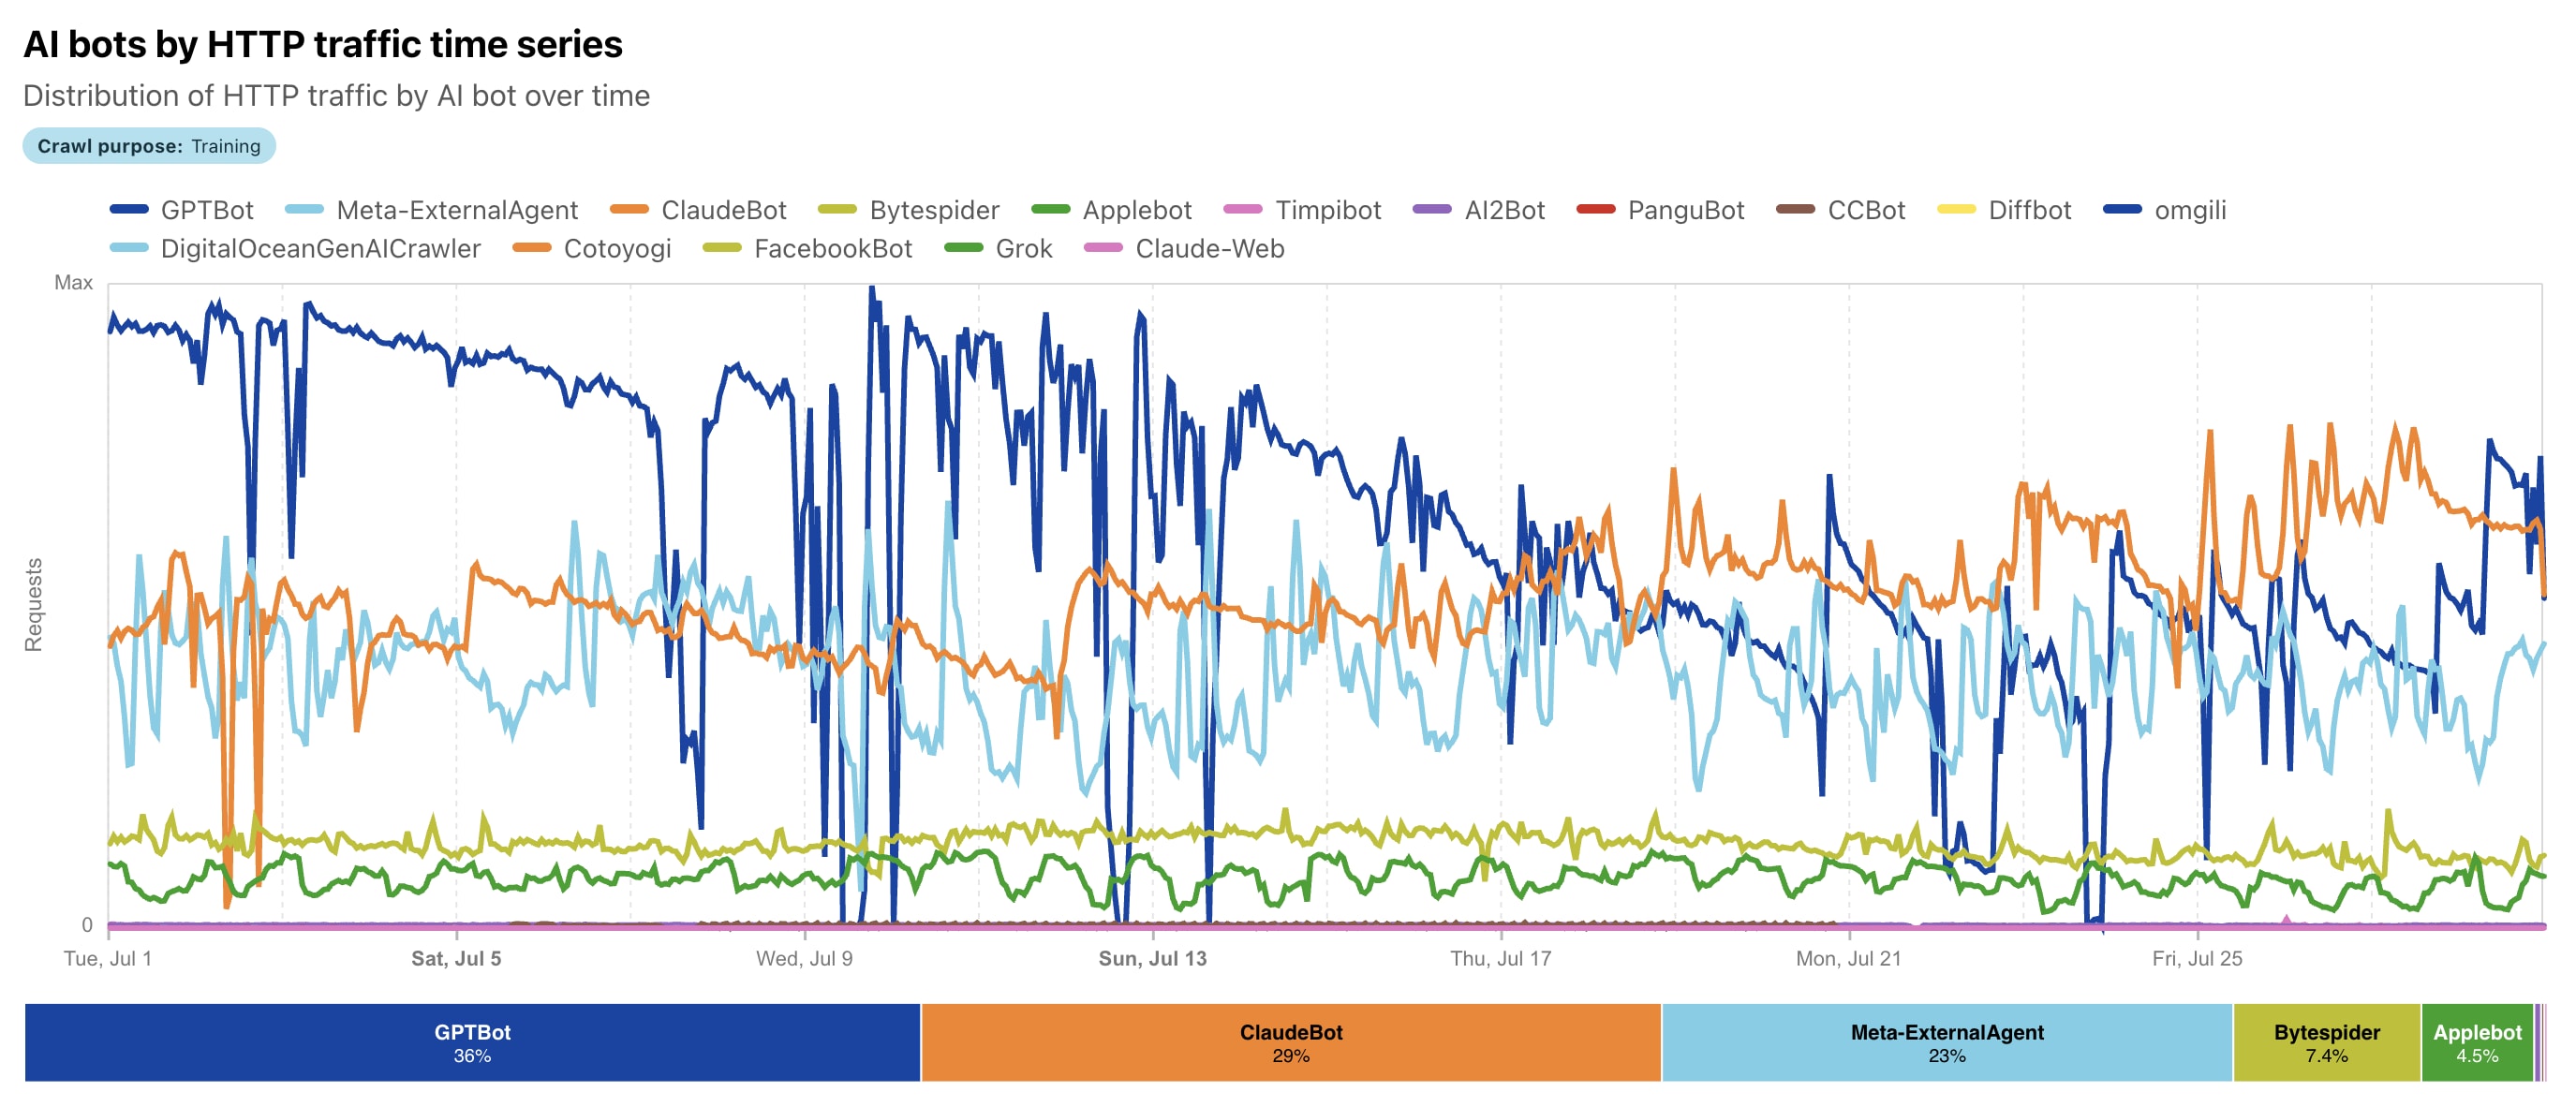
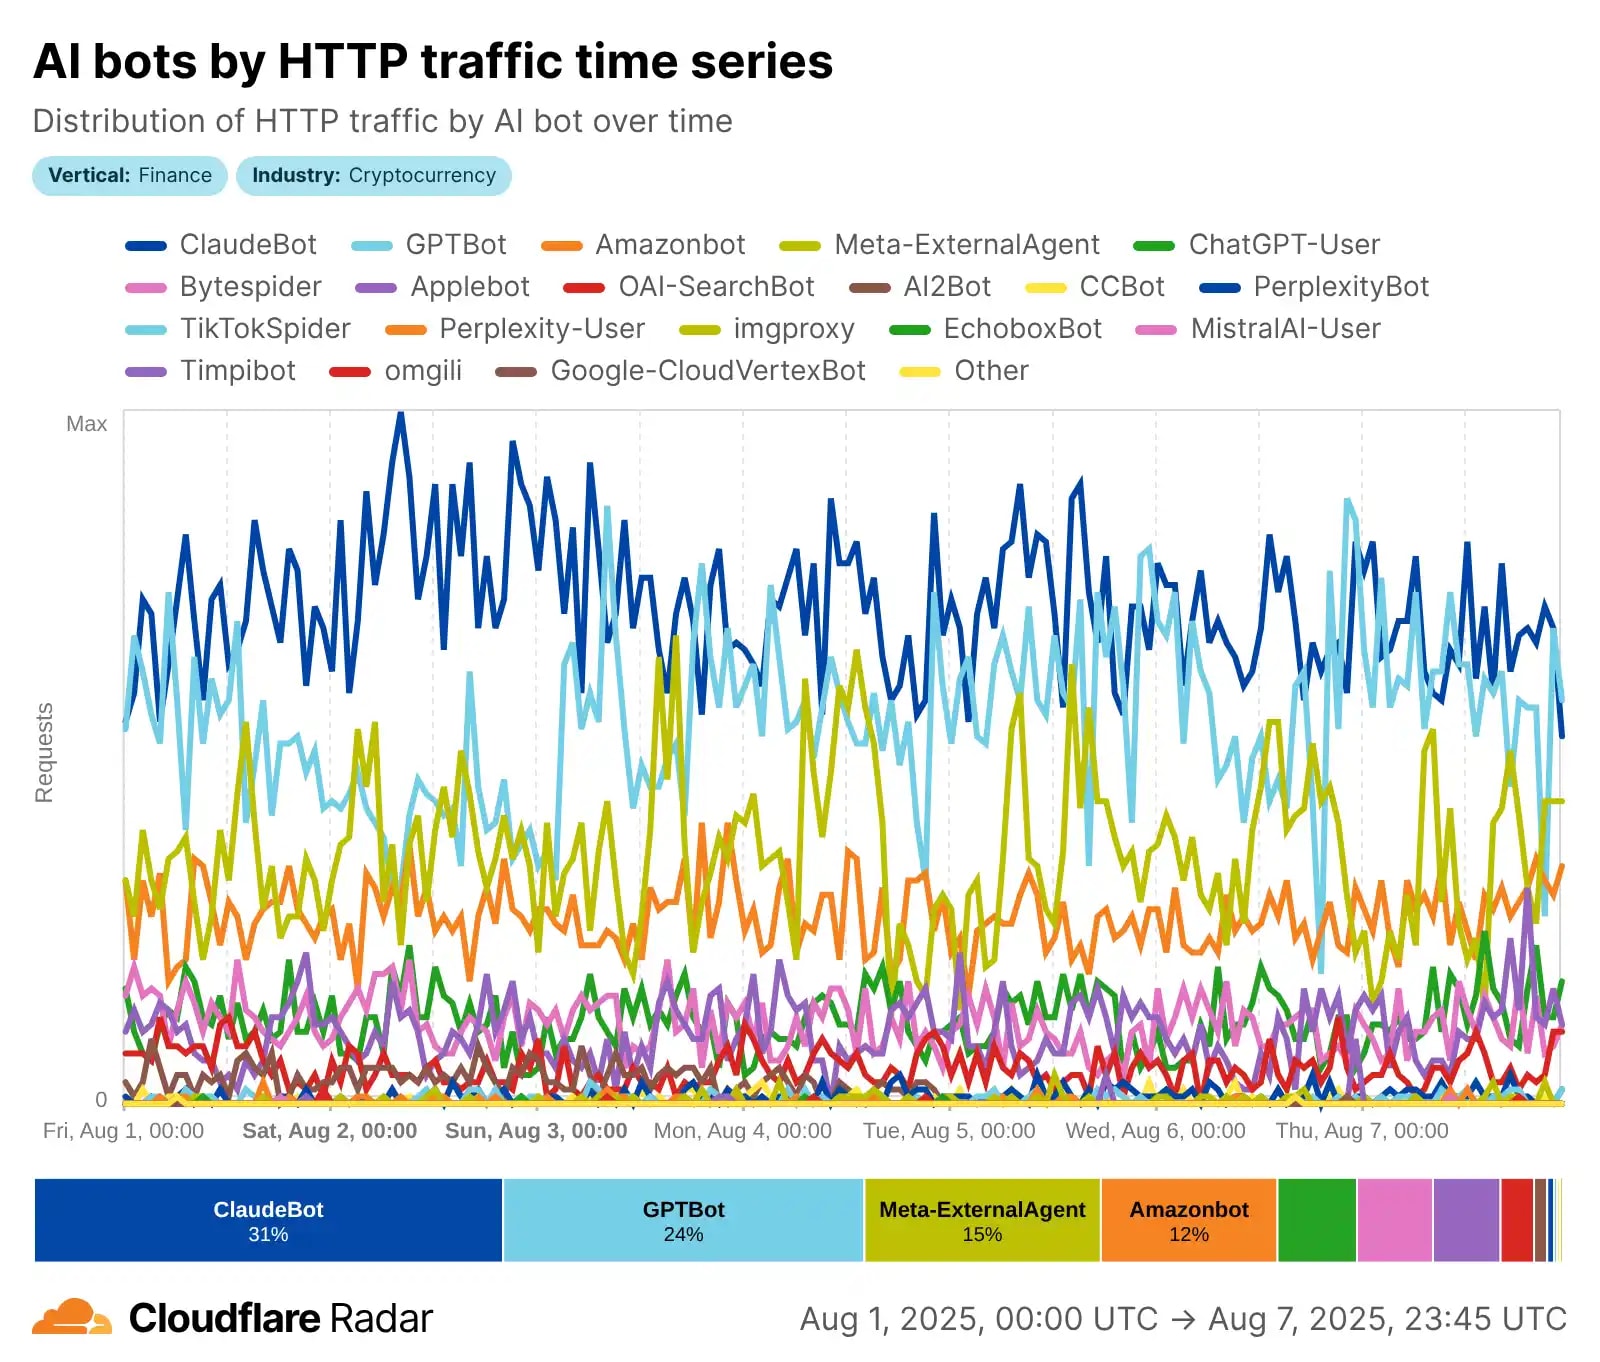
Porcentajes entre bots de IA, mayo de 2024 → mayo de 2025 (Cloudflare):
| Bot | 2024 | 2025 |
|---|
| GPTBot (OpenAI) | 5% | 30% |
| ClaudeBot (Anthropic) | 27% | 21% |
| Meta-ExternalAgent | — | 19% |
| Amazonbot | 21% | 11% |
| Bytespider (ByteDance) | 42% | 7,2% |
Las cuotas cambian mensualmente; consulta la instantánea actual en Cloudflare Radar AI Insights.
Número de rastreos por visita, julio de 2025 (Cloudflare):
| Plataforma | Rastreos por 1 visita |
|---|
| Anthropic | ~38 000 (en enero fueron ~287 000) |
| OpenAI | ~1 100 |
| Perplexity | ~195 |
| Microsoft | ~41 |
| Google | ~5 |
📖 Lee también
⚙️ Sección 4: Mecanismos de funcionamiento de los crawlers de IA
Técnicamente, un crawler de IA funciona como cualquier bot: solicitud, HTML, procesamiento. Lo que difiere es el objetivo y el comportamiento. Cloudflare clasifica los bots por propósito: entrenamiento de modelos, búsqueda, acciones de usuario (Cloudflare). En 2026, en la configuración de Cloudflare, estas serán las categorías Search, Agent y Training (Search Engine Journal).
- Descubrimiento. Las direcciones se obtienen de sitemaps, enlaces y rastreos previos. La selección de URLs es menos precisa que la de Google: en aproximadamente el 34% de las solicitudes, ChatGPT y Claude llegaban a 404, mientras que Googlebot lo hacía en el 8% (Vercel, datos de diciembre de 2024).
- Descarga. Solicitud HTTP con el user-agent del bot. Según un estudio de Vercel, ninguno de los grandes crawlers de IA (OpenAI, Anthropic, Meta, ByteDance, Perplexity) ejecutaba JavaScript. La excepción son Gemini (a través de la infraestructura de Googlebot) y Applebot. El contenido que aparece solo en el lado del cliente no lo ven.
- Tipo de bot. Aproximadamente el 80% del tráfico de bots de IA son crawlers que recopilan datos con antelación. El 20% restante son fetchers, que obtienen páginas en tiempo real a petición del usuario (Fastly, abril-julio de 2025).
- Escala. Los picos de fetchers alcanzaron los 39.000 requests por minuto (Fastly). Más del 50% del tráfico de crawling de bots de IA son descargas repetidas de páginas sin cambios (datos de Cloudflare de TechCrunch). A modo de comparación, en la red de Vercel, GPTBot realizó 569 millones de solicitudes en un mes, Claude 370 millones y Googlebot 4.500 millones (Vercel, diciembre de 2024).
📊 Sección 5: Estadísticas e impacto en el tráfico (2025–2026)
- Cuota de bots: 57,5% de las solicitudes HTML frente al 42,5% de las humanas (Cloudflare, junio de 2026).
- Crecimiento de crawlers (mayo de 2024 → mayo de 2025): GPTBot +305% de solicitudes, Googlebot +96% (Cloudflare).
- Quién rastrea: según Fastly (abril-julio de 2025, red Fastly), Meta representa el 52% del tráfico de crawling de IA, Google el 23% y OpenAI el 20%. En Cloudflare, la cuota de Meta-ExternalAgent es del 19% (mayo de 2025). Las metodologías difieren, por lo que las cifras no coinciden.
- Visitantes de IA: a principios de 2025, había 1 visita de IA por cada 200 personas; en el segundo trimestre, 1 por cada 50 (TollBit). A finales de 2025, 1 por cada 31 (TechRadar).
- Desplazamiento del entrenamiento a las respuestas: del segundo al cuarto trimestre de 2025, el crawling para entrenamiento disminuyó aproximadamente un 15%, los bots RAG aumentaron un ~33% y los indexadores de IA un ~59% (Digiday vía TollBit).
- Referencias: el CTR de clics desde herramientas de IA a sitios de editores cayó del 0,8% (Q2) al 0,27% (Q4 2025) (Digiday vía TollBit). Las referencias de Google a sitios de noticias en marzo de 2025 fueron un ~9% inferiores a las de enero (Cloudflare).
- AI Overviews y CTR: el CTR orgánico en consultas informativas con AIO cayó un 61%, de 1,76% (junio de 2024) a 0,61% (septiembre de 2025) (Seer Interactive). Sin embargo, un estudio actualizado mostró un cambio: 1,3% en diciembre de 2025 → 2,4% en febrero de 2026 (Seer Interactive, 2026). No se debe extrapolar 2025 a 2026.
- Geografía: más del 90% del tráfico de crawling de Meta y Google se dirige a sitios de Norteamérica (Fastly). Por lo tanto, los datos para los modelos están sesgados hacia el contenido en inglés.
⚖️ Sección 6: Desafíos éticos
El principal problema es la asimetría: los bots toman contenido, pero devuelven pocos visitantes (ver tabla en la sección 3). Las reglas voluntarias no corrigen esto.
- Ignoran robots.txt. Porcentaje de solicitudes de IA que eludieron robots.txt: 3,3% (Q4 2024) → 13,26% (Q2 2025) (TollBit) → alrededor del 30% (Q4 2025), y ChatGPT-User un 42% (Digiday). Según el informe de TollBit, los términos actualizados de las grandes empresas de IA permiten a los bots que actúan a petición del usuario no tener en cuenta robots.txt (Digiday).
- Demandas. El 5 de diciembre de 2025, The New York Times presentó una demanda contra Perplexity (TechCrunch). La demanda, en particular, afirma que los crawlers de Perplexity eludieron intencionadamente las medidas técnicas de protección, incluido robots.txt. Anteriormente, el 11 de junio de 2025, Disney y NBCUniversal presentaron una demanda contra Midjourney (AfroTech).
- Estándares y pago. RSL 1.0 (especificación oficial del 10 de diciembre de 2025) amplía robots.txt: permite definir condiciones y pagos por separado para entrenamiento y búsqueda de IA (RSL). Por sí solo, no detiene al bot, pero cuenta con el apoyo de Cloudflare, Akamai y Fastly (The Verge). Cloudflare está desarrollando Pay Per Crawl en Pay Per Use (sección 7).
- llms.txt — no es un mecanismo de permisos. Es una propuesta de archivo índice para modelos. Google declaró que no lo apoya (Stan Ventures), y el acceso al sitio se gestiona mediante robots.txt.
Conclusión práctica: las señales (robots.txt, RSL) son peticiones, y la ejecución forzosa se necesita a nivel de CDN/WAF.
🛡️ Sección 7: Problemas técnicos y soluciones
Problemas. Los picos de fetchers de hasta 39.000 requests/min pueden parecerse a un DDoS sin intención maliciosa (Fastly). Más de la mitad del tráfico de crawling son descargas repetidas de páginas sin cambios (TechCrunch). Parte de los bots ignoran robots.txt (sección 6).
1. robots.txt por propósito del bot
OpenAI y Anthropic han dividido los bots por objetivos (OpenAI, Anthropic):
| Empresa | Entrenamiento | Búsqueda | Solicitud de usuario |
|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google | Google-Extended (token) | Googlebot | — |
Para seguir apareciendo en las respuestas de IA, pero no ceder contenido para entrenamiento, bloquea solo los tokens de entrenamiento:
# Entrenamiento de modelos — bloqueamos
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

# Búsqueda y solicitudes de usuario — permitimos
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Google-Extended es un token de control en robots.txt, no un crawler separado (Cloudflare). Prohíbe su uso para Gemini, pero no afecta a la Búsqueda. Googlebot rastrea también para AI Overviews y AI Mode (TechCrunch). Para los bots "a petición del usuario", robots.txt no es una garantía (sección 6).
2. Cloudflare AI Crawl Control
Cloudflare divide los bots en Search, Agent y Training y permite controlar cada categoría por separado, incluso en el plan gratuito (Search Engine Journal). A partir del 15 de septiembre de 2026, para dominios nuevos, sitios nuevos y cuentas gratuitas que no hayan modificado la configuración, Training y Agent se bloquearán en páginas con publicidad, mientras que Search estará permitido (TechCrunch).
Trampa: los crawlers mixtos (Googlebot, Applebot, Bingbot) se evalúan según la regla más estricta. Cualquier bloqueo de Training, incluido el antiguo interruptor "Block AI bots", también les afecta (Search Engine Journal). Comprueba la configuración y los logs: Googlebot no debería recibir un 403.
3. Pago: Pay Per Use y RSL
Pay Per Crawl (un marketplace donde los sitios cobran a los bots de IA) se está convirtiendo en Pay Per Use: se paga cuando el contenido crea valor en la respuesta de IA, no solo por descargarlo. Los primeros socios son Ceramic.ai y You.com (TechCrunch). Una alternativa sin vinculación a CDN es RSL 1.0: condiciones de licencia en formato legible por máquina, se integra con robots.txt (The Register).
4. Si quieres que la IA te vea
- Sirve el contenido importante en el HTML inicial (SSR/SSG), ya que la mayoría de los crawlers de IA no ejecutan JavaScript (Vercel, datos de 2024 — comprueba tus logs).
- Mantén actualizados los redireccionamientos y el sitemap para que los bots no lleguen a 404 (Vercel).
5. Monitorización
Cuenta las solicitudes por user-agent en los logs y compara las IPs con los rangos publicados (OpenAI publica gptbot.json). Comprueba por separado que Googlebot y Bingbot no reciban 403 o desafíos.
🔮 Sección 8: El futuro del crawling
A continuación, no encontrarás hipótesis, sino cambios que ya han sido anunciados o están en vigor.
- Los bots se dividen por propósito. Cloudflare ha dado a las empresas de IA hasta el 15 de septiembre de 2026 para separar los rastreadores de búsqueda de los de entrenamiento y agentes, y está bloqueando los mixtos en páginas con publicidad (TechCrunch).
- Pago por uso. Pay Per Crawl se está convirtiendo en Pay Per Use (TechCrunch). Paralelamente, se está desarrollando RSL 1.0, un estándar abierto para los términos de licencia (The Register). Los editores ya están licenciando contenido directamente: según el WSJ, Amazon paga a The New York Times entre 20 y 25 millones de dólares al año (eWeek). En el primer trimestre de 2026, USA Today Co. calificó por primera vez los ingresos por licencias de IA como "notables" (Digiday).
- Regulación en la UE. Las obligaciones de la Ley de IA para modelos de propósito general entran en vigor el 2 de agosto de 2025. El Código de Prácticas voluntario menciona explícitamente robots.txt como un protocolo que debe respetarse (Jones Day). La Comisión ha estado estudiando qué otros protocolos de exclusión voluntaria reconocer (CEPIC), por lo que la lista podría ampliarse.
- Los agentes van más allá de robots.txt. Los bots ya generan el 57,5% de las solicitudes HTML, y el impulsor es el tráfico de agentes (Tom's Hardware). OpenAI señala que las reglas de robots.txt pueden no aplicarse a ChatGPT-User (OpenAI). El control se está desplazando hacia CDN/WAF y la autenticación.
- Búsqueda. Semrush pronosticó en 2025 que para temas de marketing digital y SEO, los visitantes de la búsqueda con IA podrían superar a los de la búsqueda tradicional a principios de 2028 (Semrush). Esta es una predicción, y los CTR reales ya fluctúan (sección 5).
Qué hacer ahora: separa los bots en robots.txt por propósito, verifica que Googlebot no reciba 403, monitoriza los logs y Cloudflare Radar, y decide si activar el pago (Pay Per Use, RSL) (ver sección 7).
❓ Preguntas frecuentes (FAQ)
- ¿GPTBot respeta robots.txt?
GPTBot y OAI-SearchBot sí, se pueden gestionar por separado en robots.txt. ChatGPT-User no está garantizado: OpenAI escribe que, dado que las acciones son iniciadas por el usuario, las reglas de robots.txt pueden no aplicarse (documentación de OpenAI). Para cerrar completamente el acceso, se necesita una regla a nivel de servidor o WAF.
- ¿Cómo afectan los rastreadores de IA a un sitio web?
Carga: los picos de fetchers alcanzaron 39.000 solicitudes por minuto (Fastly), y más del 50% del tráfico de rastreo de bots de IA son recargas de páginas sin cambios (TechCrunch). Retorno: el CTR de las transiciones de herramientas de IA a sitios de editores en el cuarto trimestre de 2025 fue del 0,27% (Digiday vía TollBit). La proporción real de bots en tu sitio se mostrará en los logs.
- ¿Cómo monetizar el contenido?
Los acuerdos directos hasta ahora se aplican a grandes editores (ejemplo: NYT y Amazon). Para el resto, existe Pay Per Use de Cloudflare (el editor lo activa voluntariamente; los primeros socios son Ceramic.ai y You.com) y los términos de licencia RSL 1.0 (RSL).
- ¿Quién lidera entre los rastreadores de IA?
Depende de la fuente y el período. Cloudflare (mayo de 2025, entre bots de IA): GPTBot - 30%, ClaudeBot - 21%, Meta-ExternalAgent - 19% (Cloudflare). Fastly (abril-julio de 2025, red Fastly): Meta - 52% del tráfico de rastreo de IA, Google - 23%, OpenAI - 20%. Consulta los datos actuales en Cloudflare Radar.
- ¿Debería bloquear todos los bots de IA?
No necesariamente. Bloquea los tokens de entrenamiento (GPTBot, ClaudeBot, Google-Extended), y deja los bots de búsqueda y "a petición del usuario" si quieres aparecer en las respuestas de IA (ejemplo: sección 7). Existe un riesgo: en Cloudflare, el bloqueo de la categoría Training, incluido el antiguo interruptor "Block AI bots", también afecta a rastreadores mixtos como Googlebot (Search Engine Journal).
✅ Conclusiones
El rastreo de IA difiere del de búsqueda en su propósito y retorno: principalmente entrenamiento y respuestas sin transición a la fuente. Los bots ya generan el 57,5% de las solicitudes HTML, y robots.txt solo pide, no obliga. Por lo tanto, es útil seguir un esquema simple:
- separa los bots por propósito en robots.txt (entrenamiento, búsqueda, solicitud del usuario);
- verifica la configuración de CDN: Googlebot y Bingbot no deben recibir 403;
- para la visibilidad en IA, entrega contenido importante en el HTML inicial;
- monitoriza los logs y Cloudflare Radar, y aborda las cuestiones de pago a través de Pay Per Use o RSL.
Lee sobre datos estructurados para tu sitio en los materiales sobre Schema.org y la verificación de marcado.
🔥 Lee también
