KI-Bots scannen Websites nicht zur Indexierung, sondern zum Trainieren von Modellen und für Antworten ohne Quellverweis. Automatisierter Traffic hat den menschlichen bereits übertroffen, daher benötigen Website-Betreiber Zugriffskontrollen und, wenn möglich, Bezahlung für Inhalte.
⚡ Kurz gesagt
- ✅ Ausmaß: Laut Cloudflare Radar generierten Bots Anfang Juni 2026 57,5 % der HTML-Anfragen gegenüber 42,5 % bei Menschen. Haupttreiber ist agentenbasierte KI (Tom's Hardware).
- ✅ Zweck: Fast 80 % des KI-Crawlings dienen dem Training von Modellen, nicht der Suche. Verweise sind minimal: Im Juli 2025 machte Anthropic etwa 38.000 Crawls pro Verweis (Cloudflare).
- ✅ Kontrolle: Ab dem 15. September 2026 blockiert Cloudflare standardmäßig „Mixed-Use“-Crawler auf Seiten mit Werbung (TechCrunch), und Pay Per Crawl wird zu Pay Per Use (Technology.org).
🎯 Abschnitt 1: Einführung in das Crawling im KI-Zeitalter
Crawling ist das automatisierte Scannen von Websites durch Bots. Suchbots (Googlebot, Bingbot) indexieren Seiten und leiten Besucher zurück. KI-Bots (GPTBot, ClaudeBot, Meta-ExternalAgent) sammeln hauptsächlich Daten für das Training von LLMs sowie für RAG und Echtzeit-Antworten. Laut Cloudflare entfielen 2025 etwa 80 % des KI-Crawlings auf das Training, 18 % auf die Suche und 2 % auf Benutzeraktionen (Cloudflare).
Die Konsequenz für eine Website: Inhalte landen in KI-Antworten, aber Besucher und Werbeeinnahmen nicht. Hinzu kommt die Belastung der Infrastruktur: Automatisierter Traffic macht bereits 57,5 % der HTML-Anfragen aus (Tom's Hardware).
Auch die Spielregeln ändern sich. Ab dem 15. September 2026 blockiert Cloudflare „Mixed-Use“-Crawler (die Suche, Agenten und Training kombinieren) auf Seiten mit Werbung. Dies gilt für Neukunden, neue Websites und kostenlose Pläne (TechCrunch). Auch das Bezahlmodell ändert sich: Anstatt pro Seitenaufruf erhält der Publisher Geld, wenn der Inhalt tatsächlich in einer KI-Antwort verwendet wird (Technology.org).
📚 Abschnitt 2: Traditionelles Crawling – Grundlagen
Traditionelles Crawling ist seit den 1990er Jahren die Grundlage der Suchmaschinenindizierung. Ein Bot startet von einer Seed-URL (bekannte Adressen, Sitemap), folgt Links, extrahiert Text, Meta-Tags und HTML-Struktur, rendert JavaScript und erstellt einen Index. Zugriffsregeln holt sich der Bot aus robots.txt und indexiert die mobile Version von Seiten (Mobile-First).
Beispiele für User-Agents:
- Googlebot:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
- Bingbot:
Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)
Der entscheidende Unterschied zu KI-Bots ist der Rückverkehr. Im Jahr 2025 machte Google zwischen 3,8 und 22,5 Crawls pro Website-Besuch (Januar–Juli), also im einstelligen und zweistelligen Bereich, nicht im Tausenderbereich (Cloudflare). Der Tausch „Sichtbarkeit in der Suche gegen Zugriff auf Inhalte“ funktionierte. Beim KI-Crawling ist dieser Tausch fast kaputt.
🔄 Abschnitt 3: Evolution zu KI-Crawlern
Bis 2023 indexierten Crawler hauptsächlich Seiten für die Suche. Nach dem Boom der generativen KI entstanden Bots zum Trainieren von Modellen, zur Suche in KI-Assistenten und für Echtzeit-Benutzeranfragen. Meta, OpenAI und Anthropic nutzen dafür eigene Bots, während Google und Microsoft einheitliche Crawler verwenden (Cloudflare). Genau diese „gemischten“ Bots ohne klare Zieltrennung blockiert Cloudflare nun standardmäßig.
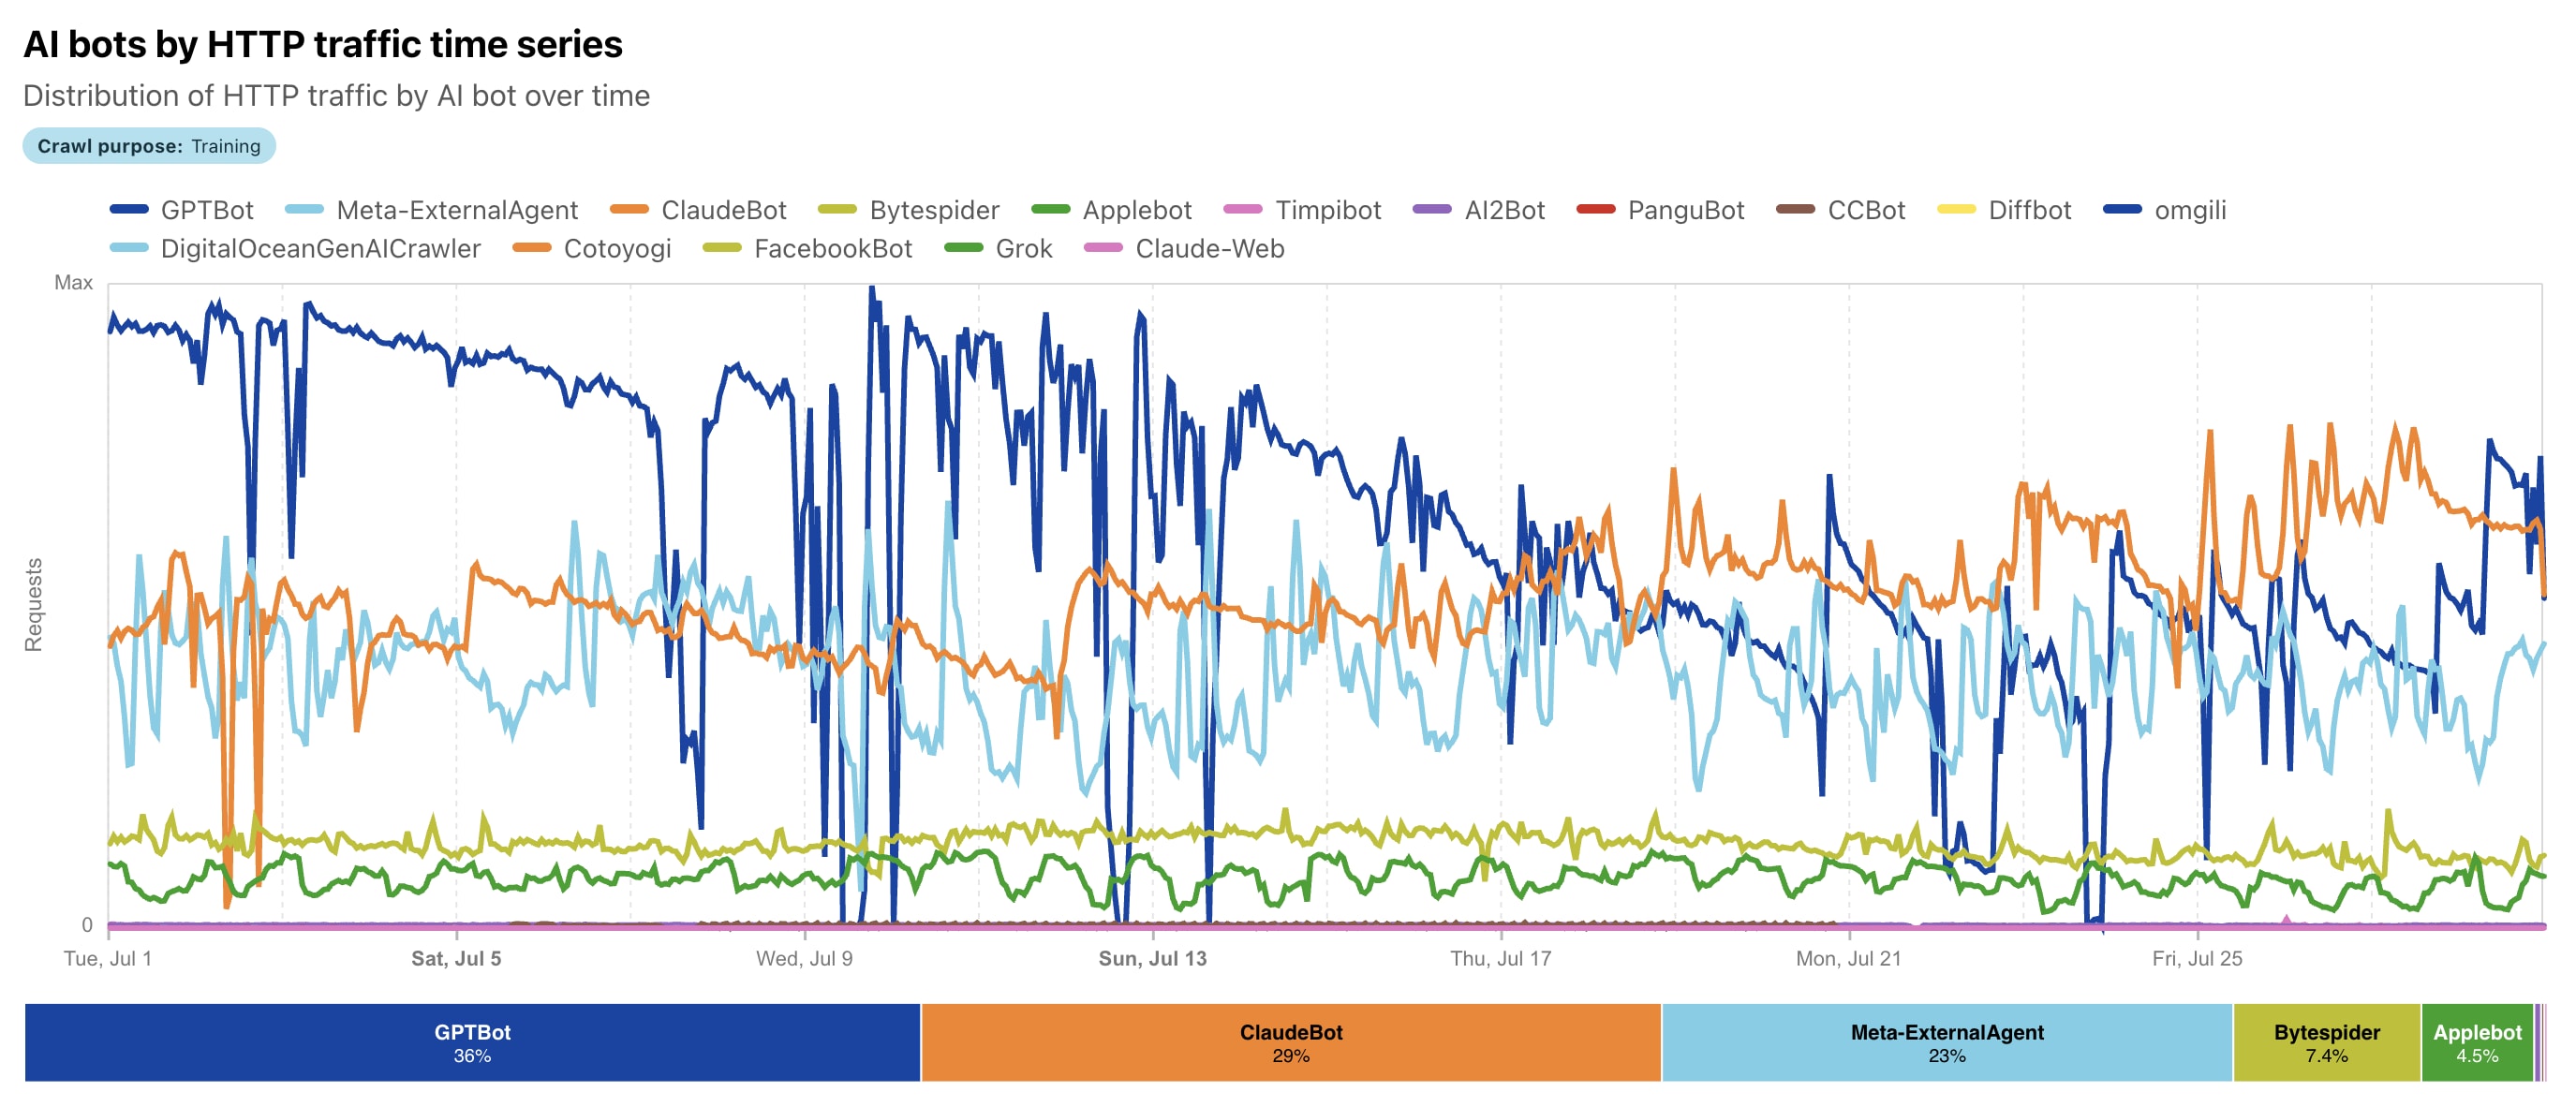
Anteile unter KI-Bots, Mai 2024 → Mai 2025 (Cloudflare):
| Bot | 2024 | 2025 |
|---|
| GPTBot (OpenAI) | 5% | 30% |
| ClaudeBot (Anthropic) | 27% | 21% |
| Meta-ExternalAgent | — | 19% |
| Amazonbot | 21% | 11% |
| Bytespider (ByteDance) | 42% | 7,2% |
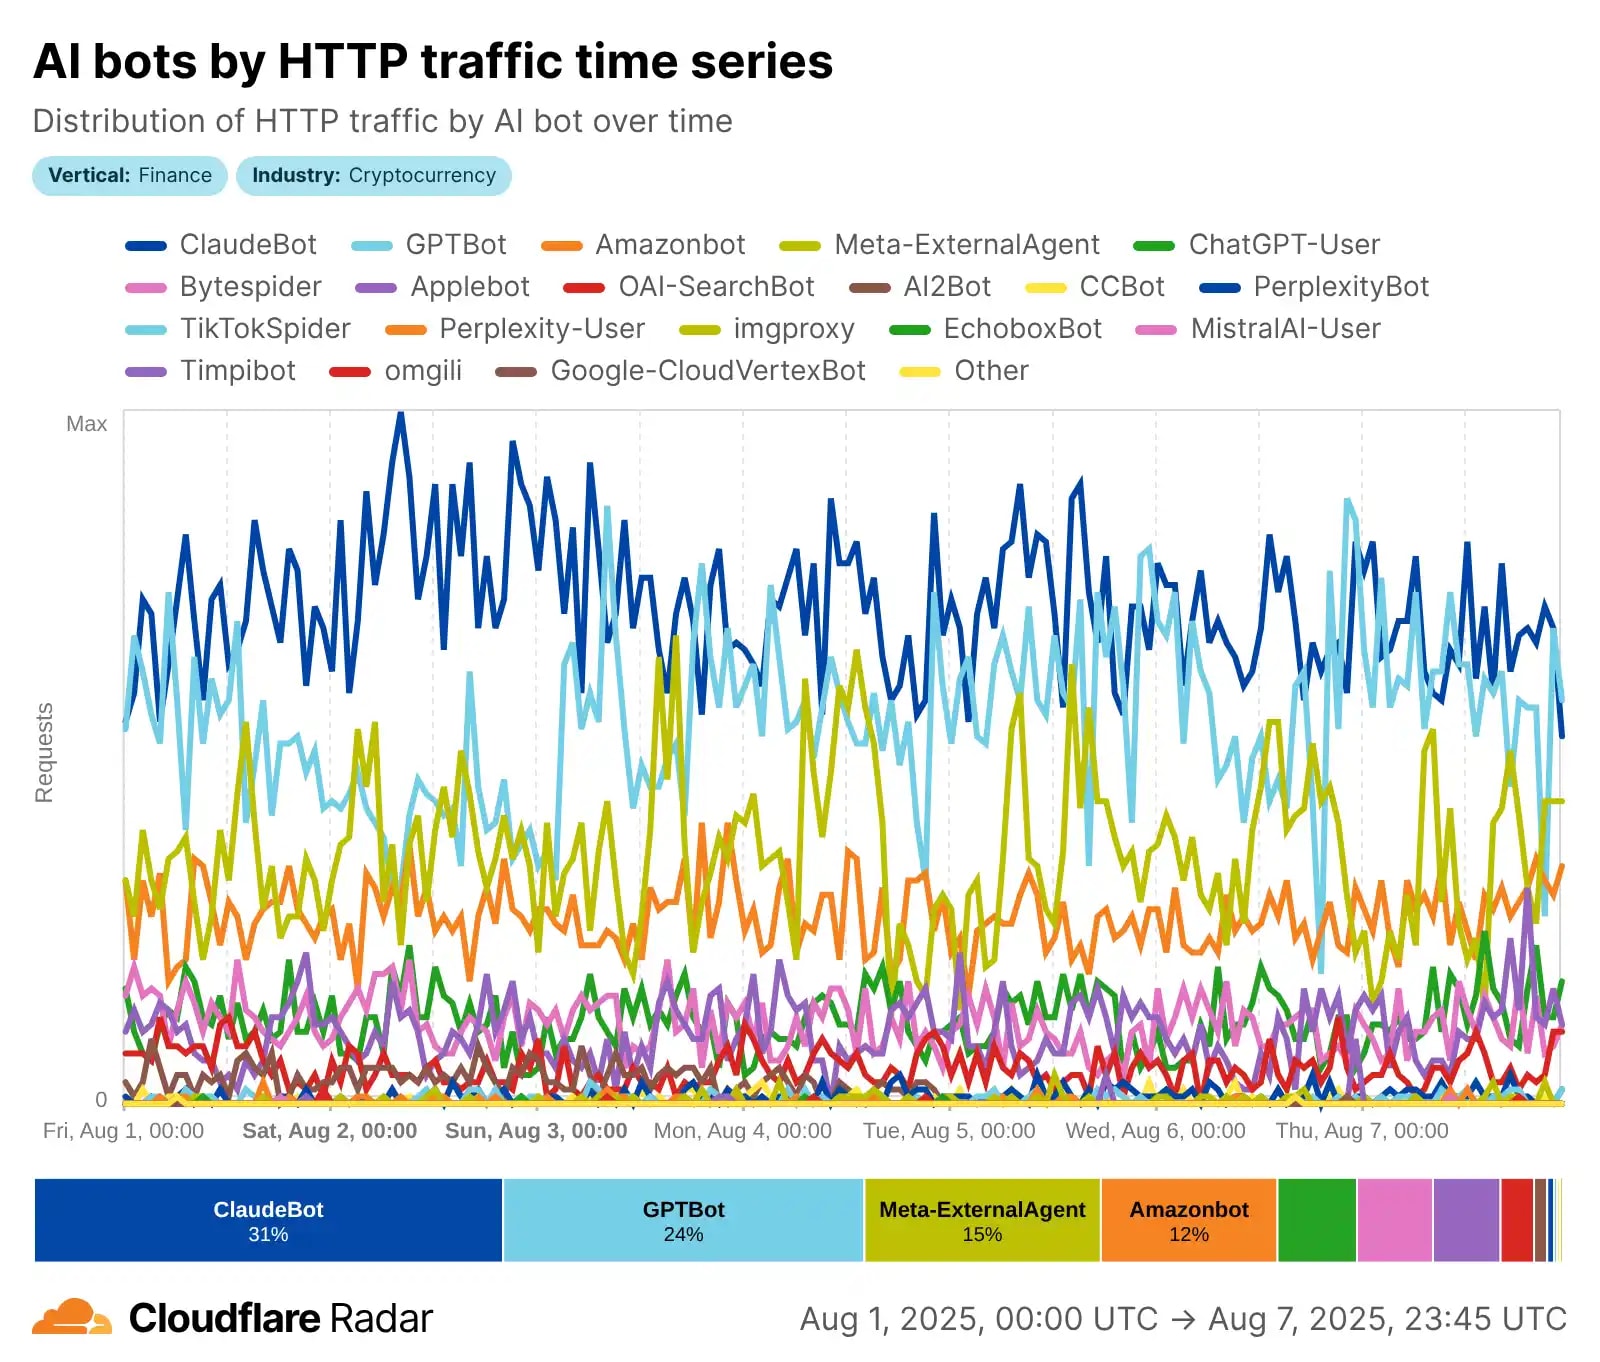
Die Anteile ändern sich monatlich, den aktuellen Stand findest du unter Cloudflare Radar AI Insights.
Anzahl der Crawls pro Verweis, Juli 2025 (Cloudflare):
| Plattform | Crawls pro 1 Verweis |
|---|
| Anthropic | ~38.000 (im Januar waren es ~287.000) |
| OpenAI | ~1.100 |
| Perplexity | ~195 |
| Microsoft | ~41 |
| Google | ~5 |
📖 Lies auch
⚙️ Abschnitt 4: Funktionsweise von KI-Crawlern
Technisch gesehen funktioniert ein KI-Crawler wie jeder andere Bot: Anfrage, HTML, Verarbeitung. Der Unterschied liegt in Ziel und Verhalten. Cloudflare klassifiziert Bots nach ihrem Zweck: Modelltraining, Suche, Benutzeraktionen (Cloudflare). Im Jahr 2026 werden dies in den Cloudflare-Einstellungen die Kategorien Search, Agent und Training sein (Search Engine Journal).
- Entdeckung. URLs werden aus Sitemaps, Links und früheren Crawls bezogen. Die URL-Auswahl ist weniger präzise als bei Google: Bei etwa 34 % der Anfragen landeten ChatGPT und Claude auf 404, bei Googlebot waren es 8 % (Vercel, Daten vom Dezember 2024).
- Download. HTTP-Anfrage mit dem User-Agent des Bots. Laut einer Vercel-Studie führte keiner der großen KI-Crawler (OpenAI, Anthropic, Meta, ByteDance, Perplexity) JavaScript aus. Ausnahmen sind Gemini (über die Googlebot-Infrastruktur) und Applebot. Inhalte, die nur clientseitig erscheinen, sehen sie nicht.
- Bot-Typ. Etwa 80 % des KI-Bot-Traffics entfallen auf Crawler, die Daten im Voraus sammeln. Die restlichen 20 % sind Fetcher, die Seiten in Echtzeit auf Benutzeranfrage abrufen (Fastly, April–Juli 2025).
- Umfang. Die Spitzen bei Fetchern erreichten 39.000 Anfragen pro Minute (Fastly). Über 50 % des KI-Bot-Crawler-Traffics sind erneute Downloads unveränderter Seiten (Cloudflare-Daten laut TechCrunch). Zum Vergleich: Im Vercel-Netzwerk tätigte GPTBot im Dezember 2024 569 Millionen Anfragen, Claude 370 Millionen und Googlebot 4,5 Milliarden (Vercel, Dezember 2024).
📊 Abschnitt 5: Statistiken und Traffic-Auswirkungen (2025–2026)
- Bot-Anteil: 57,5 % der HTML-Anfragen gegenüber 42,5 % bei Menschen (Cloudflare, Juni 2026).
- Wachstum der Crawler (Mai 2024 → Mai 2025): GPTBot +305 % Anfragen, Googlebot +96 % (Cloudflare).
- Wer crawlt: Laut Fastly (April–Juli 2025, Fastly-Netzwerk) entfallen 52 % des KI-Crawler-Traffics auf Meta, 23 % auf Google und 20 % auf OpenAI. Bei Cloudflare beträgt der Anteil von Meta-ExternalAgent 19 % (Mai 2025). Die Methoden sind unterschiedlich, daher stimmen die Zahlen nicht überein.
- KI-Besucher: Anfang 2025 kam auf 200 Menschen ein KI-Besuch, im zweiten Quartal war es 1 zu 50 (TollBit). Ende 2025 war es 1 zu 31 (TechRadar).
- Verschiebung von Training zu Antworten: Vom zweiten bis zum vierten Quartal 2025 sank das Training-Crawling um etwa 15 %, RAG-Bots stiegen um ca. 33 % und KI-Indexer um ca. 59 % (Digiday laut TollBit).
- Referrer: Die Klickrate (CTR) von Übergängen von KI-Tools zu Publisher-Websites sank von 0,8 % (Q2) auf 0,27 % (Q4 2025) (Digiday laut TollBit). Google-Referrer zu Nachrichten-Websites waren im März 2025 etwa 9 % niedriger als im Januar (Cloudflare).
- AI Overviews und CTR: Die organische CTR für Informationsanfragen mit AIO sank um 61 % – von 1,76 % (Juni 2024) auf 0,61 % (September 2025) (Seer Interactive). Eine aktualisierte Studie zeigte jedoch eine Umkehrung: 1,3 % im Dezember 2025 → 2,4 % im Februar 2026 (Seer Interactive, 2026). Eine Hochrechnung von 2025 auf 2026 ist nicht ratsam.
- Geografie: Über 90 % des Crawler-Traffics von Meta und Google sind auf Websites in Nordamerika gerichtet (Fastly). Daher sind die Daten für die Modelle auf englischsprachige Inhalte ausgerichtet.
⚖️ Abschnitt 6: Ethische Herausforderungen
Das Hauptproblem ist die Asymmetrie: Bots nehmen Inhalte, aber geben wenig Besucher zurück (siehe Tabelle in Abschnitt 3). Freiwillige Regeln beheben dies nicht.
- robots.txt wird ignoriert. Der Anteil der KI-Anfragen, die robots.txt umgingen: 3,3 % (Q4 2024) → 13,26 % (Q2 2025) (TollBit) → etwa 30 % (Q4 2025), und ChatGPT-User – 42 % (Digiday). Laut einem TollBit-Bericht erlauben die aktualisierten Bedingungen großer KI-Unternehmen Bots, die auf Benutzeranfrage handeln, robots.txt zu ignorieren (Digiday).
- Klagen. Am 5. Dezember 2025 reichte die New York Times Klage gegen Perplexity ein (TechCrunch). Die Klage behauptet unter anderem, dass die Crawler von Perplexity absichtlich technische Schutzmaßnahmen umgangen hätten, einschließlich robots.txt. Zuvor, am 11. Juni 2025, reichten Disney und NBCUniversal Klage gegen Midjourney ein (AfroTech).
- Standards und Bezahlung. RSL 1.0 (offizielle Spezifikation vom 10. Dezember 2025) erweitert robots.txt: Es erlaubt, Bedingungen und Bezahlung separat für Training und KI-Suche festzulegen (RSL). Allein stoppt es den Bot nicht, aber es wird von Cloudflare, Akamai und Fastly unterstützt (The Verge). Cloudflare entwickelt Pay Per Crawl zu Pay Per Use weiter (Abschnitt 7).
- llms.txt – kein Erlaubnis-Mechanismus. Dies ist ein Vorschlag für eine Indexdatei für Modelle. Google hat erklärt, dass es diese nicht unterstützt (Stan Ventures), und der Website-Zugriff wird durch robots.txt gesteuert.
Praktisches Fazit: Signale (robots.txt, RSL) sind Bitten, eine erzwungene Durchsetzung ist auf CDN/WAF-Ebene erforderlich.
🛡️ Abschnitt 7: Technische Probleme und Lösungen
Probleme. Die Spitzen von Fetchern mit bis zu 39.000 Anfragen/Minute können wie eine DDoS-Attacke ohne böswillige Absicht wirken (Fastly). Mehr als die Hälfte des Crawler-Traffics sind wiederholte Downloads unveränderter Seiten (TechCrunch). Ein Teil der Bots ignoriert robots.txt (Abschnitt 6).
1. robots.txt nach Bot-Zweck
OpenAI und Anthropic haben ihre Bots nach Zielen aufgeteilt (OpenAI, Anthropic):
| Unternehmen | Training | Suche | Benutzeranfrage |
|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google | Google-Extended (Token) | Googlebot | — |
Um in KI-Antworten sichtbar zu sein, aber keine Inhalte für das Training bereitzustellen, blockieren Sie nur die Trainings-Tokens:
# Modelltraining – blockieren
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

# Suche und Benutzeranfragen – erlauben
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Google-Extended ist ein Steuerungs-Token in robots.txt, kein separater Crawler (Cloudflare). Es verbietet die Nutzung für Gemini, beeinflusst aber nicht die Suche. Googlebot crawlt auch für AI Overviews und AI Mode (TechCrunch). Für Bots „auf Benutzeranfrage“ ist robots.txt keine Garantie (Abschnitt 6).
2. Cloudflare AI Crawl Control
Cloudflare teilt Bots in Search, Agent und Training ein und ermöglicht die separate Steuerung jeder Kategorie, sogar im kostenlosen Tarif (Search Engine Journal). Ab dem 15. September 2026 werden für neue Domains, neue Websites und kostenlose Konten, die ihre Einstellungen nicht geändert haben, Training und Agent auf Seiten mit Werbung blockiert, während Search erlaubt ist (TechCrunch).
Falle: gemischte Crawler (Googlebot, Applebot, Bingbot) werden nach der strengsten Regel bewertet. Jede Blockierung von Training, einschließlich des alten Schalters „Block AI bots“, betrifft auch sie (Search Engine Journal). Überprüfen Sie Ihre Einstellungen und Logs: Googlebot sollte kein 403 erhalten.
3. Bezahlung: Pay Per Use und RSL
Pay Per Crawl (ein Marktplatz, auf dem Websites KI-Bots zur Kasse bitten) entwickelt sich zu Pay Per Use: Bezahlt wird, wenn der Inhalt Wert in einer KI-Antwort schafft, nicht nur für den Download. Erste Partner sind Ceramic.ai und You.com (TechCrunch). Eine Alternative ohne CDN-Bindung ist RSL 1.0: maschinenlesbare Lizenzbedingungen, integriert mit robots.txt (The Register).
4. Wenn Sie von KI gesehen werden möchten
- Stellen Sie wichtige Inhalte im ursprünglichen HTML bereit (SSR/SSG), da die meisten KI-Crawler kein JavaScript ausführen (Vercel, Daten von 2024 – überprüfen Sie Ihre Logs).
- Halten Sie Redirects und Sitemaps aktuell, damit Bots nicht auf 404 stoßen (Vercel).
5. Überwachung
Zählen Sie Anfragen nach User-Agent in Ihren Logs und gleichen Sie IP-Adressen mit veröffentlichten Bereichen ab (OpenAI veröffentlicht gptbot.json). Überprüfen Sie separat, dass Googlebot und Bingbot keine 403 oder Challenges erhalten.
🔮 Abschnitt 8: Die Zukunft des Crawlings
Unten sind keine Hypothesen, sondern Änderungen, die bereits angekündigt wurden oder in Kraft sind.
- Bots werden nach Zweck getrennt. Cloudflare hat KI-Unternehmen eine Frist bis zum 15. September 2026 gesetzt, um Such-Crawler von Trainings- und Agenten-Crawlern zu trennen, und blockiert gemischte Crawler auf Seiten mit Werbung (TechCrunch).
- Bezahlung nach Nutzung. Pay Per Crawl wird zu Pay Per Use (TechCrunch). Parallel dazu entwickelt sich RSL 1.0 – ein offener Standard für Lizenzbedingungen (The Register). Verlage lizenzieren Inhalte bereits direkt: Laut WSJ zahlt Amazon der New York Times jährlich 20–25 Millionen US-Dollar (eWeek). Im ersten Quartal 2026 nannte USA Today Co. erstmals Einnahmen aus KI-Lizenzen als „bemerkenswert“ (Digiday).
- Regulierung in der EU. Die Verpflichtungen des AI Acts für allgemeine KI-Modelle gelten ab dem 2. August 2025. Der freiwillige Verhaltenskodex nennt robots.txt ausdrücklich als zu respektierendes Protokoll (Jones Day). Die Kommission hat untersucht, welche weiteren Opt-out-Protokolle anerkannt werden sollen (CEPIC), sodass die Liste erweitert werden könnte.
- Agenten gehen über robots.txt hinaus. Bots machen bereits 57,5 % der HTML-Anfragen aus, und der Treiber ist der Agentenverkehr (Tom's Hardware). OpenAI stellt fest, dass für ChatGPT-User die robots.txt-Regeln möglicherweise nicht gelten (OpenAI). Die Kontrolle verlagert sich auf CDN/WAF und Authentifizierung.
- Suche. Semrush prognostizierte 2025, dass für Themen wie Digital Marketing und SEO die Besucher aus der KI-Suche Anfang 2028 mehr sein könnten als aus der traditionellen Suche (Semrush). Dies ist eine Prognose, und die tatsächlichen CTRs schwanken bereits (Abschnitt 5).
Was du jetzt tun kannst: Trenne Bots in robots.txt nach Zweck, stelle sicher, dass Googlebot keine 403-Fehler erhält, überwache Logs und Cloudflare Radar und entscheide, ob du die Bezahlung (Pay Per Use, RSL) aktivieren möchtest (siehe Abschnitt 7).
❓ Häufig gestellte Fragen (FAQ)
- Respektiert GPTBot robots.txt?
GPTBot und OAI-SearchBot – ja, sie können separat in robots.txt gesteuert werden. ChatGPT-User – nicht garantiert: OpenAI schreibt, dass da die Aktionen vom Nutzer initiiert werden, die robots.txt-Regeln möglicherweise nicht gelten (OpenAI-Dokumentation). Um den Zugriff vollständig zu sperren, ist eine Regel auf Server- oder WAF-Ebene erforderlich.
- Wie wirken sich KI-Crawler auf eine Website aus?
Last: Fetcher-Spitzen erreichten 39.000 Anfragen pro Minute (Fastly), und über 50 % des KI-Bot-Crawler-Traffics sind erneute Downloads unveränderter Seiten (TechCrunch). Ertrag: Die CTR von Übergängen aus KI-Tools zu Publisher-Websites betrug im vierten Quartal 2025 0,27 % (Digiday via TollBit). Der tatsächliche Anteil von Bots auf deiner Website wird in den Logs angezeigt.
- Wie kann man mit Inhalten Geld verdienen?
Direkte Vereinbarungen betreffen bisher große Verlage (Beispiel: NYT und Amazon). Für den Rest gibt es Pay Per Use von Cloudflare (Publisher aktivieren es nach eigenem Ermessen; erste Partner sind Ceramic.ai und You.com) und die Lizenzbedingungen von RSL 1.0 (RSL).
- Wer ist führend unter den KI-Crawlern?
Abhängig von der Quelle und dem Zeitraum. Cloudflare (Mai 2025, unter den KI-Bots): GPTBot – 30 %, ClaudeBot – 21 %, Meta-ExternalAgent – 19 % (Cloudflare). Fastly (April–Juli 2025, Fastly-Netzwerk): Meta – 52 % des KI-Crawler-Traffics, Google – 23 %, OpenAI – 20 %. Aktuelle Daten findest du unter Cloudflare Radar.
- Sollte man alle KI-Bots blockieren?
Nicht unbedingt. Blockiere Trainings-Tokens (GPTBot, ClaudeBot, Google-Extended), aber lass Such-Bots und Bots „auf Anfrage des Nutzers“ zu, wenn du in KI-Antworten erscheinen möchtest (Beispiel: Abschnitt 7). Es gibt ein Risiko: Bei Cloudflare blockiert die Kategorie „Training“, insbesondere der alte Schalter „Block AI bots“, auch gemischte Crawler wie Googlebot (Search Engine Journal).
✅ Schlussfolgerungen
KI-Crawling unterscheidet sich vom Such-Crawling in Ziel und Ertrag: hauptsächlich Training und Antworten ohne Übergang zur Quelle. Bots machen bereits 57,5 % der HTML-Anfragen aus, und robots.txt ist nur eine Bitte, keine Verpflichtung. Daher ist es sinnvoll, nach einem einfachen Schema vorzugehen:
- Trenne Bots in robots.txt nach Zweck (Training, Suche, Nutzeranfrage);
- Überprüfe die CDN-Einstellungen: Googlebot und Bingbot sollten keine 403-Fehler erhalten;
- Um in KI sichtbar zu sein, liefere wichtige Inhalte im initialen HTML aus;
- Überwache Logs und Cloudflare Radar und kläre die Frage der Bezahlung über Pay Per Use oder RSL.
Über strukturierte Daten für deine Website liest du in den Artikeln über Schema.org und die Überprüfung von Markup.
🔥 Lies auch
