Agent Chat: Zwei KI-Agenten streiten sich über Spring Boot
Wie man ein Multi-Agenten-System mit Spring AI aufbaut: @Async Dialogschleife, Umschalten zwischen Ollama und OpenRouter über @Profile, fünf Tools und Prompts, die Agente
Nützliche Artikel zu Java, Spring, SEO, Frontend und modernen Technologien. Tipps, Beispiele und Lifehacks für Entwickler
Wie man ein Multi-Agenten-System mit Spring AI aufbaut: @Async Dialogschleife, Umschalten zwischen Ollama und OpenRouter über @Profile, fünf Tools und Prompts, die Agente
GPT-Realtime-2 vs Gemini Live API im Vergleich: Preise, Benchmarks, Video, SIP, Sprachen. 6-facher Preisunterschied — welches passt zu Ihrem Szenario? Mai 2026.
GPT-5.5 in Codex: 82,7% auf Terminal-Bench, ~40% weniger Token pro Aufgabe, neuer Fast-Modus. Vergleich mit GPT-5.4, Einschränkungen und praktische Erfahrungen des Entwic
WebSocket, WebRTC, SIP – Schritt-für-Schritt-Anleitung zur Verbindung von GPT-Realtime-2. JS- und Python-Code, Präambeln, Tool-Aufrufe, typische Fehler. Aktuell Mai 2026.
OpenAI hat GPT-Realtime-2, Translate und Whisper veröffentlicht. Was sich geändert hat, reale Zahlen von Zillow und Deutsche Telekom, Preise und warum OpenRouter nicht ge
Welche Ollama-Modelle unterstützen 2026 wirklich Tool Calling: Vergleich von qwen3, llama3.1, gemma4, mistral-nemo. Benchmarks, Zuverlässigkeitstabelle, typische Fehler
GPT-5.3-Codex-Spark – das erste Echtzeit-Codex-Modell: >1000 Tokens/Sek. auf Cerebras. Was ist der Unterschied zu GPT-5.5, wie in der Codex App aktivieren

OpenAI Codex у 2026 році — це не той інструмент, про який ви, можливо, читали кілька років тому. Оригінальний Codex API (2021–2023) був моделлю для автодоповнення коду на базі GPT-3, яка живила ранні версії GitHub Copilot. OpenAI закрила той API у березні 2023 року. Те, що існує сьогодні —...
Vollständiger Leitfaden zur Ollama API: /api/chat, Streaming, Embeddings, Tool Calling. Beispiele in Java (WebClient + Spring Boot), Python und JavaScript mit funktionier
Ehrlicher Vergleich ohne Fanatismus: Wo Ollama bei Datenschutz und Kosten punktet, wo ChatGPT und Claude die Nase vorn haben. Entscheidungsmatrix und reale Preisberechnun
DeepSeek V4 Pro — 1,6 Billionen Parameter, MIT-Lizenz, 3,48 $/M Output vs. 25 $/M bei Claude Opus 4.7. Wir analysieren die Architektur, reale Benchmarks, wo Pro gewinnt u
DeepSeek-Chat und DeepSeek-Reasoner werden am 24. Juli 2026 eingestellt. Risikomatrix, Migrationszeitplan und eine 15-minütige Checkliste für technische Manager.
У лютому 2026 за 48 годин зникло $285 мільярдів з капіталізації технологічних компаній. Не через рецесію. Не через провальну звітність. Через одне питання, яке інвестори поставили собі одночасно: якщо AI-агент робить роботу десяти людей — навіщо платити за десять місць у...
Detaillierter Vergleich von GPT-5.5 und GPT-5.4: Benchmarks, tatsächliche Migrationskosten und Checkliste – wann sich ein Wechsel lohnt und wann GPT-5.4 noch ausreicht.
DeepSeek V4 Flash — 284B MoE, 1M Kontext, $0.14/M Tokens. Vollständiger Überblick über Architektur, Benchmarks und Bereitstellung über Ollama Cloud und DeepSeek API. Aus
Claude Opus 4.7 in meiner RAG-System AskYourDocs mit 400 juristischen PDFs getestet. Vergleich mit Llama 3.3 70B – wer gewinnt, was kostet es, wann ist es die richtige Wa
Claude Opus 4.7 erschien am 16. April 2026. SWE-bench Pro 64,3 %, Vision 3,75 MP, Preis 5 $/25 $. Ich untersuche, was neu ist, Breaking Changes und praktische Erfahrungen
Die Wahrheit über Gemma 4 26B MoE, die in Werbeübersichten nicht erwähnt wird. Swapping auf Mac 24 GB, 2 Tokens/Sek., Flash Attention Bugs.
Was ist der Thinking Mode in Gemma 4, wie funktioniert er über Ollama, wie kann man ihn mit /no_think verkürzen oder deaktivieren. Echte Tests auf M1 16 GB
Was ist Gemma 4, welche Modellgrößen gibt es, die Apache 2.0 Lizenz, ein Vergleich mit Gemma 3 nach Benchmarks und wie man es über Ollama startet. Vollständiger Überblick
Teste Gemma 4 über Ollama auf MacBook Pro M1 16 GB. Vergleich mit Qwen3:8b und Mistral Nemo bei realen Aufgaben: Generierung von Spring Boot Code und Text. Ehrliche Bewer
tool_choice auto vs required, Description als Prompt, Halluzination durch Konfidenz — wie LLMs entscheiden zu suchen und wie man es steuert. Java + Spring AI mit Code.
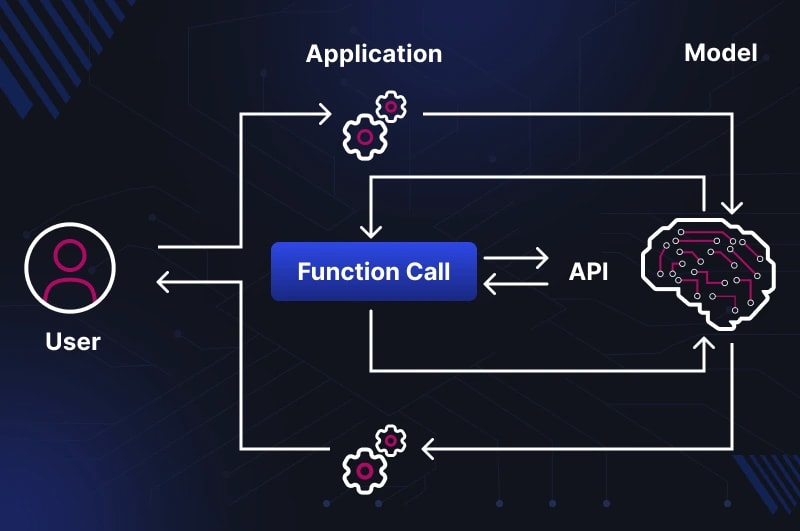
LLMs führen keine Funktionen aus – sie beschreiben sie in JSON. Wir analysieren tool_choice, den vollständigen Aufrufzyklus, den Unterschied zwischen RAG-Pipeline und Too
Wie ChatGPT, Claude und Gemini wirklich trainiert werden: Pre-Training, SFT, RLHF, DPO, RLVR. Reale Kosten, Skalierungsgesetze und die neue Ära der synthetischen Daten 20
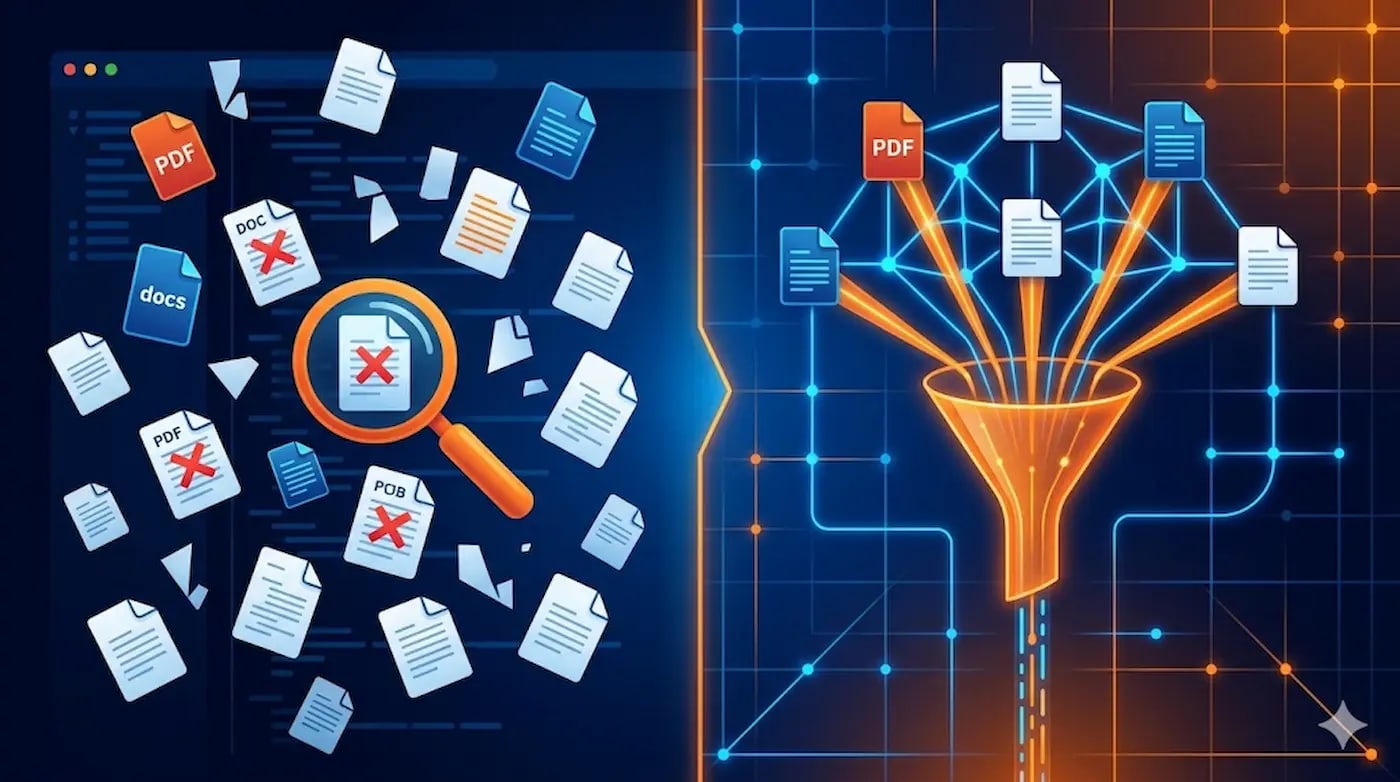
Wie ich BM25 zur Vektorsuche in einem produktiven RAG-Dienst auf pgvector hinzugefügt habe. Migration, RRF, kundenspezifische Konfiguration – mit Code und Fallstricken.