Kurz gesagt: LM Studio empfiehlt offiziell mindestens 16 GB RAM — 8 GB liegen unterhalb des Grenzwerts. Lokale KI auf einem solchen Mac ist jedoch durchaus machbar. Dank des Qualitätssprungs kleiner Modelle bieten bereits mehrere Modelle der 3–4B-Klasse ein komfortables Erlebnis auf 8 GB: Phi-4-mini, Gemma 3 4B, Qwen3 4B, Llama 3.2 3B und das vollständig offene SmolLM3-3B. Wir schauen uns ehrlich an: Was funktioniert wirklich, wie viel Speicherplatz benötigt es und was sollte man besser gar nicht erst versuchen.
📉 Die Realität von 8 GB auf Apple Silicon: Warum es weniger ist, als es scheint
Das Erste, was du verstehen solltest, bevor du überhaupt LM Studio auf einem Mac mit 8 GB herunterlädst, ist, dass diese Zahl nicht das bedeutet, was du denkst.
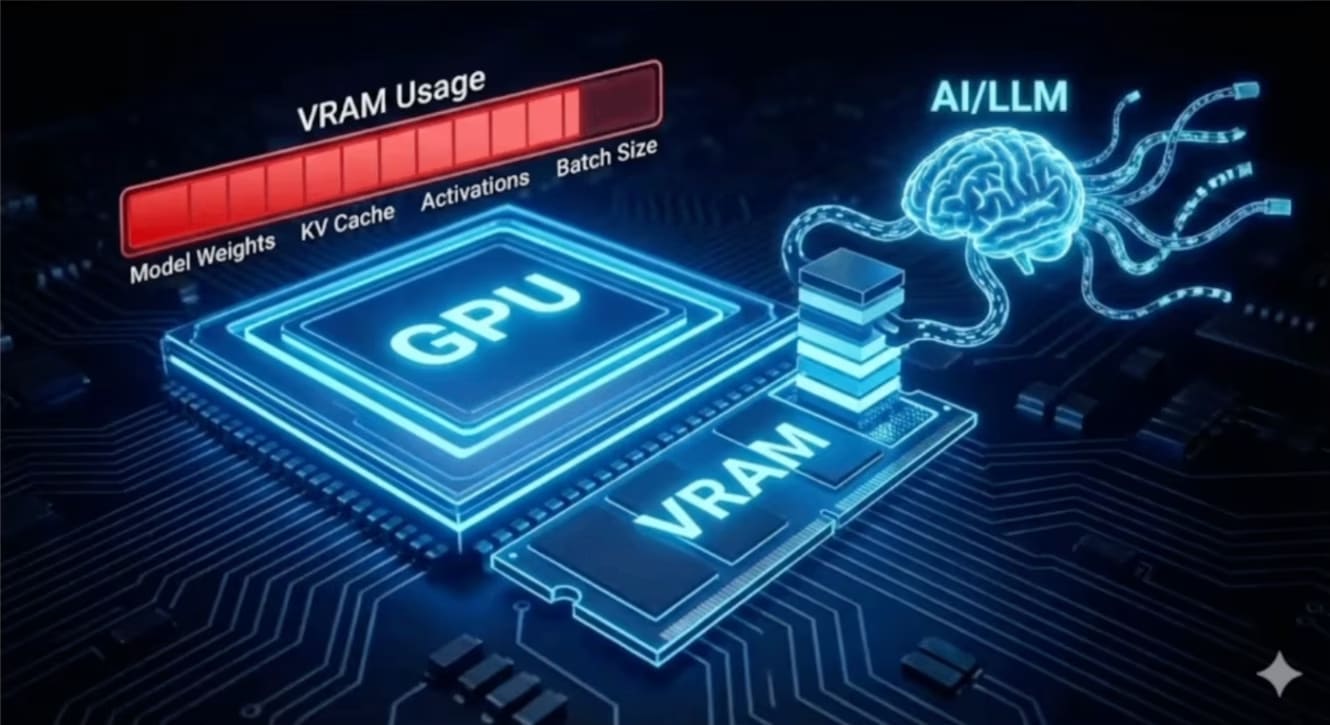
Auf Apple Silicon gibt es Unified Memory — CPU und GPU teilen sich denselben physischen Speicher anstelle separater Pools wie bei einem klassischen PC mit diskreter Grafikkarte. Das ist tatsächlich ein Vorteil für KI-Workloads (kein Overhead durch das Kopieren von Daten zwischen CPU- und GPU-Speicher), bedeutet aber, dass deine 8 GB gleichzeitig abdecken müssen: macOS und Hintergrundprozesse, geöffnete Anwendungen (ein Browser mit mehreren Tabs kann leicht 1-2 GB verbrauchen) und das Modell selbst plus sein Kontext.
In der Praxis stehen für das Modell tatsächlich nur etwa 4-6 GB zur Verfügung, nicht die vollen 8 GB. Das ist die Zahl, die du im Hinterkopf behalten solltest, wenn du ein Modell auswählst, und nicht die Nennkapazität des Speichers deines Macs. Unter Windows oder Linux gilt die gleiche Logik — das System beansprucht seine 2-3 GB, sodass für das Modell ungefähr die gleiche Menge übrig bleibt.
⚠️ Was LM Studio offiziell zu 16 GB sagt
Hier muss man gleich ehrlich sein: Die offizielle Seite mit den Systemanforderungen von LM Studio besagt eindeutig — "LLMs can consume a lot of RAM. At least 16GB of RAM is recommended". 8 GB liegen unterhalb des empfohlenen Grenzwerts, nicht unterhalb der grundlegenden Komfortkonfiguration.
Das bedeutet nicht, dass ein 8-GB-Mac unbrauchbar ist — es bedeutet, dass du bewusst kleine Modelle auswählen und nicht das gleiche Erlebnis wie mit 16 GB oder 32 GB erwarten musst. LM Studio selbst hilft bei dieser Auswahl: Im Modell-Browser wird jede Datei von einem farbigen Hardware-Fit-Indikator begleitet — Grün bedeutet, dass das Modell bequem auf deine Hardware passt, Gelb bedeutet, dass es funktioniert, aber knapp wird, Rot bedeutet, dass ein Teil der Schichten in den Systemspeicher ausgelagert werden muss (und eine entsprechende Geschwindigkeitsreduzierung). Mit 8 GB solltest du dich daran gewöhnen, diesen Indikator vor jedem Download zu beachten und dich nicht auf den Modellnamen zu verlassen.
⚡ Schnelle Auswahl: 5 Modelle für 8 GB
Modell
Parameter
Größe (Q4)*
Lizenz
Wann verwenden
Phi-4-mini ⭐
3.8B
~2.5 GB
MIT
Logik, Code, schnelle Antworten. Der intelligente Standard, wenn du nicht weißt, wo du anfangen sollst
Vollständige Offenheit (Gewichte + Daten) und langer Kontext
Empfehlung: Du weißt nicht, wo du anfangen sollst — nimm Phi-4-mini. Für Textarbeit — Gemma 3 4B, für Agenten und Tool Calling — Qwen3 4B. Alle fünf laufen komfortabel auf 8 GB in 4-bit.
* Die Dateigröße hängt vom Quant und dem Ersteller des Builds ab (Bartowski, Unsloth, offizielle Releases) — prüfe das am Tag des Downloads auf Hugging Face. Die Zahlen hier sind eine Größenordnung. Die Geschwindigkeit (tok/s) misst du am zuverlässigsten selbst in LM Studio.
🧩 MLX oder GGUF auf 8 GB — kurz zur Quantisierung
Bei 8 GB ist die Wahl des Formats und des Quantisierungsgrads keine Frage der Bequemlichkeit mehr, sondern eine Frage, ob das Modell überhaupt geladen wird. Hier wiederhole ich die Theorie nicht — ich habe bereits eine detaillierte Analyse der GGUF-Quantisierung für Ollama, was die Suffixe Q4_K_M, Q8_0, IQ4_XS bedeuten, warum Q4 oft besser als Q8 ist (nicht nur wegen der Größe, sondern auch wegen der Geschwindigkeit) und eine Formel zur Berechnung des benötigten RAMs für jedes Modell. Die Prinzipien sind identisch für LM Studio — das Dateiformat (GGUF) ist dasselbe, nur die Engine, die es ausführt, ist anders.
Kurz für den Kontext von 8 GB: Bei dieser Speichermenge arbeitest du praktisch immer mit 4-Bit-Quantisierung (Q4_K_M für GGUF oder einfach "4bit" für MLX-Builds — die Bezeichnungen sind etwas anders, die Essenz ist dieselbe). Alles darüber hinaus — Q6, Q8 — lässt bei 8 GB keinen Platz mehr für Kontext oder das System. Faustregel: Für das Modell benötigst du etwa das 1,2-fache des RAMs, das die Datei wiegt — also für 4-5 GB Puffer halte die Datei bis zu ~4,5 GB.
Eine wichtige Warnung zu den Zahlen. Ein Modell mit demselben Namen in verschiedenen Builds (Bartowski, Unsloth, offizielle Releases) kann je nach Quant unterschiedlich viel wiegen. Orientiere dich also nicht an einer Zahl aus einer fremden Tabelle, sondern an der tatsächlichen Dateigröße und dem Hardware-Fit-Indikator auf der Modellseite in LM Studio oder auf Hugging Face. Alle Modellgewichte in diesem Artikel sind eine Größenordnung; überprüfe sie direkt am Tag des Downloads, da ständig neue Builds und Quants erscheinen.
🥇 Phi-4-mini 3.8B — der intelligente Standard
Wenn du 8 GB hast und ein Modell benötigst, mit dem du wirklich bequem täglich arbeiten kannst und das nicht nur "technisch läuft" — beginne mit Phi-4-mini. Dies ist ein Mini-Modell von Microsoft (MIT-Lizenz), das ein hervorragendes Verhältnis von "Intelligenz pro Parameter" in der 3-4B-Klasse bietet: stark in Logik, Mathematik und Code für seine Größe.
Unabhängige Tests zeigen etwa 15-20 Tokens pro Sekunde auf Hardware der Stufe M1 MacBook Air — das reicht für Code-Vervollständigung, einfache Erklärungen und leichtes Chatten ohne spürbare Verzögerungen. Die genaue Geschwindigkeit hängt jedoch von deinem Mac, dem Quant und der Kontextlänge ab, daher ist es am zuverlässigsten, sie direkt in LM Studio zu messen — der tok/s-Zähler wird unter jeder Antwort angezeigt. Nimm keine fremde Zahl als deine eigene.
Was du nicht erwarten solltest — tiefgreifendes mehrstufiges Reasoning oder komplexe Agentenketten: dafür benötigst du Modelle von deutlich größerer Größe, die auf 8 GB einfach nicht mit akzeptabler Geschwindigkeit passen.
In LM Studio auf Apple Silicon suche nach der Version mit der Bezeichnung 4bit MLX im Namen — die MLX-Engine von Apple ist auf derselben Hardware normalerweise merklich schneller als GGUF. Unter Windows/Linux nimm die normale GGUF-Variante (Q4_K_M).
🤖 Gemma 3 4B — Text, Kontext und Mehrsprachigkeit
Wenn Phi-4-mini auf Logik und Code setzt, dann ist Gemma 3 4B von Google auf Textarbeit spezialisiert: Schreiben, Paraphrasieren, Zusammenfassen, Übersetzen und ein solides Verständnis von Kontext. Für seine Größe schlägt sich das Modell überraschend gut – die Community für lokale KI bemerkt regelmäßig, dass Gemma 3 4B bei vielen Textaufgaben wie ein doppelt so großes Modell wirkt.
In 4-Bit-Quantisierung wiegt es etwa 2,5–3 GB (prüfe das genaue Gewicht der spezifischen Version auf Hugging Face – siehe obenstehenden Hinweis), sodass genügend Spielraum für den Kontext bleibt, selbst bei 8 GB. Es gibt auch ein kleineres Gemma 3 1B (~1 GB), aber das ist eher für sehr schwache Hardware – bei 8 GB nutzt du deine Möglichkeiten nicht aus, nimm lieber das 4B.
Wenn du dich zwischen Phi-4-mini und Gemma 3 4B entscheiden musst, gibt es kein einfaches "eines ist besser als das andere". Phi ist stärker in Logik und Code, Gemma in Text und Mehrsprachigkeit. Beide sind in wenigen Minuten heruntergeladen, daher ist der schnellste Weg, es herauszufinden, deine typischen Anfragen auf beiden zu testen.
🔧 Qwen3 4B — Bester Tool-Calling in seiner Klasse
Die Qwen-Familie von Alibaba (Apache 2.0 Lizenz) ist eine würdige Alternative, wenn du stärkeres Tool-Calling oder einen etwas anderen Antwortstil als bei Phi oder Gemma benötigst. Für lokale Agenten und Szenarien mit Funktionsaufrufen ist dies oft die beste Wahl in der 3-4B-Klasse.
Konzentriere dich auf Qwen3 4B: In 4-Bit wiegt es etwa 2,5 GB und passt gut auf 8 GB. Es gibt auch ein größeres Qwen3 8B, aber auf 8 GB RAM läuft es knapp (in Q4 sind das schon ~4,7–5 GB Dateigröße plus Kontext und System) – also nur mit kurzem Kontext und ohne Hintergrundanwendungen. Und das Wichtigste: Lass dich nicht von der Idee verführen, das 8B in Q2 oder Q3 zu nehmen, damit es "passt". Die Regel aus dem Artikel über Quantisierung gilt hier direkt: Ein kleineres Modell in Q4 ist fast immer besser als ein größeres in Q2.
Neuere Qwen-Linien erscheinen ständig, und für neu veröffentlichte kleine Modelle gibt es noch wenig unabhängige Messungen der Geschwindigkeit auf schwacher Hardware – schaue daher vor dem Download auf den Hardware-Fit-Indikator in LM Studio und nicht auf allgemeine Zahlen aus dem Internet.
🦙 Llama 3.2 3B — Basis und überall unterstützt
Llama 3.2 3B von Meta ist das Modell, an dem sich alle anderen orientieren. Kein Spitzenreiter in Sachen Qualität, aber am weitesten verbreitet: Jede Engine, jede Agentenbibliothek, jeder Online-Guide funktioniert fast garantiert sofort damit.
In 4-Bit wiegt es etwa 2 GB, fliegt also selbst auf 8 GB mit viel Spielraum. Seine Stärke ist die geringe Latenz: Wo die Antwortgeschwindigkeit wichtiger ist als Spitzenwerte in Benchmarks (interaktiver Chat, Code-Vervollständigung, Streaming-Szenarien), ist es sehr nützlich. Wenn du nicht weißt, wo du anfangen sollst, oder eine zuverlässige "ausfallsichere" Option brauchst – das ist sie.
🔓 SmolLM3-3B — Vollständig Open Source, 128K Kontext
SmolLM3-3B von Hugging Face ist ein Sonderfall. Es ist ein vollständig Open-Source-Modell: nicht nur die Gewichte, sondern auch die Daten und das Trainingsrezept. Für Entwickler, denen Transparenz und Reproduzierbarkeit wichtig sind, ist das eine Seltenheit.
Bei einer Größe von etwa 2 GB in 4-Bit konkurriert es selbstbewusst mit Modellen der 3B-Klasse und reicht an 4B heran, und sein Hauptmerkmal ist ein Kontext von bis zu 128K Tokens, der bewusst durch mehrstufige Erweiterung trainiert wurde und nicht nachträglich angefügt wurde. Auf 8 GB wirst du natürlich keine 128K einstellen können (der Speicher für den KV-Cache lässt das nicht zu), aber selbst bei realistischen 4–8K behält es die Kohärenz langer Antworten besser bei als viele seiner Altersgenossen. Die ideale Option, wenn dein Prinzip lautet: "Keine Blackboxes, alles ist überprüfbar".
Für 8 GB RAM beginne mit Phi-4-mini, Gemma 3 4B, Qwen3 4B, Llama 3.2 3B oder SmolLM3-3B in 4-Bit-Quantisierung. Wenn LM Studio einen grünen oder gelben Hardware-Fit-Indikator anzeigt, ist das Modell mit ziemlicher Sicherheit für den täglichen Gebrauch geeignet.
🤔 Warum KI-Prompts manchmal übertreiben
Wenn du nach etwas wie "welches Modell für LM Studio auf 8GB" gegoogelt hast, hast du wahrscheinlich eine automatische KI-Antwort gesehen, die unter anderem etwas wie "Llama 3 8B mit Q2_K-Quantisierung" empfiehlt. Hier solltest du innehalten und erklären, warum das eine schlechte Empfehlung ist, auch wenn das Modell technisch geladen wird.
Erstens, ein 8B-Modell auf 8 GB realem Speicher ist fast immer knapp oder am Limit des Komfortablen, da das System bereits 2-4 GB benötigt. Zweitens, und das ist das Wichtigste: Q2_K ist eine so aggressive Quantisierung, dass die Qualität ungleichmäßig abnimmt. Das Modell kann Sätze kohärent formulieren, aber "verliert die Logik" mitten in einer längeren Antwort. Warum das so ist und wo genau die Grenze des Akzeptablen bei der Quantisierung liegt, habe ich in meinem Artikel über GGUF-Quantisierung behandelt: Die kurze Regel daraus – nimm lieber ein kleineres Modell in Q4 als ein größeres in Q2.
KI-Übersichten in der Suche erledigen allgemeine Anweisungen gut (wie Metal aktivieren, Kontext begrenzen), aber wenn es um spezifische Modell-Empfehlungen geht – solltest du diese Ratschläge durch unabhängige Quellen oder eigene praktische Erfahrungen überprüfen und nicht blind die erstbeste automatisch generierte Liste befolgen.
Echte Geschwindigkeitszahlen – Was bestätigt ist und was nicht
Hier muss ich ehrlich sein, genau wie im Abschnitt über KI-Prompts: Ich werde keine Tabelle mit genauen Tokens/Sekunde für jedes dieser Modelle auf 8-GB-Hardware erstellen – solche direkten unabhängigen Messungen auf 8-GB-Macs habe ich nicht gefunden, und Zahlen zu erfinden würde genau diese Ehrlichkeit verletzen, zu der dieser Artikel aufruft.
Die einzige saubere unabhängige Messung, die ich für diese Geräteklasse gefunden habe – Phi-4-mini auf dem Niveau von ~15–20 Tokens/Sekunde auf einem M1 MacBook Air (unabhängiger Test lokaler Modelle 2026). Für die restlichen Modelle gibt es noch wenige korrekte Messungen speziell auf 8 GB im öffentlichen Bereich – teilweise, weil kleine Modelle schneller aktualisiert werden, als Benchmarks gesammelt werden können.
Qualitativ lässt sich eines sagen: Apple Silicon mit Unified Memory und Metal-Beschleunigung ist für diese Klasse von Aufgaben systemisch schneller als reine CPU-x86-Laptops (wie ein Ryzen 5600U ohne dedizierte Grafikkarte). Aber die genaue Zahl, "wie viele Tokens/Sekunde dein Ryzen 5600U mit Phi-4-mini liefert", werde ich nicht angeben, denn die ehrliche Antwort ist – "diese Messung habe ich nicht gefunden", und keine erfundene Zahl, die plausibel klingt.
Wenn du eine genaue Zahl für deine Hardware willst – das dauert buchstäblich zwei Minuten: Lade das Modell in LM Studio, öffne den Chat und schaue auf den Tokens/Sekunde-Zähler, der während der Generierung erscheint. Das gibt dir einen viel genaueren Anhaltspunkt als jede Tabelle im Artikel, da es deine spezifische Konfiguration berücksichtigt – Betriebssystemversion, Hintergrundprozesse, aktuelle Auslastung.
🚫 Was du NICHT auf 8 GB ausführen solltest
Jedes 7B+ Modell in voller Form – selbst in 4-Bit-Quantisierung wird ein 7-8B-Modell mit Kontext und Systemanforderungen dich praktisch garantiert über die verfügbaren 4-6 GB hinausdrängen (Qwen3 8B ist die absolut äußerste Ausnahme, und das nur mit kurzem Kontext)
Gemma 3 27B und andere Modelle im Bereich 20-30B+ – das ist für 24-32 GB+ Konfigurationen, auf 8 GB solltest du nicht einmal darüber nachdenken, unabhängig von der Quantisierung
Jedes Modell ohne Überprüfung des Hardware-Fit-Indikators – wenn du einen gelben oder roten Indikator in LM Studio siehst, ist das ein Signal, dass die Erfahrung instabil sein wird, auch wenn es technisch startet
Q8 oder Q6 Quantisierung selbst für kleine Modelle – auf 8 GB gibt es keinen Spielraum für den Luxus höherer Genauigkeit, bleibe bei 4-Bit
Mehrere gleichzeitig geladene Modelle – die Funktion "mehrere Modelle laden" von LM Studio ist großartig auf Hardware mit viel Speicher, aber auf 8 GB führt sie schnell zum Swapping
⚙️ Praktisches Setup in LM Studio
Ein paar spezifische Einstellungen, die du auf einem 8GB Mac sofort über die LM Studio-Oberfläche vornehmen solltest:
Hardware Settings → Metal — Stelle sicher, dass die Hardwarebeschleunigung über Metal aktiviert ist. Das ist auf Apple Silicon fast immer der Standard, aber es lohnt sich, im rechten Sidebar des Programms nachzusehen. (Unter Windows/Linux übernimmt CUDA oder Vulkan-Offload die Rolle von Metal — überprüfe, ob LM Studio deine Grafikkarte erkennt.)
GPU Offload — Schiebe den Regler auf die maximal verfügbaren Kerne. Auf einer Unified Memory-Architektur "klaut" das keinen separaten Speicher — CPU und GPU teilen sich denselben Pool, daher gibt es keinen Grund, das Offloading künstlich zu begrenzen.
Context Size — Beschränke auf 2048-4096 Tokens — Das ist die wichtigste praktische Einstellung auf 8GB. Jeder Kontext-Token belegt Speicher für den KV-Cache, und bei begrenztem Speicher kann ein langer Kontext (8K, 16K) dazu führen, dass die Anwendung abstürzt, weil der Speicher knapp wird, noch bevor das Modell eine Antwort generieren kann.
Lade nur ein Modell gleichzeitig — Versuche nicht, auf einem 8GB Mac gleichzeitig ein "schnelles" und ein "intelligentes" Modell geladen zu halten, wie du es auf einem 16GB+ System tun könntest.
Wenn das Modell nach diesen Einstellungen immer noch instabil ist oder die Generierung bei längeren Antworten spürbar langsamer wird, ist das ein Signal, dass du entweder den Kontext weiter verkürzen oder zu einem kleineren Modell wechseln solltest.
✅ Ehrliches Fazit: 8GB sind das Minimum, 16GB sind komfortabel
Kurz gesagt: Ein 8GB Apple Silicon Mac kann technisch LM Studio ausführen und nützliche Ergebnisse liefern — jedes der fünf oben genannten Modelle (Phi-4-mini, Gemma 3 4B, Qwen3 4B, Llama 3.2 3B, SmolLM3-3B) deckt reale alltägliche Aufgaben wie einfaches Chatten, Erklärungen oder leichte Code-Vervollständigung ab. Das ist kein Spielzeug und keine Zeitverschwendung.
Aber es ist auch nicht das Erlebnis, das Marketing-Screenshots mit leistungsstarken 14B-32B Modellen versprechen. Du wählst bewusst einen Kompromiss: kleinere Modellgröße, begrenzter Kontext und der Verzicht auf komplexere Aufgaben wie tiefes Reasoning, die Arbeit mit großen Dokumenten oder Multi-Agenten-Szenarien über MCP, wo der Kontext schnell anwächst.
Wenn lokales KI für dich zu einem regelmäßigen Arbeitswerkzeug wird und nicht nur zu einem einmaligen Experiment — ein Upgrade auf 16GB bietet eine viel breitere Auswahl: Qwen3 8B läuft komfortabel, und 12-14B Modelle (Gemma 3 12B, Qwen3 14B) werden realistisch — genau die Klasse, bei der sich lokales KI nicht mehr wie ein Kompromiss anfühlt. Und das Upgrade beseitigt die ständige Sorge "ob es reinpasst". Für diejenigen, die bereits 16GB haben — ich habe einen Einführungsartikel über LM Studio und warum lokales KI im Jahr 2026 kein Kompromiss mehr ist, mit dem du anfangen solltest, wenn du generell neu in diesem Thema bist.